1.3 技术架构深度解析
1.3 技术架构深度解析
本节摘要:Agno 的"轻"不是偶然,而是架构设计的结果。本节拆解它的六层架构——智能体核心、模型抽象层、工具系统、内存管理、知识检索、智能体编排——并跟踪一条请求从进入框架到返回结果的完整数据流,让你从"会用"升级到"知道它为什么快"。
你能学到什么
阅读完本节,你应当能够:
- 说出 Agno 架构的六个核心组件及其职责
- 解释模型抽象层如何支撑"模型无关性"
- 画出一次完整请求的数据流
- 理解工具系统与知识检索在架构中的位置
- 用架构知识解释 Agno 为什么"轻"
一、问题与直觉
用框架的人可以只学 API,但想用好一个框架,得知道它内部怎么组织。Agno 的结构不复杂——六个组件各管一摊,像一条装配线:智能体核心负责发号施令,模型抽象层负责对接各家模型,工具系统提供行动能力,内存管理保存状态,知识检索接入外部资料,智能体编排协调多智能体。看清这条装配线,很多"为什么"就自然有了答案。
二、核心原理
2.1 六层架构总览
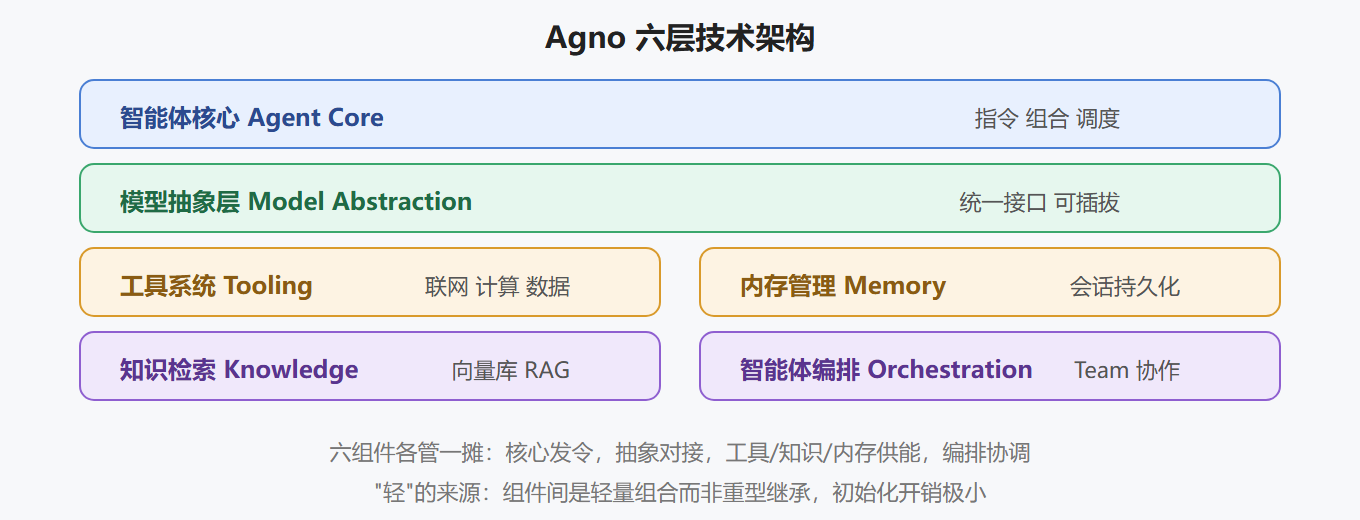
2.2 六个组件的职责
| 组件 | 职责 | 支撑的能力 |
|---|---|---|
| 智能体核心 | 组合模型与能力,对外交互 | Agent 主体 |
| 模型抽象层 | 统一各家模型接口 | 模型无关性 |
| 工具系统 | 提供外部行动能力 | Tool 扩展 |
| 内存管理 | 持久化会话与状态 | 跨会话记忆 |
| 知识检索 | 向量检索外部知识 | RAG |
| 智能体编排 | 协调多智能体协作 | Team |
💡 关键直觉:"轻"的核心在组件间的关系——Agno 用轻量组合而不是重型继承来组织这些组件。创建智能体时不必初始化庞大的继承链,所以能快到微秒级。
2.3 模型抽象层如何支撑模型无关性
模型抽象层把"模型调用"封装成统一接口:不论底层是 OpenAI、Claude 还是开源模型,上层看到的都是同一个调用方式。切换模型时只改配置,不改业务代码。这一层是"模型无关"承诺的工程实现——它挡在业务代码与具体模型之间,把差异消化在内部。
三、工程实践要点
3.1 一次请求的完整数据流
一条请求的典型路径:核心组件收到输入 → 带上记忆与检索到的知识 → 交给模型生成 → 需要工具就调用工具再回模型 → 生成回复 → 写入记忆 → 返回。每个组件在流程里各司其职,这也是"装配线"式架构的体现。
3.2 从架构看性能瓶颈
理解架构后,性能优化就有了方向:
| 环节 | 潜在瓶颈 | 优化方向 |
|---|---|---|
| 模型调用 | 延迟大头 | 换更快模型、缓存 |
| 知识检索 | 向量库查询慢 | 索引优化、分片 |
| 工具调用 | 外部服务慢 | 并行、超时控制 |
| 内存读写 | 频繁持久化 | 批量写入 |
⚠️ 常见坑:Agno 本身创建很快,但一次完整请求的延迟几乎全在模型与外部服务上。优化时先量各部分耗时,别把时间花在框架本身——它通常不是瓶颈。
3.3 架构取舍的代价
"轻"不是免费的。Agno 用约定优于配置换速度,代价是:复杂状态机与精细流程控制能力弱于重型框架;高度定制时需要绕过框架默认行为。选型时这是明确的权衡——要快就接受约定,要控制就接受重量。
四、六大组件逐个过
原始文档把架构拆成六个核心组件,逐个看职责与协作方式:
| 组件 | 职责 | 关键点 |
|---|---|---|
| Agent Core | 智能体本体,持有模型、工具、知识的引用 | 薄对象,创建即返回 |
| Model Abstraction | 屏蔽各供应商差异的模型抽象层 | 换模型只改一个参数 |
| Tooling | 工具注册与调用协议 | 智能体按需自主调用 |
| Memory | 会话与持久化状态管理 | 后台自动写入数据库 |
| Knowledge Retrieval | 知识源向量化与检索 | ingest 一次,检索多次 |
| Orchestration | 多智能体编排 | 团队分工与结果整合 |
其中 Model Abstraction 是"模型无关"的落点:框架为每家供应商做一个适配类,Agent 只认统一接口。Orchestration 则是 Team 的实现基础:队长智能体接收任务,决定派给谁、按什么顺序、结果怎么合并。
五、一次带知识库请求的完整数据流
用原始文档的四步流程走一遍数据在架构里的旅程:
[准备阶段,一次性] 配置 Vector Store(如 LanceDb) 配置 Source(如 PdfSource) ── ingest ──▶ 切块/向量化 ──▶ 存入向量库 [请求阶段,每次] 用户提问 ──▶ Agent Core │ 取回会话历史(Memory) │ 问题向量化,到向量库检索相关片段(Knowledge Retrieval) │ 组装:系统指令 + 检索片段 + 历史 + 问题 ▼ Model Abstraction ──▶ 模型服务(可带工具调用轮次) ▼ 回答用户 ──▶ 本轮问答写回 Memory
注意"准备阶段"与"请求阶段"的分离:ingest 只在首次建库或知识更新时执行,日常请求只做检索。很多初学者每轮都重新导入文档,白白浪费几分钟——这是第 2 章 2.4 节会再强调的坑。
六、架构层面的性能观
"轻"不是口号,能在架构里指出具体出处:
- 无图引擎:Agno 不为每个智能体搭状态机运行时,编排逻辑在需要时才引入
- 惰性组合:工具、知识库作为引用挂载,实例化时不做重活
- 集中式抽象:模型、向量库、嵌入模型的适配层统一,避免每个智能体各建一套
⚠️ 常见坑:架构轻不等于可以无视资源占用。知识库的向量检索、记忆的数据库读写、工具的网络调用,这些才是生产环境的主要开销来源。优化时先看这三处,别盯着对象创建时间。
六之前补:横向对比加深理解
把 Agno 的分层和传统 LangChain 系应用摆在一起,差异立刻可见。LangChain 系的典型应用里,链、记忆、检索、工具往往各自引入一套抽象,拼起来后概念数量翻倍;Agno 把这些收敛为 Agent 上的少量参数,架构层数更少,每层职责更满。代价是灵活性:Agno 假设你接受它的约定,想绕开约定做深度定制时,能拧的螺丝比老框架少。
另一个值得注意的分层决策是嵌入模型的归属。向量化既被知识库用(文档切块入库),也被检索用(问题向量化),Agno 把它作为独立可配置组件,而不是绑死在某家供应商上。这意味着你可以文档入库用本地嵌入模型省成本,问答检索换高质量模型,两边独立演进。
从工程演进的角度看,这套架构本质上是"把智能体当普通 Python 对象"的立场宣言:对象创建要快、依赖要显式、状态外置到数据库。凡是认同这个立场的团队,读它的代码会非常顺;习惯框架接管一切的开发者,则需要适应"很多事要自己管"的自由度。
架构的部署视角
分层图之外,再从部署视角看一次这套架构,能回答"上生产要准备什么"。智能体对象本身无状态且创建极轻,天然适合跑在无服务器或容器化环境里,实例随时扩缩。真正的有状态资产有三个:向量库(知识库的载体)、记忆数据库(会话历史的载体)、以及模型服务端点(智力的来源)。生产的可用性设计就围绕这三样做——向量库与记忆库做持久化与备份,模型端点做超时重试与多供应商降级。
这个视角也解释了为什么 Agno 敢把对象做得那么薄:状态全部外置后,智能体实例成了"纯函数式"的存在,带着配置进、产出回答出,挂了就重建,没有恢复负担。传统框架里检查点、会话状态与对象纠缠在一起的设计,在容器编排时代反而是运维包袱。
监控埋点的位置也由架构决定:模型抽象层记录每次推理的耗时与 token 用量,工具层记录调用成败与延迟,检索层记录命中质量。三处埋点齐了,一个"智能体为什么慢、为什么贵、为什么答错"的问题就能定位到层。
七、常见问题
Agno 支持哪些向量数据库?
原始示例默认用 LanceDb(本地文件型,零部署)。框架对主流向量库都有适配层,选择依据是数据规模与部署条件:原型用本地库,生产按现有基础设施选。这属于 Model Abstraction 同款"可插拔"设计。
架构图里的组件都要我自己配吗?
不用。最小配置只有一个模型参数,其余组件按需挂载——不配 Memory 就没有持久化,不配 Knowledge 就不做检索。架构图是全景,不是每次的施工清单。
这套架构能跑在无服务器环境里吗?
可以。薄对象 + 无重型运行时的特点对函数计算环境友好,冷启动负担小。配合持久化记忆放数据库、知识库放托管向量服务,就是一套典型的无服务器智能体后端。
一个对照:同一需求在两种架构里的样子
架构理解最快的途径是对比。设想需求:"用户提问,智能体查公司文档再回答"。在重型框架里,典型实现要先定义检索工具、再组装链、配置记忆组件、处理各组件间的数据转换格式,概念数量五六个,文件两三个。在 Agno 里,实现是:向量库对象一个、智能体一个、把前者作为参数传给后者,结束。功能一模一样,认知负担差一个量级。
差距在"胶水层"。重型框架的胶水(链、装配器、转换器)本身成了学习对象;Agno 的胶水是普通 Python 语法——列表、参数、对象组合,你早就会了。这就是"轻"的本质:不是功能少,而是把框架特有概念压缩到最少,剩下的全用语言本身表达。代价同样存在:框架不提供强约束时,代码质量全靠工程纪律兜底,这也是本教程反复强调测试与评估的原因——自由与责任永远成对出现。
架构自检三问
读完架构,用三个问题自测理解深度。第一问:为什么 Agno 敢把状态全部外置?因为智能体对象的行为完全由配置与外部数据决定,对象本身无状态可丢。第二问:换一家模型供应商,架构里哪一层受影响?只有模型抽象层以下的适配实现,其余原封不动——这正是分层的意义。第三问:如果要给系统加一道"敏感词过滤",应该加在哪?答案不唯一,但加在模型抽象层之前(请求出口处)最经济,说明你已经会用分层思维放置横切逻辑了。三问都能不假思索作答,本章的目标就达成了。
核心回顾
- 要点一:六组件——核心、抽象层、工具、内存、知识、编排,各管一摊
- 要点二:模型抽象层是"模型无关"的工程实现,挡在业务与模型之间
- 要点三:请求数据流——记忆 → 检索 → 模型 → 工具 → 回复 → 写记忆
- 要点四:"轻"来自轻量组合而非重型继承
- 要点五:性能瓶颈通常在模型与外部服务,不在框架本身
- 要点六:约定优于配置换速度,复杂控制需权衡
架构看清了,第 2 章开始动手——从装环境、配密钥,到跑起第一个真正会干活的智能体。