2.2 创建基本智能体
2.2 创建基本智能体
本节摘要:基本智能体 = 模型 + 人设 + 输出规矩。本节从最简智能体写起,逐步加名字、描述、系统提示词与结构化输出,让智能体从"泛泛而谈"变成"按你的岗位要求办事"。理解这几个参数,就掌握了 Agent 对象的核心。
核心问题
阅读完本节,你应当能够:
- 写出一个最小可用的智能体
- 用 name、description、instructions 配置智能体身份
- 理解 system prompt 的组装方式
- 用结构化输出拿到 JSON 结果
- 判断"智能体回答不对"时该调哪里
一、问题与直觉
同一个模型,有人用它答得像客服,有人答得像分析师——差别不在模型,在智能体的人设与约束。Agno 把这些人设参数暴露为 Agent 的配置项:description 告诉智能体"你是谁",instructions 告诉它"你怎么办事",结构化输出让它"按格式交活"。本节把这几个旋钮逐一讲透。
二、核心原理
2.1 Agent 对象的组成
配置 Agent 的三层结构,从身份到输出:
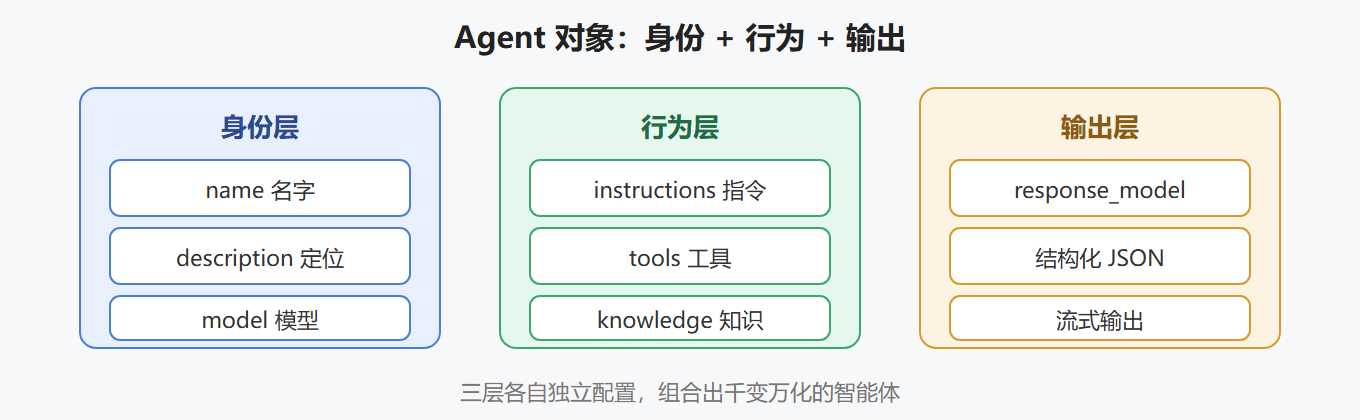
Agent 对象由三层配置组成:身份层(名字、定位、模型)、行为层(指令、工具、知识)、输出层(结构、流式)。本节先掌握身份层与基本行为层,工具与知识在后续小节展开。
2.2 system prompt 从哪来
Agno 会把 description 与 instructions 自动拼进系统提示词,与模型无关地生效:
系统提示词 ≈ 身份(description) + 行为规矩(instructions) + 框架注入的工具说明
💡 关键直觉:改智能体行为,先改 instructions,别去写死提示词。instructions 是框架层的人设,写在这里比拼字符串更规范、更易维护。
三、工程实践要点
3.1 最小智能体(Level 0)
from agno.agent import Agent agent = Agent() # 默认模型 + 默认行为 agent.print_response("1 + 1 等于几")
3.2 带身份与指令的智能体
from agno.agent import Agent agent = Agent( name="finance_analyst", description="你是资深股票分析师,擅长解读财报与估值。", instructions=[ "回答必须基于数据,给出数字依据", "不确定时明确说不知道,不编造", "结论放在回答开头", ], show_tool_calls=True, ) agent.print_response("如何评价一家公司连续三年经营现金流为负?")
name 用于日志与多智能体识别;description 定人设;instructions 是行为红线。三个参数组合,智能体就"有了性格"。
⚠️ 常见坑:instructions 写得像散文,模型难以严格执行。写成短句、编号、可检验的规则("结论放开头""不编造"),效果远好于一大段描述。
3.3 结构化输出
from agno.agent import Agent from pydantic import BaseModel class StockSummary(BaseModel): ticker: str rating: str # 买入 / 持有 / 回避 reason: str agent = Agent( name="rating_bot", response_model=StockSummary, ) result = agent.run("分析一下某科技龙头,给出评级") print(result.rating, result.reason) # 直接拿到字段
response_model 让智能体按 Pydantic 模型返回结构化对象,下游系统可直接消费,不用解析自然语言。
3.4 参数选型速查
| 参数 | 作用 | 使用建议 |
|---|---|---|
| name | 标识 | 必填,多智能体时用于区分 |
| description | 人设定位 | 一句话说清"你是谁" |
| instructions | 行为规矩 | 短句编号,可检验 |
| model | 模型选择 | 默认即可,特殊需求再换 |
| response_model | 结构化输出 | 对接系统时使用 |
| show_tool_calls | 显示工具调用 | 调试时开启 |
| markdown | 输出格式 | 展示场景开启 |
3.5 调试:回答不对调哪里
| 现象 | 优先调整 |
|---|---|
| 人设不符(答得像别人) | description |
| 行为不合规(没按规则) | instructions |
| 格式不对 | response_model |
| 知识错误 | 换更强模型或挂知识库(2.4) |
| 缺最新信息 | 挂联网工具(2.3) |
四、print_response 之外:程序化消费结果
教程示例常用打印方法展示效果,但真实应用里你需要的是"拿到数据"而不是"打印给人看"。Agno 同时提供程序化接口,返回对象上能取到回复内容、工具调用记录等字段。原始资料里对结构化输出的用法就是典型:
import json response = agent.run("用 JSON 描述这款产品:名称、价格、三个卖点") data = json.loads(response.content) # content 即回复正文 print(data["名称"])
拿到结构化结果后,入库、推送、二次加工都顺理成章。这也是"智能体从演示走向组件"的分水岭:输出能不能被程序稳定消费。
再进一步是流式输出。长回答场景下逐字返回明显改善体验,参数一开即用,其余代码不动。三种消费方式按需选择:
| 方式 | 适用场景 | 特点 |
|---|---|---|
| 打印输出 | 教程、快速验证 | 人读,程序不可用 |
| 程序化调用 | 业务集成、批处理 | 拿对象,可解析可入库 |
| 流式输出 | 聊天界面、长文生成 | 逐字返回,体验好 |
五、从 Level 0 到 Level 1 的关键一跃
原始文档用"纽约突发新闻"贯穿两级示例,值得细品其中差异。Level 0 版本直接发问,模型只能凭训练记忆回答——而训练记忆有截止日期,"突发"二字无从谈起。加上 DuckDuckGoTools 的 Level 1 版本,行为变了:模型先决定调用搜索工具,拿到结果摘要,再组织回答,还能标注来源。
这一跃的本质是智能体获得了行动能力。没有工具时它是"闭卷考试",有工具后是"开卷加查资料"。代码差异只有一行参数,思维方式却要跟着变:你要开始考虑模型会不会滥调工具、工具结果质量如何、回答是否如实引用了检索内容。
Level 0: 问题 ──▶ 模型 ──▶ 回答(凭记忆,可能过时) Level 1: 问题 ──▶ 模型 ──▶ 决定调用 Tool ──▶ 搜索结果 ──▶ 模型 ──▶ 带来源的回答
开发提示参数也建议从 Level 1 起打开:开启后每次工具调用都会显示在输出里,调试时能看清模型的决策链,出问题一眼定位是"检索错了"还是"综合错了"。
⚠️ 常见坑:指令里要求"必须搜索"不代表模型一定照做。指令是软约束,工具调用是模型的自主决策。关键业务里要把"是否真的调用了工具"当作断言去检查,不能只看最终回答像不像有来源。
指令的三层结构与调试法
基本智能体的全部灵魂在提示词配置里。把 Agno 的指令体系摊开,实际是三层:身份层(description)定义"你是谁",一句话定性;行为层(instructions)定义"怎么做",条目化列规则;约束层(散在各项指令里)定义"不能做什么",比如语言、格式、禁止事项。三层各写各的,别揉成一坨——模型对结构化指令的遵守度明显高于长段落。
写指令的次序也有讲究:先写约束层(红线先画),再写行为层(流程定好),最后润色身份层。多数人反过来先纠结身份描述,结果红线漏画,返工最多。写完通读一遍,把每条指令问一句"违反了会怎样",答不上来的指令大概率是废话,删掉降噪。
调试基本智能体的三件工具要养成肌肉记忆。第一件,开发提示开关:打开后能看到模型每一步的决策,回答不对先看它"想"的路径,而不是瞎改指令。第二件,对照实验:一次只改一处配置,同一批问题前后各跑一轮,归因才干净。第三件,最小复现:行为异常时把场景裁剪到最短——去掉工具、清掉记忆、只留一句指令,问题还在说明是模型或指令的事,问题消失说明是被裁掉的组件的事。
调试决策树 回答不对 ├─ 打开开发提示 → 工具调用路径对吗? │ ├─ 不对 → 改指令里的工具使用规则 │ └─ 对 → 继续往下 ├─ 裁剪复现 → 裸智能体还对吗? │ ├─ 不对 → 指令或模型问题 │ └─ 对 → 记忆或知识库引入的污染 └─ 固定问题集回归 → 确认修复没有打别处
六、常见问题
description 和 instructions 有什么分工?
description 是身份声明,参与系统提示组装,说明"你是谁";instructions 是行为规范,说明"你该怎么做",通常更细更长。实践建议 description 一句话定性,instructions 列条目定规则,各司其职。
每次调用都要新建智能体吗?
不必。智能体是可复用对象,同一个实例可以连续处理多轮请求;配置了持久化记忆后还能跨会话延续上下文。批量场景下也推荐复用而非每问必建,尽管创建开销已很低。
回答语言不受控制怎么办?
在指令里明确"始终使用中文回答",或把语言要求写进 description。模型偶发切换语言时,优先检查指令是否被后续长对话稀释——必要时在多轮后重申约束。
从能跑到跑得好:三个进阶习惯
第一个习惯是给智能体起正经的名字和描述。示例里随手写的"热情的突发新闻播报员"适合演示,生产里每个智能体的描述就是它的岗位说明书——写得具体,模型的行为就稳定;写得含糊,每次调用都在开盲盒。判断标准很简单:把描述拿给同事看,对方能准确说出这个智能体该干什么、不该干什么,就算合格。
第二个习惯是控制随机性。温度参数对行为一致性的影响常被低估:演示时高温度显得活泼,生产里同一问题得到三种口径的回答就是事故。涉及数据查询、格式化输出的场景,把温度压低;创作类场景再放开。没有万能默认值,但"知道要去调它"本身就是分水岭。
第三个习惯是记录版本。指令改了第三版之后,你会开始忘记哪一版效果最好——除非从第一天就给每次配置变更留档:日期、改动点、测试问题集的表现。一个纯文本的变更日志就够,它会在两周后你想回滚时救你一命。这三个习惯都不高级,但它们是把"能跑的演示"变成"可靠的工具"的全部秘密。
何时升级你的基础智能体
基础智能体跑顺后,判断"何时该加下一层能力"也有章法。三个信号值得留意:用户开始问实时性的问题("现在""今天"这类词频现),是加工具的信号;用户反复粘贴大段资料,是加知识库的信号;单轮问答变成连续任务,是配记忆的信号。让需求拉动配置,而不是预先堆满配置——每项能力都有维护成本,用不上的能力纯粹是负债。
反过来也有一个"降级"的智慧:接手别人的智能体项目时,第一件事是逐项关掉能力做减法,看哪些配置删掉后行为毫无变化。沉淀了半年的智能体配置里,常常有三分之一是历史遗留的冗余——敢于删除,才会留下真正起作用的部分。
再补充一个容易混淆的点:智能体实例与模型会话是两回事。实例是你代码里的对象,创建一次可以用到底;会话是交互的容器,装着一串消息历史。理解这对概念的分野,后面配置记忆与多会话管理时就不会犯"重建实例想清空记忆"之类的方向性错误——清会话,不是删对象。
重点提炼
- 要点一:Agent = 身份层 + 行为层 + 输出层,三层独立配置
- 要点二:description 定人设,instructions 定行为,别写死提示词
- 要点三:instructions 用短句编号规则,可检验才有效
- 要点四:response_model 让输出结构化,下游直接消费
- 要点五:行为不对改 instructions,格式不对改 response_model,知识不对挂知识库
- 要点六:show_tool_calls 是调试利器,开发期常开
智能体"会说话"了,下一节让它"会干活"——挂上工具,从只会聊变成能联网、能算、能查。