4.1 智能客服系统实战案例
4.1 智能客服系统实战案例
本节摘要:客服是智能体最成熟的落地场景之一。本节用一个完整案例拆解客服系统:需求分析、架构设计(多模态入口、订单查询、人工兜底)、核心能力(知识库、工具、结构化工单)与代码骨架,最后给出上线时必踩的坑。
本节地图
阅读完本节,你应当能够:
- 拆解客服场景的需求与智能体方案
- 设计客服智能体的架构:入口、核心、兜底
- 组合知识库、工具与结构化输出构建客服
- 识别客服上线的质量与合规要求
- 复用本案例架构到其他服务场景
一、问题与直觉
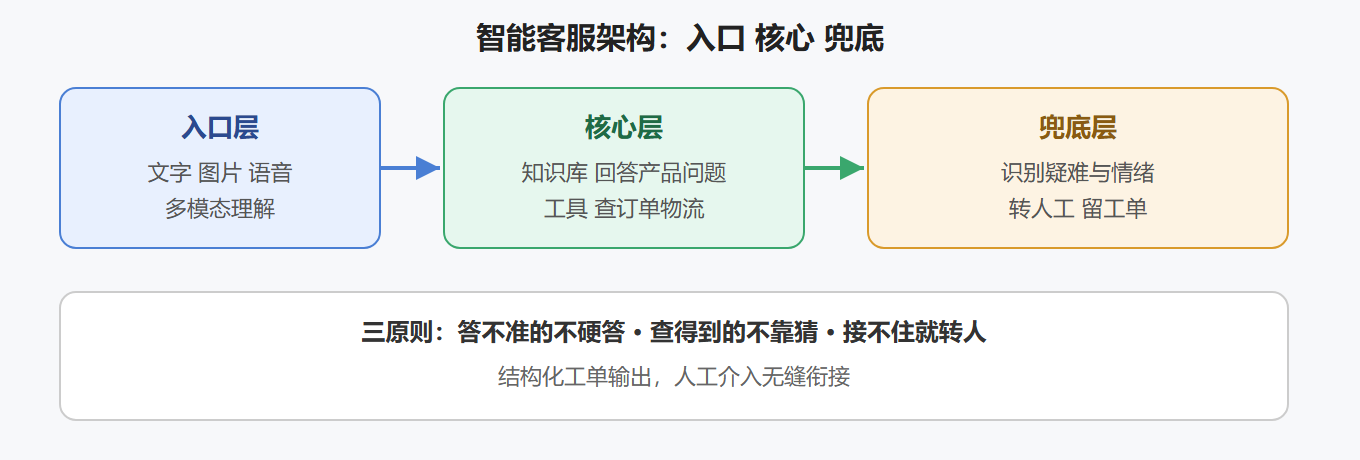
客服机器人最怕两件事:答非所问惹恼用户、乱承诺带来售后纠纷。好的客服智能体不是"话多",而是答得准、有依据、接得住。答得准靠知识库(产品文档、FAQ),有依据靠工具(查订单、查物流),接不住就转人工——三件套缺一不可。
二、核心原理
2.1 客服系统架构
客服智能体的能力分层,从入口到兜底:
三、工程实践要点
3.1 客服智能体代码骨架
from agno.agent import Agent from agno.knowledge import AgentKnowledge from agno.vectordb.lancedb import LanceDb from agno.storage.sqlite import SqliteStorage from pydantic import BaseModel class Ticket(BaseModel): category: str # 问题分类 summary: str # 问题摘要 urgent: bool # 是否紧急 agent = Agent( name="cs_agent", description="负责解答产品与订单问题的客服智能体", knowledge=AgentKnowledge(vectordb=LanceDb(table_name="faq")), search_knowledge=True, # 查 FAQ 知识库 storage=SqliteStorage(table_name="cs", db_file="cs.db"), add_history_to_messages=True, # 记住用户上下文 response_model=Ticket, # 输出结构化工单 instructions=[ "优先依据知识库回答产品问题", "订单问题调用订单查询工具", "不确定或用户情绪激烈时,输出转人工标记", ], )
知识库答产品、工具查订单、结构化输出工单、记忆保上下文——四个能力一次配齐。
💡 关键直觉:客服的"转人工"不是失败,是设计的一部分。提前在指令里定义"什么情况转人工"(不确定、情绪激烈、超出范围),比让模型自由发挥可靠得多。
3.3 质量要求速查
| 要求 | 做法 |
|---|---|
| 答得准 | 知识库 + 引用来源 |
| 不乱承诺 | 指令禁止"包赔包退"类表述 |
| 接得住 | 转人工阈值明确 |
| 可追溯 | 记录会话与工单 |
| 合规 | 敏感话题交人工 |
3.4 落地经验
- 先小范围:先接 20% 流量灰度,观察转人工率与满意度
- 指标监控:转人工率、解决率、平均轮次是三大核心指标
- 知识维护:FAQ 知识库要有人持续更新,过期知识是答错的源头
⚠️ 常见坑:客服智能体上线最怕"看似答了,其实答错"。务必给指令加**"不确定就明说不知道,不要编造"**,并监控转人工率——转人工率异常下降往往意味着智能体在硬答。
四、双智能体架构:意图识别 + 知识应答
原始资料把客服系统拆成两个角色的协作,这个切分值得细看。第一个是语言理解智能体:接收用户的自然语言,识别意图(查订单、退换货、投诉、咨询)与关键实体(订单号、商品名)。第二个是知识库智能体:拿着结构化后的意图与实体去查业务数据(示例里是模拟的订单状态库),生成准确答复。上层由一个编排器把两者串成管线。
为什么不让一个智能体全包?因为两类任务的脾气完全不同:意图识别要快要稳,用小模型加严格格式就够;知识应答要准要可溯源,要挂知识库与业务接口。拆开后各自选型、各自优化、各自评估,出了问题责任边界清晰——这正是第 2 章团队设计原则在真实系统里的落地。
用户:"我上周买的耳机怎么还没到?单号 8 开头那笔" │ ▼ 语言理解智能体 意图:查询物流 实体:品类=耳机 单号前缀=8 │ ▼ 知识库智能体 ── 查订单状态(业务数据) │ ▼ "您的订单正在派送中,预计明天送达……"
五、从原型到生产的四道坎
教程原型到真实客服系统之间,隔着四道必须迈的坎。
兜底与转人工:模型答不准时要体面地退场。设置信度门槛与关键词触发(用户情绪激动、连续两次不满足),把会话转给人工并附上摘要,别让智能体硬撑到底。
知识运营:客服知识(政策、 SKU、活动规则)每周都在变。把知识库更新做成例行动作:文档更新即重建索引、新问题回流进语料、过时内容下线。知识库是运营出来的,不是建完就完的。
评估闭环:固定一批真实问题做回归集,每次改指令、换模型、调知识库都跑一轮。上线后持续抽样人工复核,把坏案例变成新测试用例。
合规与隐私:对话记录涉及个人信息,存储与脱敏策略要先于功能上线想清楚。
| 坎 | 原型里的样子 | 生产里的样子 |
|---|---|---|
| 兜底 | 答不上就乱答 | 识别边界,转人工带摘要 |
| 知识 | 一份静态 PDF | 例行更新的运营流程 |
| 评估 | 肉眼看看 | 回归集 + 抽样复核 |
| 隐私 | 不考虑 | 脱敏、留存期限、权限 |
⚠️ 常见坑:用"问题解决率"单一指标考核客服智能体,团队就会为了指标把难题都转人工。要组合看:自动解决率、转人工后的重复提问率、用户满意度,三只眼睛一起盯。
💡 关键直觉:客服系统的成功标准不是"像人",而是"把高频简单问题挡在人工之外,把复杂问题体面地交给人"。按这个标准设计分流,比追求全自动化务实得多。
知识运营日历:让系统越用越聪明
客服智能体的长期表现,七分靠知识运营,三分靠初始架构。把运营固化成一张日历:每日做坏案例回收——把昨天转人工的会话与用户差评捞出来,归因(检索没命中、意图识别错、知识缺失),能修的当天修;每周做知识同步——与业务方对齐本周的政策与活动变更,更新文档并重建对应索引;每月做评估回归——跑一遍不断增长的问题集,看指标趋势,识别退化点。
这张日历背后是个朴素的认识:客服知识是活的业务资产,智能体只是它的展示层。组织里要有人对知识负责(哪怕是兼职),否则三个月后知识库与现实脱节,用户骂的虽然是机器人,账其实记在运营缺位上。
冷启动阶段另有一个技巧:先用历史工单数据做离线评估再上线。把过去三个月的人工客服记录抽样成问题集,让智能体先"考试",答不好的类别要么补知识要么上线初期直接路由给人工。带着已知边界上线,比裸奔后救火体面得多。
六、常见问题
意图识别用规则不行吗?
高频且稳定的意图,规则又快又便宜,该用就用。规则管不住的是长尾表述与混合意图,这部分交给模型。规则打底、模型兜长尾,是成本与效果的最优组合。
多轮对话的上下文怎么传?
靠记忆机制携带会话历史,语言理解智能体输出里带上指代消解后的完整实体("它"要还原成具体订单号),下游才不用猜。
客服场景选多大强度的模型?
分层:意图识别与格式化用小而快的;知识应答用中等强度的;投诉安抚这类高情感劳动再升一档。全系统一个模型的配置,要么浪费要么不够用。
上线首月的护航手册
客服智能体上线后的第一个月是生死期,用户信任一旦破窗就难重建。护航手册三件套:灰度发布,先放百分之五的流量,观察一周核心指标再逐步放大,任何异常一键回退到纯人工;实时护栏,对低置信度回答自动降级为人工或标准话术,宁可少答不可错答,首月的目标不是解决率而是零重大失误;每日复盘,运营与开发十五分钟站会过一遍前日坏案例,当天能修的当天修。
首月还要刻意收集"边界样本":那些智能体答得磕绊的问题,正是下一轮迭代的需求清单。很多团队上线后只盯着平均指标,平均数好看但尾部灾难频发,用户记住的永远是尾部。把复盘的注意力放在最差的百分之五上,整体口碑的提升反而最快——这个反直觉的规律,在客服场景屡试不爽。
一个月后,护航转为常态运营:指标看板、周度迭代、月度评估各就各位。此时系统才真正算"上线完成",之前的一切都只是开始。
指标看板的最小配置
客服智能体的运营看板不需要炫,五个数字就够:自动解决率(多少会话无需人工收尾)、转人工率及其原因分布(分流边界是否合理)、平均响应时长、坏案例数(每日人工判定的错误回答)、用户满意度抽样。五个数字按天记录、按周对比,任何一个的异常波动都指向明确的排查方向——解决率跌查知识时效,转人工暴涨查分流指令,时长变长查外部服务。看板的意义不在展示而在纪律:数字摆在那里,改进就不会凭感觉;数字的趋势线,就是这个系统唯一的成长档案。
要点串联
- 要点一:客服三件套——知识库答准、工具查实、转人工兜底
- 要点二:架构三层——入口(多模态)、核心(知识+工具)、兜底(转人工)
- 要点三:结构化工单输出,人工衔接无缝
- 要点四:转人工是设计的一部分,阈值提前定义
- 要点五:三大指标——转人工率、解决率、平均轮次
- 要点六:指令必含"不确定就明说",防硬答
服务用户的场景做完了,下一节面向产出——内容创作助手。