1.1 从单打独斗到圆桌会议
1.1 从单打独斗到圆桌会议:单智能体是怎么败下阵来的
本节摘要:复杂任务里单智能体的失败,几乎都能归到四类:任务规模超出一次推理的容量、上下文窗口被过程信息挤爆、多工具调用互相踩脚、中途出错无法恢复。本节用一次"季度市场分析报告"的翻车过程逐条还原这四类失效,再给出圆桌分工如何对应化解,为全册的会议视角立好靶子。
本节是全册的第一块砖:先承认问题存在,后面所有章节的设计才有靶子。如果你在自己的项目里撞到过"提示词越写越长、模型越改越乱"的局面,本节的四个失效现场会帮你把混乱归因。
会议现场还原:一次翻车的全过程
先看一个真实程度很高的场景。某团队要产出一份季度市场分析报告,包含数据整理、竞品调研、图表制作和结论撰写。第一版方案很简单:一个智能体,一条长提示词,外加一组工具。核心逻辑大致如下:
# 第一版:单智能体一把梭(伪代码,示意结构) agent = SingleAgent( tools=[search, browser, code_runner, doc_reader, chart_maker], prompt="""你是一个全能分析师。请完成: 1. 收集本季度行业数据 2. 调研三个主要竞品的价格与功能变化 3. 把数据整理成表格并生成图表 4. 撰写完整分析报告,引用前面所有结果 """ ) # 期望:一次调用,直接出报告 report = agent.run("写一份Q2市场分析报告")
运行结果分阶段恶化:第 1 步搜索正常返回;第 2 步浏览竞品页面时,智能体开始把网页原文大段贴进自己的工作记忆;第 3 步写代码处理数据时,它已经记不清第 1 步搜到的关键数字,开始编造;第 4 步生成的报告里,数据来源与图表对不上,三个竞品的价格写串了两处。整场"会议"开了一个多小时,产出无法使用。
纪要里藏的机制:四类失效逐一归因
把上面这场翻车写进纪要,逐条复盘,会发现四种机制性失效,它们不是"提示词写得不好"能救的:
失效一:任务规模超过单次推理容量。 一份完整报告是四个异质子任务,每个子任务都有自己的中间产物。单智能体被迫在一次任务线程里串行完成所有环节,任何一环的规划失误都会污染后续全部环节。类比一下,这相当于让一个人同时担任项目经理、调研员、数据分析师和排版员,且不许他做任何笔记。
失效二:上下文窗口被过程信息挤爆。 网页原文、代码执行日志、报错信息全部堆在同一条上下文里。上下文一满,模型开始"遗忘"最早的关键信息,随后进入幻觉状态。这不是模型能力问题,是物理容量问题。
失效三:多工具混用导致决策串味。 搜索该搜什么词、浏览器该点哪个按钮、代码该跑哪段——每类工具的最优决策策略完全不同。混在一个"大脑"里做决策,策略会互相干扰:模型常常用搜索的思路去操作浏览器(乱点一通),或用浏览器的思路写代码(没有验证就提交)。
失效四:单点故障无兜底。 中途某一步失败(比如网页抓取超时),没有独立角色判断"这一步失败是否致命、该重试还是绕行"。单智能体要么卡死在原地反复重试,要么悄悄跳过并编造结果。
用一张对比矩阵看单干与开会的差别:
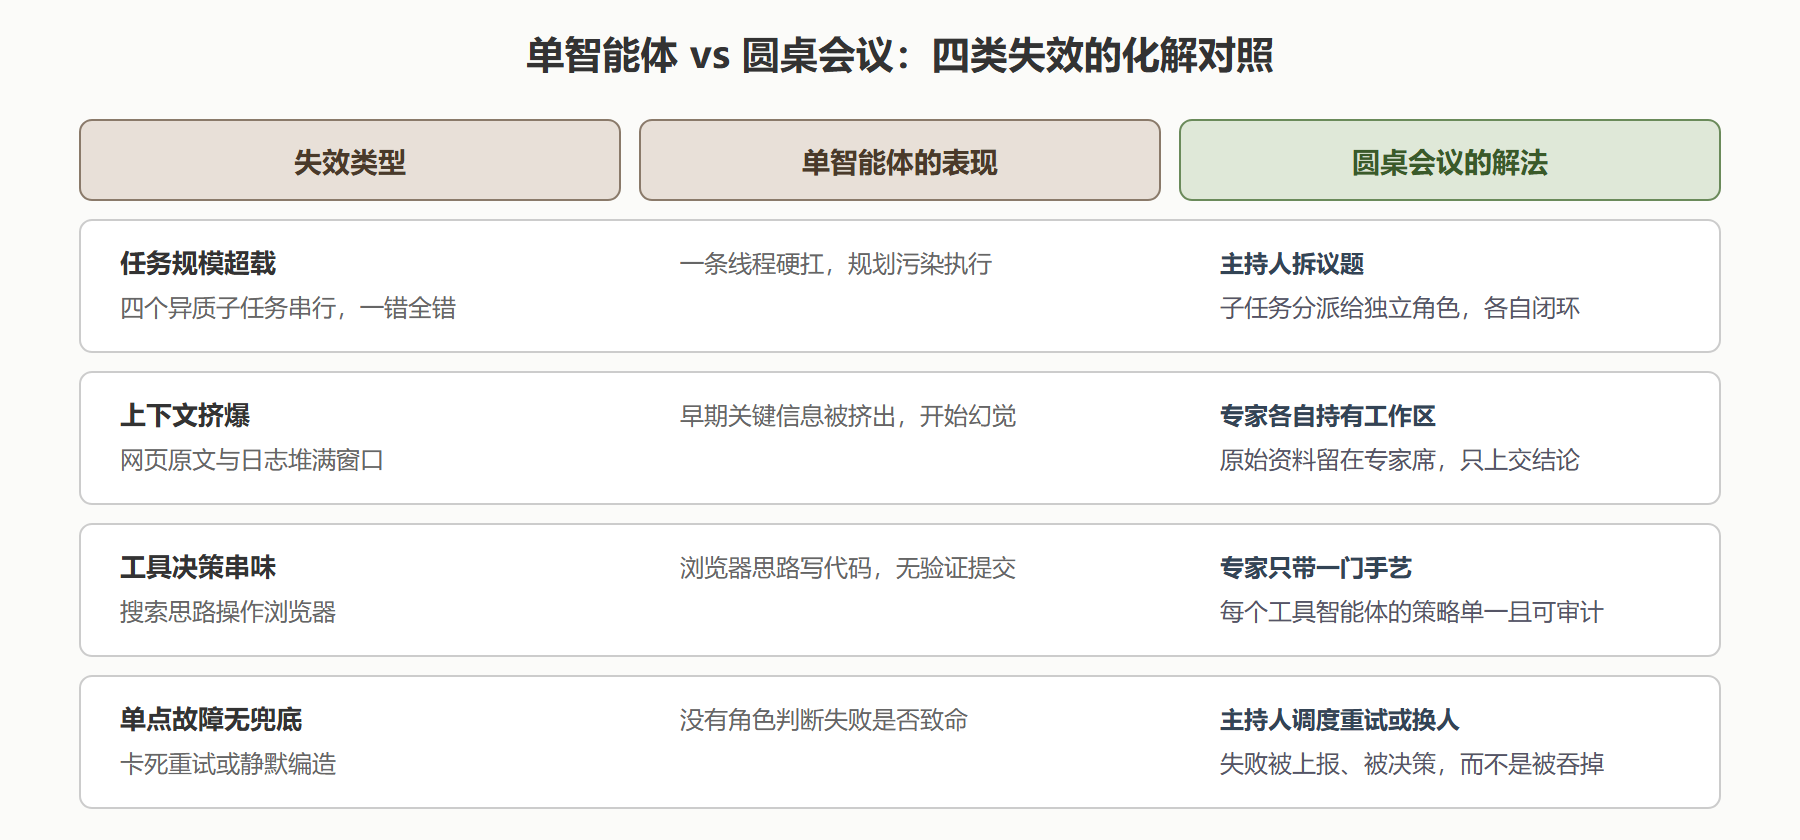
对照矩阵的最后一列,就是 OWL 三角色模型的雏形:拆议题的(用户智能体转达目标后由辅助智能体拆解)、干活的(工具智能体)、盯场兜底的(辅助智能体的调度职责)。第 2 章会给这三个角色各开一节。
复盘与变式:什么时候该开会,什么时候别开
圆桌不是免费的。每多一个与会角色,就多一轮模型调用、多一份 token 开销、多一处可能出分歧的接口。判断要不要开会,可以用三条标准:
- 子任务是否异质——需要的技能(搜索、编码、写作)差异越大,越值得分工;
- 中间产物是否庞大——网页、日志、文件这类大体积中间信息越多,越需要隔离工作区;
- 失败代价是否可接受——如果输出错了会被直接使用(比如自动发邮件),必须有独立核查角色。
反过来说,一句话能说清、一步能做完的任务(翻译一段话、改写一封邮件),开会纯属浪费。我自己的经验值是:任务线程超过三步、需要两种以上工具、中间产物超过两千字,就该考虑圆桌了。
# 一个粗糙但实用的"要不要开会"自检脚本 def needs_multi_agent(subtasks: int, tool_kinds: int, artifact_chars: int) -> str: """按三个维度打分,给出协作模式建议。 subtasks: 任务步骤数(人脑拆一下) tool_kinds: 需要的工具种类数(搜索/代码/文档...) artifact_chars: 预计中间产物总量(字符) """ score = 0 if subtasks >= 3: score += 1 # 步骤多 → 需要议程管理 if tool_kinds >= 2: score += 1 # 工具杂 → 需要专家分工 if artifact_chars > 2000: score += 1 # 中间产物大 → 需要隔离工作区 if score <= 1: return "单智能体即可,别为开会而开会" if score == 2: return "建议双角色:一个规划加一个执行" return "完整圆桌:建议引入 OWL 式三角色协作" # 输出: # needs_multi_agent(4, 3, 15000) -> '完整圆桌:建议引入 OWL 式三角色协作' # needs_multi_agent(2, 1, 300) -> '单智能体即可,别为开会而开会'
两个常见追问
追问一:把单智能体的提示词写得更长、更细,能不能解决这四类失效?
答:能缓解一小部分,解决不了机制问题。更长的提示词本质上是给一个大脑塞更多"注意事项",而四类失效都发生在容量与结构层面:任务规模超载是线程问题,上下文挤爆是物理容量问题,工具串味是策略干扰问题,无兜底是角色缺失问题。提示词能压缩幻觉,不能凭空长出第二个人来核对。工程上常见的观察是:提示词改到第五版之后,边际收益趋近于零,而每次改动又引入新的连带风险——这就是该换协作结构的信号。
追问二:圆桌会议会不会把"一个模型的错误"放大成"几个模型的集体错误"?
答:会,这正是角色边界混乱时的真实风险,也是第 2 章花一整章讲名册的原因。错误放大的通路是固定的:上游角色把偏差带进议题,下游角色不核表直接执行,最后汇总角色把错误包装成结论。切断任何一环都能止血——最便宜的切断点就是验收环节的字段级核验(下一章的主持人与专家两节会反复回到这一点)。反过来说,一个边界清晰、验收较真的圆桌,错误率通常低于单智能体:因为每个错误至少要穿过两道独立检查才能流进最终产出。
本节要点回顾
- 四类失效:任务规模超载、上下文挤爆、工具决策串味、单点故障无兜底,全是机制问题而非提示词问题;
- 圆桌解法:拆议题、隔离工作区、专家只带一门手艺、失败上报并调度;
- 判断边界:子任务异质性、中间产物体量、失败代价,三条标准决定开不开会;
- 代价意识:每个与会角色都是一轮真实开销,会议规模要按需控制;
- 下一站:既然决定开会,下一节看 OWL 这本会务手册的整体设计。