4.4 增补与会名单:定制与扩展
4.4 增补与会名单:定制与扩展
本节摘要:标准会议装不下你的业务时,扩展点有三个:挂自定义工具箱(扩专家席)、替换模型配置(换发言质量)、改写角色提示词(调会议风格)。本节按"侵入性从低到高"逐层讲三层扩展的做法、验收方法与回退成本,最后给出"先改哪层"的决策顺序。
本节处于第 4 章的中后段:默认配置能跑的,前面几节已经跑通;本节解决"跑通了但不好用"。三个扩展层的侵入性依次上升——工具箱是纯增量(不动原有任何配置),模型配置是替换(一处换一处),角色提示词是改写(影响整场会的对话风格)。从低侵入层开始改,是所有扩展的第一原则。
一、第一层:挂自定义工具箱
业务系统里的能力(库存查询、工单系统、内部知识库)都可以包成工具列席,做法在 2.3 已铺垫:写清契约三要件,用 FunctionTool 包装,挂进工具列表。这里补上"验收一件自定义工具"的标准动作:
from camel.toolkits import FunctionTool def query_ticket_status(ticket_id: str) -> str: """查询内部工单的处理状态。 参数 ticket_id: 工单编号,格式如 TKT-2026-0001。 返回: 一句话状态描述,含当前环节与最近更新时间; 编号不存在时以'失败:'开头说明。 """ tickets = {"TKT-2026-0001": "已派单,研发环节,昨日更新"} return tickets.get(ticket_id, f"失败: 工单 {ticket_id} 不存在") ticket_tool = FunctionTool(query_ticket_status) def smoke_test_tool(tool_fn, cases: list) -> dict: """自定义工具冒烟测试:三正一反。 cases: 每项(入参, 期望输出包含的关键词)""" results = {} for arg, expect in cases: out = tool_fn.openai_schema # 确认契约已被正确读取 actual = query_ticket_status(arg) results[arg] = "通过" if expect in actual else f"异常: {actual}" results["契约检查"] = "函数名与参数名已进入工单描述" if tool_fn else "契约缺失" return results # 输出: # smoke_test_tool(ticket_tool, [("TKT-2026-0001", "已派单"), ("TKT-9999-9999", "失败:")]) # -> {'TKT-2026-0001': '通过', 'TKT-9999-9999': '通过', # '契约检查': '函数名与参数名已进入工单描述'}
冒烟测试里的"一反"(错误入参)与正例同样重要:专家收到不存在的工单号时,回报必须以"失败:"开头(2.3 的失败上报纪律),而不是返回一个看似正常的空结果。
二、第二层:替换模型配置
换模型是"一处换一处"的替换操作,但影响面比看起来大——两位核心角色的发言质量、工具拟单的准确率、验收的严格程度,全由模型决定。替换前建议做一次小规模对照:同一张议题卡、同一份日志样例,分别交给新旧模型跑两轮,对比三点——议题转写是否更忠于原意、拟单参数是否更准、验收是否更较真。
def compare_models(scores: dict) -> dict: """新旧模型对照打分:每项 1-5 分。 scores: {'维度': {'旧': x, '新': y}}""" verdict = {} for dim, s in scores.items(): delta = s["新"] - s["旧"] verdict[dim] = f"{'升级' if delta > 0 else '持平' if delta == 0 else '回退'}(差值 {delta:+d})" return verdict # 输出: # compare_models({"议题转写": {"旧": 3, "新": 4}, # "拟单准确": {"旧": 3, "新": 5}, # "验收严格": {"旧": 4, "新": 3}}) # -> {'议题转写': '升级(差值 +1)', '拟单准确': '升级(差值 +2)', # '验收严格': '回退(差值 -1)'}
对照里出现"验收严格回退"这类负向项时别急着否决换型——有时新模型把含糊回报放行,恰恰说明旧模型"严格"是靠反复追问换来的(轮次开销更大)。把审计维度和 4.3 的三本账放在一起看,再定去留。
三、第三层:改写角色提示词
角色提示词决定会议的性格:主持人多较真、甲方代表多啰嗦、专家多主动。改写它侵入性最高,因为一处的措辞变化会传导到每一轮对话。三条改写纪律:
- 一次只改一个角色,改完跑缩微任务对照(4.2 的缩微法),别三个角色一起动;
- 禁止条款要具体:"禁止编造数据"不如"禁止给出未出现在工具回报中的数字";
- 保持角色边界:给主持人加"更主动分析"的条款时,检查它有没有顺手夺走专家的活。
def review_prompt_change(old_prompt: str, new_prompt: str) -> list: """提示词改动审查:返回风险提示列表。""" risks = [] if "禁止" in new_prompt and "禁止" not in old_prompt: risks.append("新增禁止条款:确认条款具体可核,不含糊") if len(new_prompt) > len(old_prompt) * 1.5: risks.append("篇幅膨胀超五成:角色边界可能被稀释,考虑精简") if "分析" in new_prompt and "分析" not in old_prompt: risks.append("新增分析职责:确认未越过其他角色的边界") return risks or ["改动温和,可直接跑缩微任务验证"] # 输出: # review_prompt_change("你是主持人,负责拆解与派单。", # "你是主持人,负责拆解、派单,并主动深入分析每个子任务。") # -> ['新增分析职责:确认未越过其他角色的边界']
四、三层怎么选:一条决策链
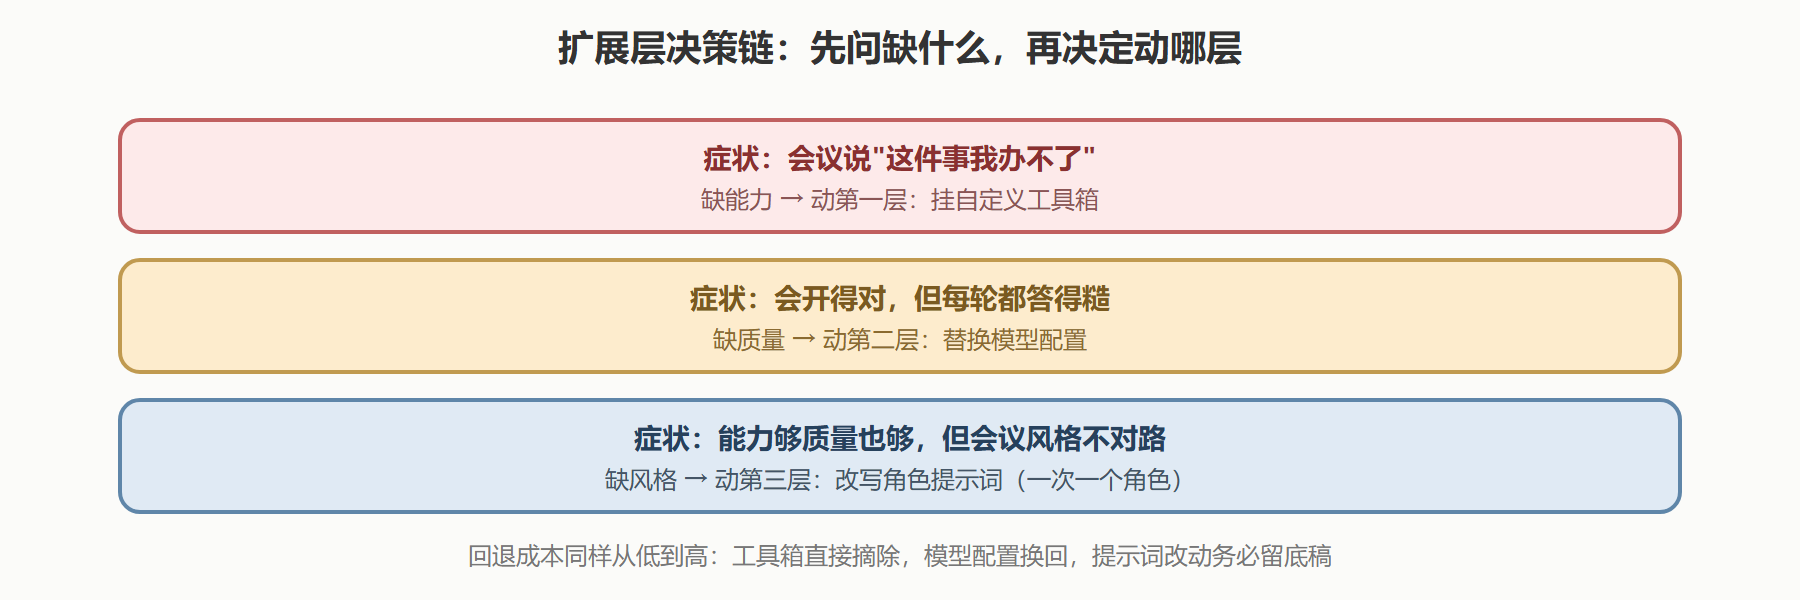
⚠️ 三层一起改是大忌。症状归因会被搅成一锅粥——你永远不知道是哪个改动起了作用(或搞了破坏)。每层改完,跑一次缩微任务留档,再动下一层。
案例展开:一次三层联动扩展的全记录
背景:团队把竞品调研会议改成月度常设任务时,遇到三个症状叠加:会中说"无法读取我们内部的报价系统"(缺能力)、结论文字干瘪(缺质量)、主持人对非数字议题也较真到死板(缺风格)。操作:按决策链逐层动——第一层包了一个报价查询工具挂上(冒烟三正一反通过),第二层仅把执行侧换成更强的模型(甲乙方保持原配置,观察两轮对照后全量替换),第三层只改了主持人的提示词,加了"数字议题严格对表,描述议题允许开放讨论"的分流条款。结果:下一场月度会,报价数据直接来自内部系统,结论段增加了分析性表述,轮次反而比上期少三成(强模型的拟单更准,返工少了)。解读:这次联动扩展的成功,关键不在改了什么,而在改动的顺序与间隔——每层之间都隔着一次可对照的复跑。
变式:组织层面想沉淀扩展成果时,把第一层的自定义工具集中登记(名称、契约、冒烟用例、负责人),形成"外聘专家花名册"——这就是第 5 章常设委员会的物资基础。
本节要点回顾
- 三层扩展:工具箱(纯增量)、模型配置(可对照替换)、角色提示词(改性格),侵入性递增;
- 自定义工具必过冒烟:三正一反,反例验证失败上报纪律;
- 换模型做对照:议题转写、拟单、验收三维度打分,结合三本账定去留;
- 提示词一次改一个角色:禁止条款要具体可核,改动留底稿;
- 下一节是全册实战压轴:贯穿案例的完整复盘纪要。