1.3 卖点与应用:哪些戏适合这台剧场
1.3 卖点与应用:哪些戏适合这台剧场
本节摘要:本节盘点 CAMEL 的六项看家本领——大规模智能体模拟、动态通信、状态记忆、基准测试、角色多样性、数据生成与工具集成——并把它们折算成四类可上演的剧目:数据生成、任务自动化、世界模拟、行为研究。同样重要的是三条止损线:哪些戏别在这台剧场上演。读完你应能对任意需求做一次上座判断。
先认清这家剧团的班底
判断适用性之前,先看班底。CAMEL 从立项起就带着研究基因,它的六项能力不是营销词,每项都对应框架里的实在部件。
大规模智能体模拟:框架支持把双角色机制扩展到大规模智能体社会,用于研究涌现行为——这是它作为研究平台的底盘。动态通信:智能体之间的消息实时往返,指令流与方案流双向咬合,协作不是批处理。状态记忆:两侧演员都维护历史上下文,多轮交互中方案能保持连贯,这是 1.2 节消息集合概念的机制化。基准测试:框架附带标准化的评估基准,你的实验结果可以与公开数据对表,第 6.1 节会用到。角色与任务多样性:角色名、任务卡、模型、环境四个维度全部可插拔,同一套编排代码换个剧本就是另一个产品。数据生成与工具集成:一场对手戏的产出就是一份结构化的指令-方案对话数据,配上具身工具还能让方案落进真实环境——这条能力在第 4 章会发展成完整的数据流水线。
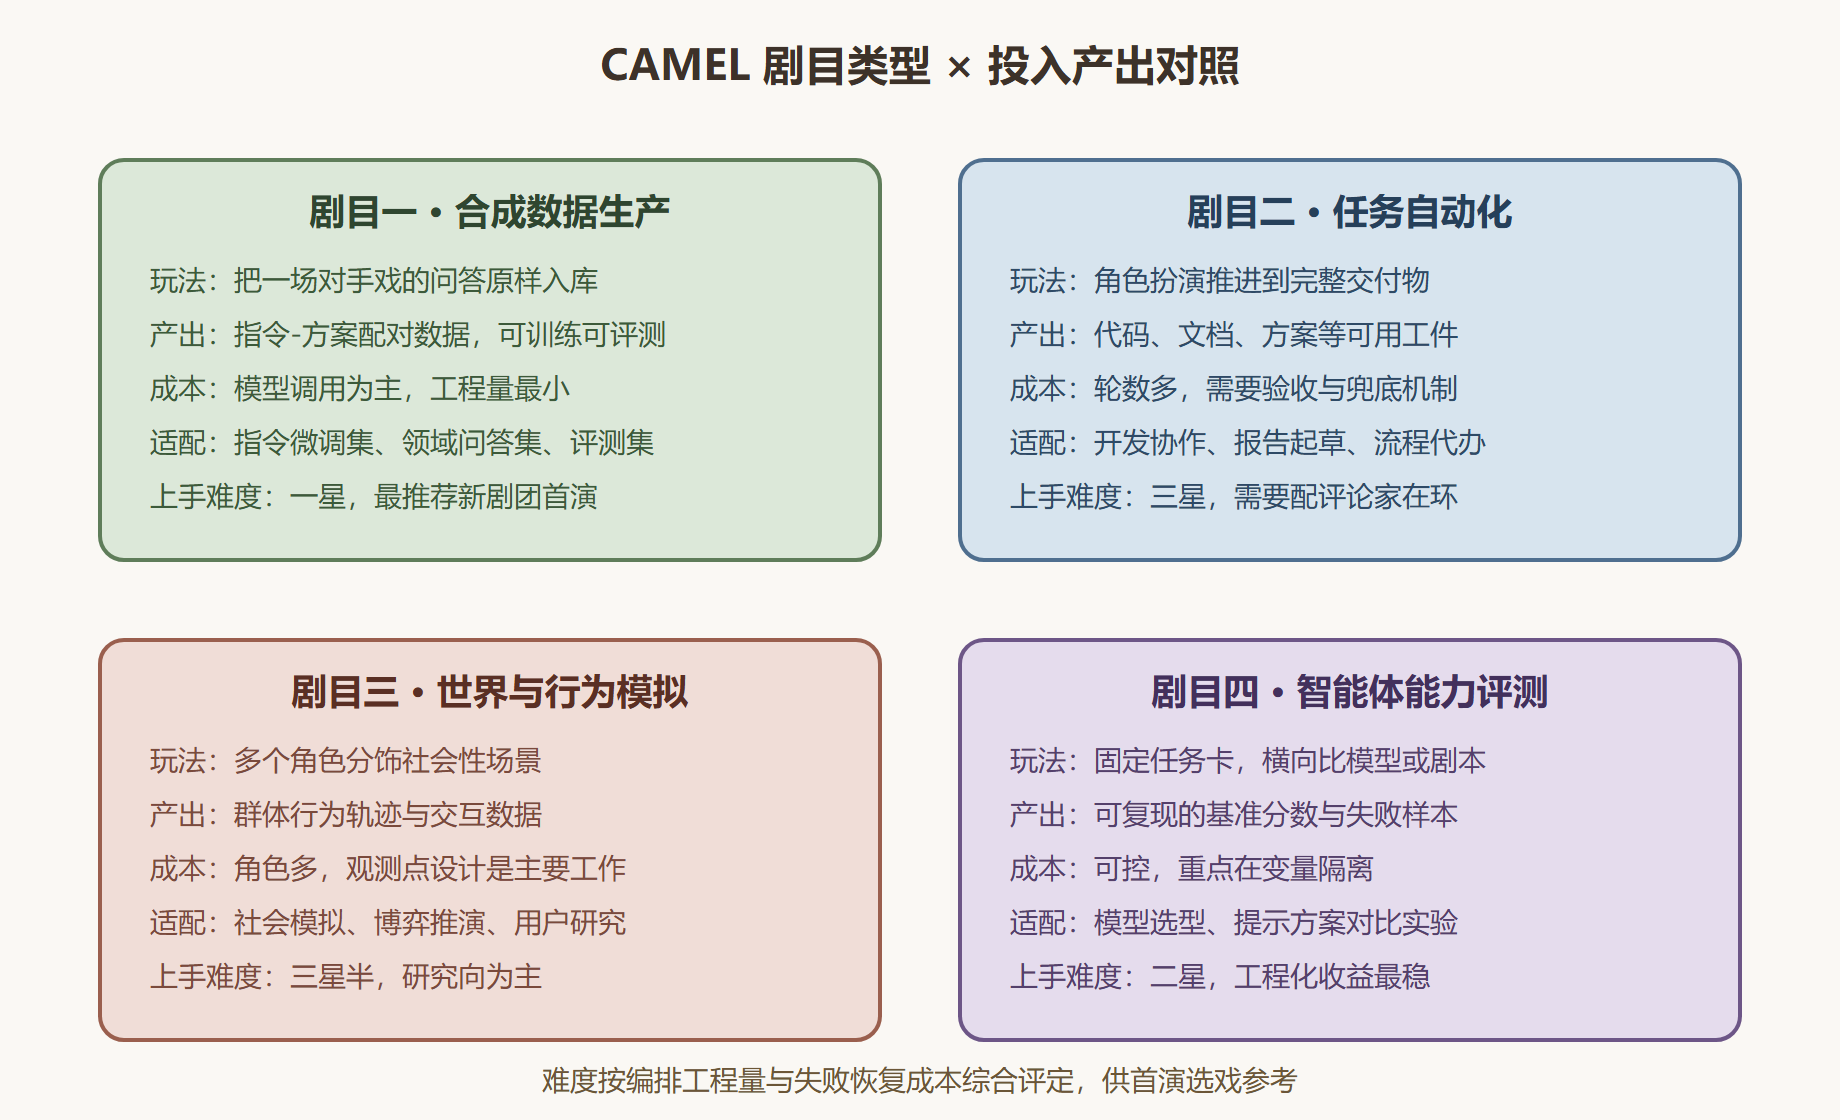
图 3 四类剧目与投入产出对照
三条止损线:什么戏别接
对照表的另一半更重要。以下三类需求,这台剧场演不了或演不划算,遇到就别硬上。
止损线一:答案可一次生成的封闭问题。 "把这段话翻译成英文""这个报错怎么修"——单个模型一次作答已经是最优解,硬拆成两个角色只会把一次调用的成本放大二十倍,还引入了新的跑偏风险。双智能体的价值来自多轮拉扯,没有拉扯空间的任务没有观众。
止损线二:强实时、严延迟的在线链路。 对手戏一轮接一轮,总延迟是两侧生成时间之和。放在客服首响、交易下单这类秒级时限里,编排开销会吃掉全部收益。它适合的是离线批处理:夜里跑几百场戏,早上收工件。
止损线三:输出正确性无法判定的开放创作。 用户智能体验收的前提是它能分辨方案好坏。诗歌水准、品牌调性这类主观维度,甲方演员自己都判不了,拉扯会退化成互相寒暄。补救办法是把主观题拆出可检验的硬指标——字数、结构、要素清单——拆不出来就换工具。
上座判断的纸面演练
给一个真实场景走一遍判断流程。需求来自一家电商团队:"每天自动生成十条商品文案,要求卖点突出、风格统一、附三条备选"。三步判断:
def judge_fit(requirement: dict) -> str: """三步上座判断:有拉扯空间吗、延迟敏感吗、能验收吗。""" # 第一步:任务能否拆成多轮有依赖的子任务 stretch = requirement["subtasks"] >= 3 and requirement["steps_dependent"] # 第二步:是否在秒级实时链路上 realtime = requirement["latency_sla"] < 5 # 第三步:产出是否可被角色内验收 checkable = requirement["acceptance_criteria"] != "" if not stretch: return "止损:没有拉扯空间,单模型一次作答更划算" if realtime: return "止损:实时链路扛不住多轮往返延迟" if not checkable: return "改造:把主观要求拆成硬指标再上" return "上座:适合双智能体编排,先立剧本再开演" req = {"subtasks": 4, "steps_dependent": True, "latency_sla": 3600, "acceptance_criteria": "卖点数不低于3条 风格词表内"} print(judge_fit(req))
上座:适合双智能体编排,先立剧本再开演
商品文案案例的判定是"上座",但注意判定函数的细节:延迟条款给的是批处理窗口(一小时),不是单条秒回——把在线需求转成离线批处理,是这类场景最常见的化救手法。再补一个反面演练:把延迟条款改成 3 秒再跑一次。
req_bad = dict(req, latency_sla=3) # 改成秒级实时场景 print(judge_fit(req_bad))
止损:实时链路扛不住多轮往返延迟
同一个需求,换一个交付时限,结论从"上座"翻成"止损"。这就是本节想留下的直觉:适用性从来不是框架的属性,而是框架与任务形态合不合拍的属性。四类剧目图给出的是大概率区间,判断函数给出的是你自己的裁决逻辑,两者配合使用。
把判断函数沉淀成团队的固定工位还有一步:给每类剧目记录历史判定。做法很简单,每次裁决后往一张台账里写一行——需求、判定结果、事后复盘的真实结论。跑上几个月,台账会回答一个判断函数回答不了的问题:你的团队在哪类剧目上历史上座率最高。选戏的直觉会从"框架能干什么"迁移到"我们演什么最稳",这是班底经验的真正沉淀方式。
六项本领的两两组合
四类剧目之外,还有一个更细的观察角度:六项看家本领很少单独出场,真实项目里几乎全是两两组合在产生价值。数据生成加基准测试,是最常见的一对——自产数据自评模型,形成不用外部依赖的实验闭环;角色多样性加大规模模拟,是社会行为研究的标配——不同职业设定在群体里互动,观察协作规范怎么自发形成;状态记忆加动态通信,则是任务自动化的底座——多轮往返里方案不散架,靠的就是这两件配合。
PAIRINGS = { "数据生成+基准测试": "自产自评的实验闭环,评测集迭代最快", "角色多样+规模模拟": "社会行为研究标配,观察规范自发形成", "状态记忆+动态通信": "任务自动化底座,多轮往返方案不散架", "数据生成+工具集成": "带事实核查的产线,数据质量上一档", } for pair, note in PAIRINGS.items(): print(f"{pair} -> {note}")
数据生成+基准测试 -> 自产自评的实验闭环,评测集迭代最快 角色多样+规模模拟 -> 社会行为研究标配,观察规范自发形成 状态记忆+动态通信 -> 任务自动化底座,多轮往返方案不散架 数据生成+工具集成 -> 带事实核查的产线,数据质量上一档
组合视角的实际用处在校准预期:看中某项单项能力而来的人,往往会失望——单独的"状态记忆"并不比一份精心设计的上下文模板强多少。单项本领是零件,剧目才是产品;评估一台剧场值不值得用,永远拿剧目对照你的需求,而不是拿零件清单对照。
顺带交代班底里一位远近亲戚:CAMEL 生态里后来长出的 OWL 框架,把双角色机制扩成了多方协作的群戏,那是另一本教程的主场。在本册第 4.4 节,你只需要知道"对手戏怎么长成群戏"的分岔口在哪里。
班底、剧目、止损线都清点完了,第 1 章的戏可以开机。下一章进后台,拆那份最值钱的道具——剧本。