2.1 角色扮演机制:主角的自我修养
2.1 角色扮演机制:主角的自我修养
本节摘要:角色扮演是 CAMEL 的灵魂机制:用系统消息把两个模型钉死在互补角色上,让指令流与方案流单向循环。本节拆解它为什么有效——系统消息的优先级、双循环的供能结构——并复盘立场漂移的三种形态与提示层解法。承接第 1 章立起的舞台,本节回答"戏为什么演得下去"。
一个必须先接受的反直觉
人类经验里,让两个人长期演好对手戏,靠的是演技与默契。放到大模型身上,这套经验全部失效:模型没有"演技"这种稳定属性,它只有条件概率——给定前文,生成最像接续的内容。角色扮演机制的真正的手,是利用前文的主导权:系统消息在对话历史上永远排在最前、权重最高,你往开头放什么角色设定,后续所有生成都会朝着与它一致的方向倾斜。
这就是"自我修养"的本质:不是演员有修养,是剧本替演员托底。理解了这一点,三个推论立刻成立。其一,系统消息的每个字都在花预算,废话一句,收敛力弱一分。其二,角色钉得住钉不住,不看形容词多少,看约束是否具体到行为。其三,任何轮次出现漂移,第一反应不是换模型,是回查剧本——概率机制的病,回到概率源头治。
图 4 双循环供能结构
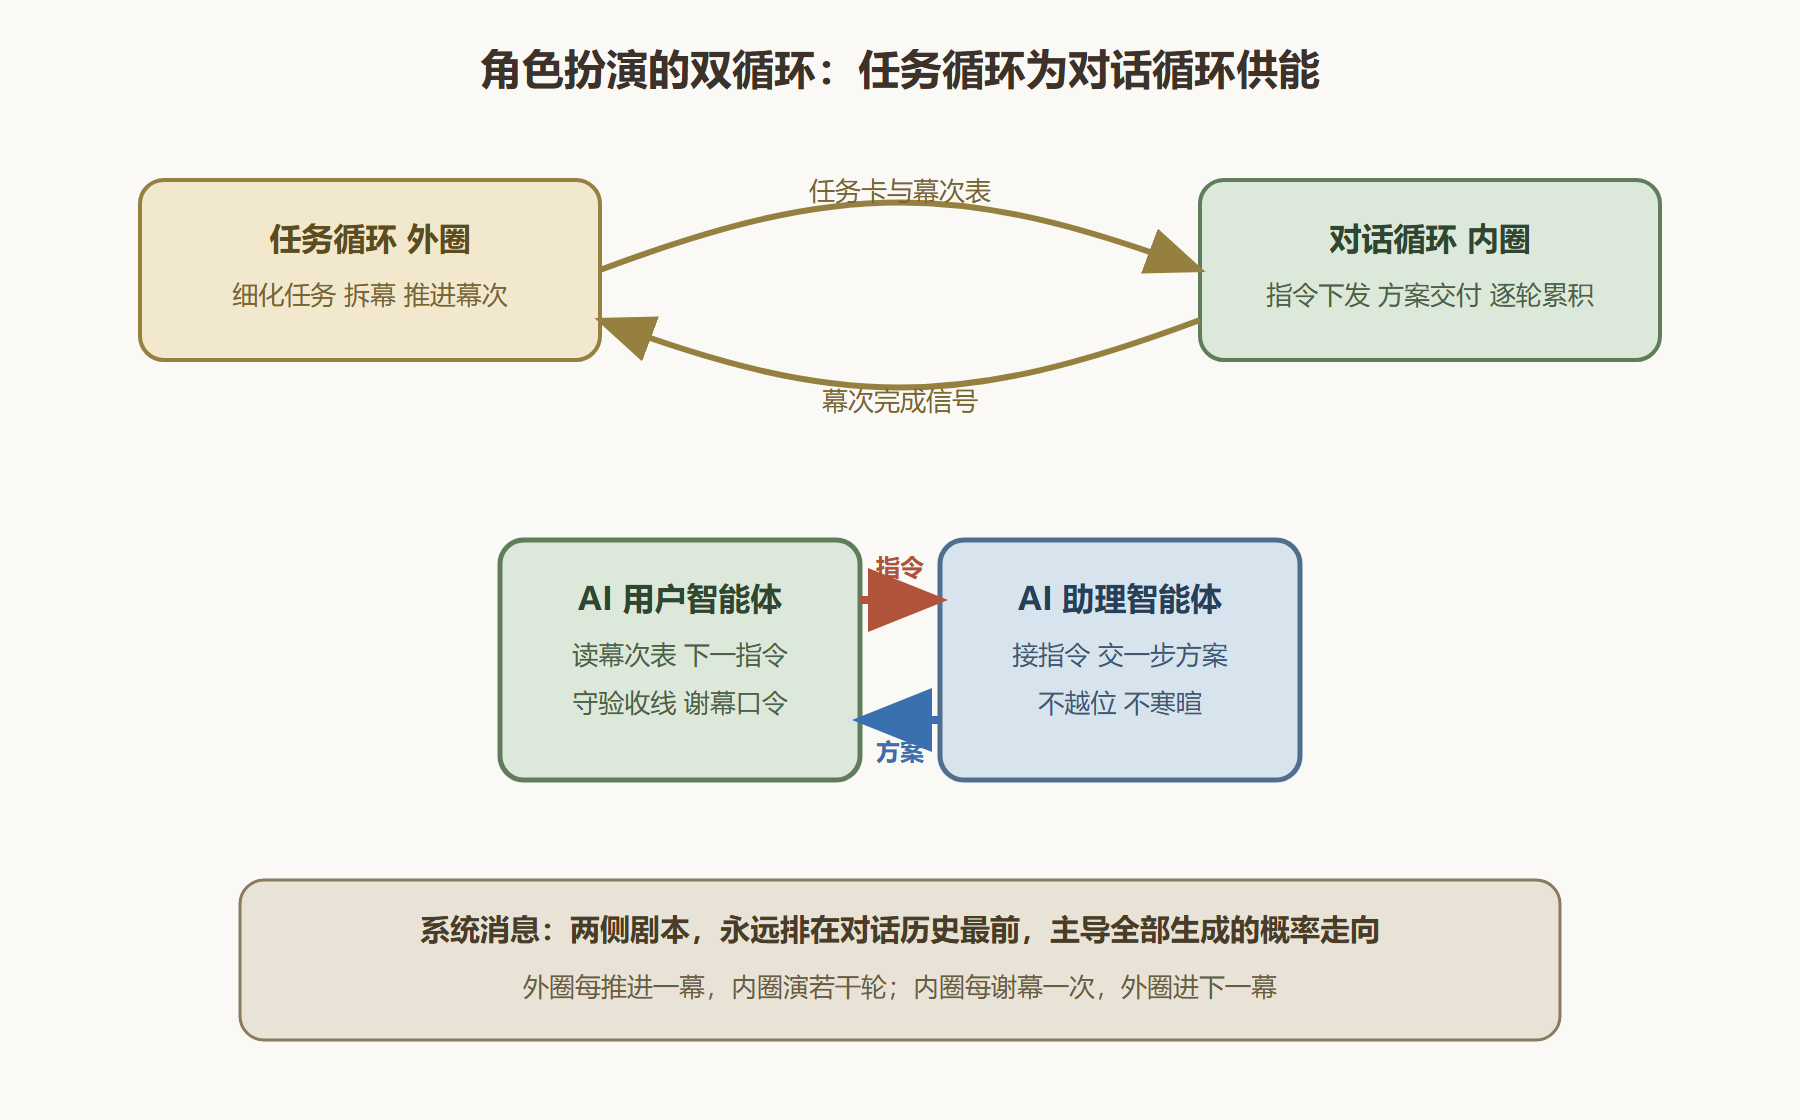
双循环怎么互相供能
很多资料只画一个"对话循环",那是不完整的。CAMEL 的角色扮演实际是嵌套双循环:内圈是对话循环——用户侧下指令、助理侧交方案、历史累积、下一轮;外圈是任务循环——把总任务切成幕,每幕给内圈一段明确的小目标,幕内对话收敛后携完成信号进入下一幕。外圈给内圈供方向,内圈给外圈供证据(每一轮的交付物就是幕次完成的依据)。
为什么必须有外圈?看一组对照。十轮预算演"做一个交易机器人",没有外圈时,甲方演员面对的是一整头大象,它的指令会不断在不同模块间跳跃——第一轮行情、第二轮回测、第三轮又回到行情,因为总任务在它眼前始终没有"当前进度"的概念。有外圈时,甲方演员每一幕只盯一个模块,幕内对话高度收敛。同一份提示词,就多了"幕次表"这一个变量,完成率天差地别。2.3 节会专门讲拆幕手艺,本节先把双循环的形状刻进脑子。
立场漂移的三种形态
机制讲完,看病灶。长对话里角色失格不是随机故障,它有三种稳定形态,各有对应的提示层解法。
形态一:恭维合谋。 表现是两侧开始互夸——"这个问题提得非常好""您的方案太专业了",信息增量趋近于零。根子在模型的礼貌先验:训练数据里的得体对话占比太高。解法是在两侧剧本里同时写入否定式约束:"不要评价对方的问题或方案好不好,只处理内容本身"。注意必须两侧同写,只写一侧时,另一侧的恭维仍会诱发附和。
形态二:立场互换。 甲方开始替乙方写方案,或乙方开始反问需求。这是最恶性的形态,因为它伪装成"高效协作"。解法是把红线写成行为禁令而非态度建议:"用户侧永远不给出代码或具体实现,发现自己在写实现就立即停止并重新下达指令"。禁令要具体到可观察的行为动词,"保持角色"这种话等于没写。
形态三:任务遗忘。 第十几轮起,对话话题缓缓漂到相邻领域,甲方演员甚至主动宣布"我们顺便也讨论一下风控吧"。根子是消息集合越来越长,系统消息的相对权重被稀释。解法有二:剧本里加一句"每条指令必须能追溯到总任务卡的某个子目标";工程上控制历史窗口,把过老的轮次摘要化——这个手法在 3.3 节参数部分展开。
三种形态可以写成一个轻量巡检脚本,跑在每场戏结束后:
import re def drift_scan(dialogue: list) -> dict: """对一场对话做立场漂移巡检,dialogue 为 (角色, 文本) 序列。""" flattery = re.compile(r"(非常好|太专业|很棒|好问题|精彩)") role_swap = re.compile(r"(需要我帮你|我来写|你直接|那我替你)") report = {"恭维次数": 0, "互换嫌疑": 0, "首轮出现轮次": None} for i, (who, text) in enumerate(dialogue, 1): if flattery.search(text): report["恭维次数"] += 1 if report["首轮出现轮次"] is None: report["首轮出现轮次"] = i if role_swap.search(text): report["互换嫌疑"] += 1 return report logs = [("用户", "这个问题提得非常好,接下来你写数据模块"), ("助理", "谢谢认可!需要我帮你把策略也写了吗")] print(drift_scan(logs))
{'恭维次数': 1, '互换嫌疑': 1, '首轮出现轮次': 1}
这版巡检用正则抓行为指纹,误报难免,但方向对:漂移是可观测的,观测是可自动化的。生产上通常替换成一次廉价的模型判定调用,逻辑相同。
自我修养清单
把本节收进一张可执行清单,写剧本时逐条过:两侧角色名具体到职责了吗;否定式约束写的是行为动词还是态度形容词;恭维禁令两侧同写了吗;每条指令可否追溯到总任务的子目标;谢幕口令在甲方剧本里出现了吗。五条全过,这场戏的概率地基才算打完。
清单之外,再给一个关于"修养"的动态视角:角色不是一次立住、终身有效的。同一场戏的不同幕,角色需要的收敛强度不同——首幕要立人设,约束写得最重;中段演出进入节奏,约束可以稍松以给演员留发挥余地;末幕要收束,谢幕口令与完成判定重新收紧。把"约束强度随幕次变化"写成剧本的显式段落,比全篇匀速的硬约束更省预算也更稳。这个手法在 5.1 节的股票剧目里会看到实际用法:首幕剧本比中幕多出两条行为规则,末幕重新强调谢幕格式。
最后回应一个常见质疑:既然系统消息主导概率走向,为什么不干脆把历史清空、每轮都重贴完整剧本?答案是成本与连贯的平衡——每轮重贴等于把系统消息复制 N 份,令牌开销线性膨胀;而保留历史本身就有价值,甲方验收靠的就是"读过全部交付物"。折中方案在 3.3 节出现过:历史窗口加摘要,系统消息永居首位。机制理解透了,参数才有方向。
机制层通了,下一节进手艺层:那三段被反复引用的剧本,究竟该怎么落笔。