2.4 剧团架构:台上台下的分工
2.4 剧团架构:台上台下的分工
本节摘要:本节把 CAMEL 的组件摊在一张架构图上:智能体层(ChatAgent 与两侧角色)、编排层(RolePlaying 会话)、加工层(任务分解器)、模型层(模型工厂与配置)。读完你能对任何一个调参动作——改温度、换模型、改剧本、开关细化——说出它动的是哪一层、会波及谁。这是第 2 章的收束,也是第 3 章动手前的图纸。
改参数前先认工位
前两节你已经动过不少旋钮:写剧本、开细化解、设轮次。但"动哪个旋钮"和"动了哪层架构"是两回事——不知道后者,出了问题就只会瞎试。CAMEL 的架构可以用剧团来记:台上是两个演员,台下是编排与加工工位,后台是模型供给。四层各司其职,层间只走消息。
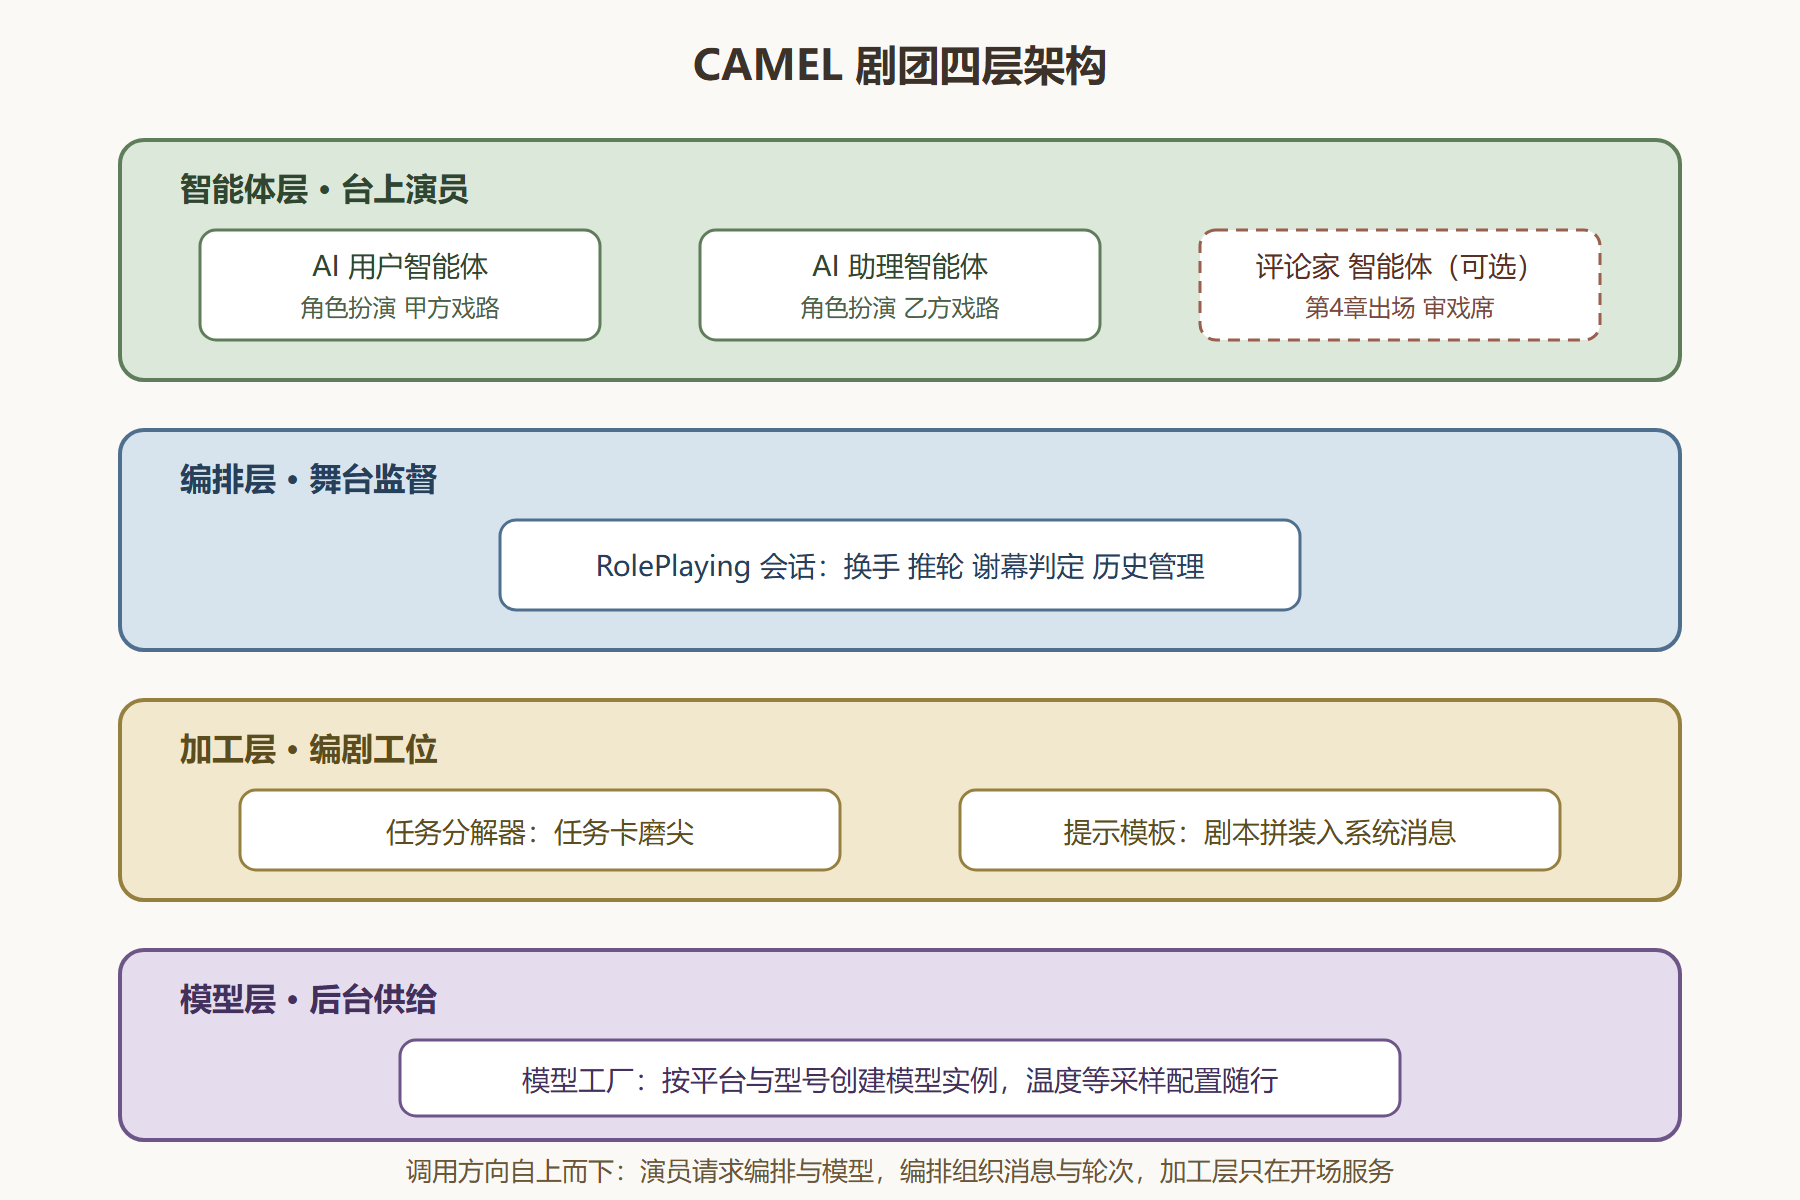
图 6 剧团架构分层图
四层各自管什么
智能体层是唯一"会说话"的一层。两侧演员在框架里是同一类基座(ChatAgent,对话智能体)配不同的系统消息——这个设计值得咀嚼:甲方乙方没有本质区别,区别只是剧本。理解这一点后,很多现象豁然开朗:为什么两侧可以互换戏路重演一场戏(对照实验常用手法)、为什么加第三个角色(评论家)不需要新机制、为什么换模型等于给同一角色换班底。
编排层是本节的真正主角。RolePlaying 会话负责四件事:把两侧演员请上台并注入剧本;维护消息集合与轮次状态;在每一步之间做换手(把助理的方案变成用户的输入,反之亦然);在每步之后跑谢幕判定。你在 1.1 节用过的 step、init_chat、terminated,全是这一层的接口。编排层不生产任何内容——它是纯粹的流程机器,这也是它可靠的原因。
加工层只在开场服务一次:任务分解器磨尖任务卡,提示模板把角色、目标、约束拼装进两侧系统消息。开场之后这一层就休息了——这也是为什么改剧本不用重启任何东西,改的只是下一场戏的开场白。
模型层决定每个演员用哪个脑子。两侧演员默认共用一个型号,但完全可以分开设——常见的工程配置是给助理侧配强模型、甲方侧配便宜模型:验收动作比交付动作简单,没必要两侧都用最贵的脑子。
用代码把四层走一遍
下面这段配置把四层全部显式声明,每一行注释对应它所在的层:
from camel.agents import RolePlaying from camel.typing import ModelType from camel.configs import ChatGPTConfig # —— 模型层:两个模型实例配置,助理侧低温求稳,用户侧高温求活 —— assistant_cfg = ChatGPTConfig(temperature=0.2) # 交付物要稳定可复现 user_cfg = ChatGPTConfig(temperature=0.7) # 指令需要多样性 session = RolePlaying( # —— 智能体层:两侧戏路在此声明 —— assistant_role_name="Python 程序员", user_role_name="股票交易员", # —— 加工层:细化开关与分解器选型 —— with_task_specify=True, task_specify_agent_kwargs=dict(model_type=ModelType.GPT_4), # —— 模型层:两侧各配各的脑子 —— model_type=ModelType.GPT_4, assistant_agent_kwargs=dict(model_config=assistant_cfg), user_agent_kwargs=dict(model_config=user_cfg), ) # —— 编排层:一次 step 内部发生的事 —— input_msg = session.init_chat() assistant_response, user_response = session.step(input_msg) print("谢幕判定:", assistant_response.terminated) # 编排层每步必跑 print("本轮信息量:", assistant_response.info) # 令牌用量在此可见
谢幕判定: False 本轮信息量: {'id': '...省略...', 'usage': {...}, 'terminators': (...), ...}
注意 info 字段——编排层每一步都记下令牌用量与终止器状态。做成本核算时,累计每场戏的 usage 就是你的账本,第 6 章评估会直接用它。
改动波及对照表
把常见调参动作映射到层,出问题时按此定位:
| 你动的东西 | 所在层 | 直接受影响 | 可能波及 |
|---|---|---|---|
| 角色名与剧本 | 智能体层 | 两侧行为收敛度 | 谢幕时机、漂移形态 |
| 轮次上限与终止器 | 编排层 | 场次成本、谢幕率 | 数据完整性 |
| 细化开关与分解器 | 加工层 | 指令起点质量 | 全场对话走向 |
| 模型型号与温度 | 模型层 | 生成质量与方差 | 成本、速度 |
表里最有用的经验是最后一列:编排层的改动是全局的,模型层的改动是局部的。温度调错,坏的是一场戏;终止器配错,坏的是整批数据。动编排层前先在小批量上验证,是省钱的习惯。
分层还有一个日常用法:给问题定位定路线。线上出了状况,按"哪层先坏查哪层"的顺序走——先看模型层(调用是否成功、延迟是否异常),再看智能体层(输出是否漂移、格式是否崩坏),然后编排层(换手是否正确、历史是否错乱),最后加工层(剧本是否拼装出错)。这个顺序的理由是故障率:模型层依赖外部服务,故障率最高;加工层只在开场跑一次,故障率最低。把排查顺序固化,团队里任何人拿到同一类问题都能按同一条路走,而不是各自凭感觉试。
def locate_fault(symptom: str) -> str: """按四层顺序给症状定位首选排查层。""" routes = { "调用报错或超时": "模型层:查凭据与网络,再查型号可用性", "输出格式崩坏": "智能体层:查剧本输出格式约束是否被磨穿", "历史错乱或重复": "编排层:查换手逻辑与消息回传对象", "开场就跑偏": "加工层:查任务卡与拼装后的完整系统消息", } return next((v for k, v in routes.items() if k in symptom), "症状不典型:按模型层到加工层的默认顺序逐层查") print(locate_fault("第 6 轮起输出格式崩坏,代码块闭合丢失"))
智能体层:查剧本输出格式约束是否被磨穿
图纸齐了,戏班该进真正的剧场。第 3 章动手:装环境、配密钥、把你这两章写的剧本原样搬上舞台。