2.3 规划与决策
2.3 规划与决策
本节摘要:规划是「制定长期行动方案」,决策是「当下选哪个行动」,二者是智能体的方向盘。本节先厘清规划与决策的区别,再展开经典规划(STRIPS/PDDL/状态空间搜索)、不确定性决策(MDP/强化学习)、分层规划三类方法,最后给出 A* 搜索与 Q-Learning 两个可运行的 Python 实现,并讨论规划与决策面临的挑战。
上手前先明确
阅读完本节,你应当能够:
- 说出规划与决策的区别与联系
- 解释 STRIPS 与 PDDL 的前提条件/效果机制
- 描述 A* 搜索的 f=g+h 评估逻辑并写出实现
- 说出 MDP 五要素(状态、动作、转移概率、奖励、折扣因子)
- 区分 Q-Learning 与 SARSA 的更新差异
- 根据环境特性选择规划或决策方法
问题与直觉
一个配送配送员接了一单:从 A 点取餐,送到 B 点,途经三个路口。他有两种「智慧」:规划——出发前想好「先去 A,再去 B,中间走哪条路」;决策——等红灯时看到绿灯变亮,立刻决定「踩油门走」。前者是长期方案,后者是即时选择。智能体同样需要这两样:没有规划,只会走一步算一步;没有决策,计划再完美也执行不到现实中。
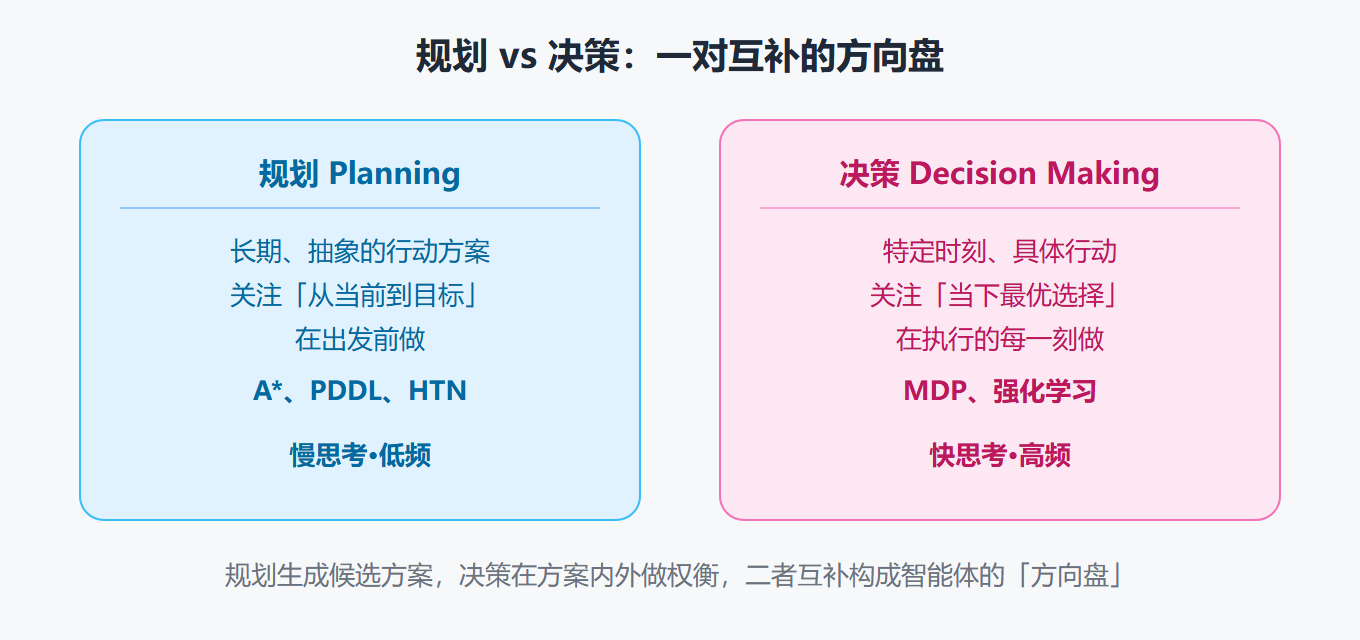
SOUCE 原文给了一个更本质的区分:规划侧重于制定长期的、抽象的行动方案,关注如何从当前状态到达目标状态;决策侧重于在特定时刻、特定环境下选择具体的、即时的行动,关注如何在当前情境下做出最优选择。 规划发生在「去执行之前」,决策发生在「执行的每一刻」。二者互补——规划生成候选方案,决策在方案内部及方案之间做权衡。
核心原理
经典规划
经典规划面向确定性、完全可观测的环境,用符号化表示描述状态、行动、目标,再靠搜索找行动序列。
- STRIPS:最经典的规划语言,用**前提条件(Preconditions)和效果(Effects)**描述行动。比如「拿起杯子」这个行动,前提是「手空着、杯子在桌上」,效果是「手拿着杯子、桌上没有杯子」。状态和目标用逻辑谓词表示。
- PDDL:STRIPS 的标准化扩展,支持类型、函数、量词等更丰富的特性,是今天规划竞赛的标准语言。
- 状态空间搜索:把规划问题看成「在状态空间里找路径」。常用 A*、Dijkstra、启发式搜索。A* 用评估函数 f = g + h:g 是已走的实际代价,h 是到目标的估计代价(启发式),优先扩展 f 最小的节点。h 设计得好,搜索快得不止一个量级;h 过估(不满足可采纳性)会得到次优解。
SOUCE 给出的 A* 实现用曼哈顿距离做启发式:
import heapq def heuristic(node, goal): return abs(node[0]-goal[0]) + abs(node[1]-goal[1]) # 曼哈顿距离 def a_star_search(start, goal, neighbors_func): open_set = [(heuristic(start, goal), start)] came_from = {} g_score = {start: 0} while open_set: _, current = heapq.heappop(open_set) if current == goal: return reconstruct_path(came_from, current) for neighbor in neighbors_func(current): tentative = g_score[current] + 1 if neighbor not in g_score or tentative < g_score[neighbor]: came_from[neighbor] = current g_score[neighbor] = tentative heapq.heappush(open_set, (tentative + heuristic(neighbor, goal), neighbor)) return None
heapq 优先队列保证每次都扩展 f 最小的节点;came_from 记录前驱用于回溯路径。SOUCE 用 5×5 网格、障碍物 (2,2),(2,3),(3,2) 测试,从 (0,0) 到 (4,4) 能成功找到路径。注意 reconstruct_path 要在循环外定义,从目标回溯到起点再反转。
不确定性环境下的决策:MDP 与强化学习
现实环境充满不确定性——感知有噪声、行动结果不确定。这时用 MDP 建模。MDP 五要素:状态集合 S、行动集合 A、转移概率 P(s'|s,a)(在状态 s 执行动作 a 到 s' 的概率)、奖励函数 R(s,a)、折扣因子 γ(权衡即时与未来奖励,0 到 1 之间)。「马尔可夫」意味着未来状态只依赖当前状态,与过去无关。
求解 MDP 的两条路:动态规划(知道环境模型,直接算最优策略)和强化学习(不知道模型,靠试错学策略)。强化学习的代表算法:
- Q-Learning:学习状态-行动价值函数 Q(s,a)。更新公式:
Q(s,a) ← Q(s,a) + α·[R + γ·max_a' Q(s',a') − Q(s,a)]。注意 max 取的是「理论上最优动作」的 Q 值——它不依赖实际执行的动作,所以是 off-policy(学的是最优策略,不管现在怎么走)。 - SARSA:更新公式用实际执行的动作:
Q(s,a) ← Q(s,a) + α·[R + γ·Q(s',a') − Q(s,a)],是 on-policy(学的是当前策略下的价值)。两者区别在「下一步用的是理想动作还是真实动作」。Q-Learning 更激进、收敛快但方差大;SARSA 更保守、对风险敏感。在「走错一步会翻车」的环境里 SARSA 反而更安全——它会学到避开危险区域。
SOUCE 用自定义 GridWorld 环境训练了 Q-Learning:网格 5×5,障碍物三个,每步惩罚 −1,到达目标奖励 +10。exploration_rate=0.1 控制探索(随机动作)与利用(Q 最大动作)的平衡,1000 轮 episode 后 Q 表收敛,用贪心策略测试能走到目标。这个「训练 + 测试」的两段式结构是强化学习的标准流程。
这里有个初学者最容易困惑的问题:Q 表到底存了什么?它是一个二维数组,行是状态(网格位置编号),列是动作(上/下/左/右),单元格存「在这个状态做这个动作的长期价值估计」。训练前全是 0,训练过程中每走一步就按更新公式修正一次。训练完成后,查表选「当前状态下 Q 值最大的动作」就是最优行为。SOUCE 用 np.ravel_multi_index 把二维坐标压成一维索引——这是表格型强化学习的惯用技巧,把「状态」翻译成「表行号」。当状态空间大到表装不下(比如连续坐标),第 6 章的函数逼近方法才登场,Q 表让位给神经网络。
分层规划
经典规划在复杂任务上会爆炸——状态空间太大、搜索太慢。分层规划把复杂问题拆成多级:高层做抽象规划,低层做具体执行。SOUCE 里 HTN(层次任务网络)是代表:顶级目标「准备晚餐」拆成抽象任务「买菜、做饭、摆桌」,每个抽象任务再拆成子任务,最终落到具体动作序列。这种「先粗后细」的结构跟人做事的思路一致,也让规划器能在更大空间里工作。第 6 章强化学习进阶里的层次化强化学习(HRL)是同一思路的深度学习版。
工程实践要点
规划与决策的分工对比
规划 vs 决策的方法选型
| 环境特征 | 方法 | 关键点 |
|---|---|---|
| 确定、完全可观测 | 经典规划(A*/PDDL) | 状态空间小才能搜索 |
| 确定、未知规则 | 模型学习 + 规划 | 先学转移函数再规划 |
| 随机、模型已知 | 动态规划/值迭代 | 直接解 MDP |
| 随机、模型未知 | 强化学习 | 试错学策略 |
| 连续状态/动作 | 深度强化学习 | 函数逼近(第 6 章) |
| 任务可分层 | 分层规划/HTN | 抽象层减少搜索空间 |
选型铁律:状态空间小且规则明确,用经典规划;规则未知或状态空间巨大,用强化学习。 规划要求「你懂环境」,强化学习要求「你能交很多学费」。前者适合工业界预算有限的项目,后者适合科研和模拟场景。
这张表还能再压成一句话:问题难度决定方法深度,方法深度决定算力与数据需求。A* 只需要一张图和启发式函数,CPU 秒级出解;Q-Learning 需要上千轮交互,但能啃下 A* 摸不着的随机环境;深度强化学习需要 GPU 和百万级样本,但能处理图像、连续动作这类高维空间。做项目时从最便宜的方法开始——很多任务 A* 或简单规则就够,别一上来就搬深度学习,那是用大炮打蚊子,且大炮还未必瞄得准。
⚠️ 常见坑:奖励函数设计不当。SOUCE 的 GridWorld 里每步 −1、到达 +10 是精心配的——如果只设「到达 +10」不设步长惩罚,智能体可能原地打转刷奖励。奖励稀疏又容易学不动。设计奖励时先想「什么行为是被鼓励的」,再想「怎么防止钻空子」。
💡 关键直觉:折扣因子 γ 是「眼光长短」旋钮。γ 接近 1,智能体看重长远收益,适合长期任务;γ 接近 0,智能体只看眼前奖励,适合即时反馈任务。这个旋钮调对了,学习效率差很多。
从规划到决策的闭环
实际智能体把规划和决策串成一个闭环:规划器在高频度较低的时间尺度上生成方案(比如每几秒重规划一次路径),决策器在每帧高频选择具体动作(比如每毫秒选一次油门刹车)。SOUCE 的图「推理与决策流程」展示的正是这个层级:感知结果→知识库→推理→目标→决策模型→行动方案→执行器→环境。理解这个闭环,就理解了为什么很多智能体系统把「慢思考」(规划)和「快反应」(决策)分开跑——两者时间尺度不同,耦合在一起性能必炸。这个「快慢分层」在自动驾驶、游戏 AI、机器人里都是标配,第 3 章架构设计会专门展开。
规划与决策的边界问题
规划与决策之间有条模糊地带,值得点破。有些「决策」其实是很短的「规划」——比如连续动作空间里每一步的油门值选择,本质是「在一个无穷大的动作空间里搜索」;而有些「规划」也只是「长程决策」——比如把「走哪条路」看成「在路线集合里做一次大决策」。工程上别纠结名分,关心两件事就行:搜索深度(要展望几步)和动作空间大小(每次要选多少个候选)。深度深、候选多,用分层或学习;浅而小,用搜索或规则。这就是本节所有方法背后的统一标尺。
还有一个常被忽视的工程点:重规划。真实环境动态变化,出发前做好的计划执行到一半就可能失效——路被堵了、目标变了、队友改主意了。所以生产系统里的规划器几乎都带「再规划」能力:定期检查计划是否仍可行,不行就重新规划。SOUCE 的经典规划流程「起始状态→判断是否目标→否→生成后继→评估→选最优→再判断」本质就是一个「规划—校验—再规划」的循环,只是循环频率要按环境动态性调:环境越动态,重规划越频繁,成本也越高。
探索与利用的平衡
强化学习里有个贯穿始终的张力:探索(试新动作,可能发现更好策略)vs 利用(用已知最好的动作,稳稳拿奖励)。SOUCE 的 epsilon-greedy 是处理这个张力的最简方案:以 ε 概率随机动作(探索),以 1−ε 概率选 Q 最大的动作(利用)。训练早期 ε 大,智能体到处乱逛收集信息;训练后期 ε 衰减到很小,智能体专注用学到的知识。exploration_decay_rate=0.001 这种衰减参数就是「什么时候从好奇转为熟练」的开关。
这个平衡在规划里同样存在——经典规划里的「放宽约束先粗搜,再精搜」本质也是先探索粗空间再利用细结果。而第 6 章讲到的 Noisy Networks、好奇心驱动等,都是在用更聪明的方式管理探索。现在只需记住:不探索,智能体永远停在已知坏方案;只探索,智能体永远到不了目标。 所有成熟的智能体都在这两个极端之间找平衡点。
要点串联
- 区分:规划是长期方案,决策是当下选择,二者互补构成方向盘
- 经典规划:STRIPS/PDDL 用前提条件+效果描述行动,A* 用 f=g+h 搜索
- MDP 五要素:状态、动作、转移概率、奖励、折扣因子
- Q-Learning vs SARSA:off-policy 学最优 vs on-policy 学当前策略
- 分层规划:先粗后细,HTN 是代表
- 选型铁律:懂环境用规划,环境未知用强化学习
- 闭环:慢规划 + 快决策分层运行,时间尺度不同别耦合
决策方案有了,下一节讲智能体怎么「越用越聪明」——学习与进化。