4.3 智能体性能评估
4.3 智能体性能评估
本节摘要:怎么知道智能体「造得好不好」?本节先讲性能评估的五重角色(验证、优化、比较、监控、信任),再拆四个评估维度(功能、性能效率、用户体验、可靠鲁棒)与各类任务的关键指标,接着给六种评估方法,最后用分类智能体的完整评估代码(准确率/精确率/召回率/F1/AUC/混淆矩阵)演示「指标怎么算、结果怎么读」。
上手前先明确
阅读完本节,你应当能够:
- 说出性能评估在智能体生命周期中的五重角色
- 按任务类型选择正确的评估指标(分类/回归/对话/推荐/强化学习)
- 区分精确率与召回率,并解释两者的权衡
- 说出六种评估方法及各自适用场景
- 用 scikit-learn 跑一遍分类智能体的完整评估
问题与直觉
「我的智能体很智能」是主观感觉,「问题解决率 82%、平均处理时长 1.8 分钟」是客观事实。生产环境里,后者才能支撑决策——该不该上线、该不该加预算、用户投诉该往哪查。SOUCE 把性能评估定位成「开发生命周期中的多重角色」,其中最关键的是:它告诉你「改进了没」。没有评估,算法优化就是蒙眼开车——改了十版,不知道哪版变好了。
评估还有一个反直觉的作用:建立用户信任。SOUCE 说「透明的性能评估报告能帮助用户了解智能体的能力范围」。一个敢把「准确率 91%、但遇到 X 类输入会误判」写清楚的系统,比吹「100% 智能」的系统更可信。本节的核心技能是「读得懂指标、选得对指标」——指标选错,评估报告再漂亮也是自欺欺人。
核心原理
评估的四个维度
SOUCE 把评估分成四个维度,各有侧重:
1. 功能性评估:任务完成度(完成指定任务的比例)、目标达成率(是否达到预设目标)、功能覆盖率(实现的功能占预设功能的比)。适合任务导向型智能体。
评估维度的任务匹配矩阵
2. 性能效率评估:分类的准确率/精确率/召回率/F1/AUC;回归的 MSE/MAE;加上延迟、吞吐量、资源利用率。这一维度回答「跑得准不准、快不快、省不省」。
3. 用户体验评估:用户满意度、参与度、易用性、可解释性、公平性。面向用户的智能体(客服、助手)必须评估这维度——算法指标好看但用户觉得难用,一样失败。
4. 可靠性与鲁棒性评估:稳定性、容错性、鲁棒性(抗噪声、抗对抗攻击)、可扩展性。生产系统的生死线,也是第 6 章安全伦理的评估版。
这四个维度不是「都要上」的清单,而是「按生命周期配重」的框架:早期验证重功能与性能效率(算法有没有用),中期加入用户体验(人用起来顺不顺),上线前必须过可靠性鲁棒性(能不能扛住生产环境),长期持续监控所有维度。SOUCE 的「监控与维护」角色正是第四个维度的日常化——部署后的性能退化检测(比如数据分布漂移导致准确率下滑),靠的就是持续盯着可靠性和性能指标。
延迟与吞吐量的工程含义
性能效率维度里,延迟和吞吐量值得单独说——它们是「算法指标好看、系统跑不动」的典型坑位。延迟是单次任务/响应的耗时;吞吐量是单位时间处理的任务数。两者关系微妙:吞吐量高不等于延迟低——批量处理可以大幅提高吞吐,但单个请求要排队等,延迟反而更高。SOUCE 把延迟和吞吐量并列列出,正是提醒它们各有适用:实时交互系统(对话、自动驾驶)重延迟,离线批处理系统(数据处理、批量生成)重吞吐量。测量时还要注意「百分位而非平均」——平均延迟被几个超慢样本拉高/拉平,看 P95/P99(95%/99% 分位延迟)才能反映真实体验。
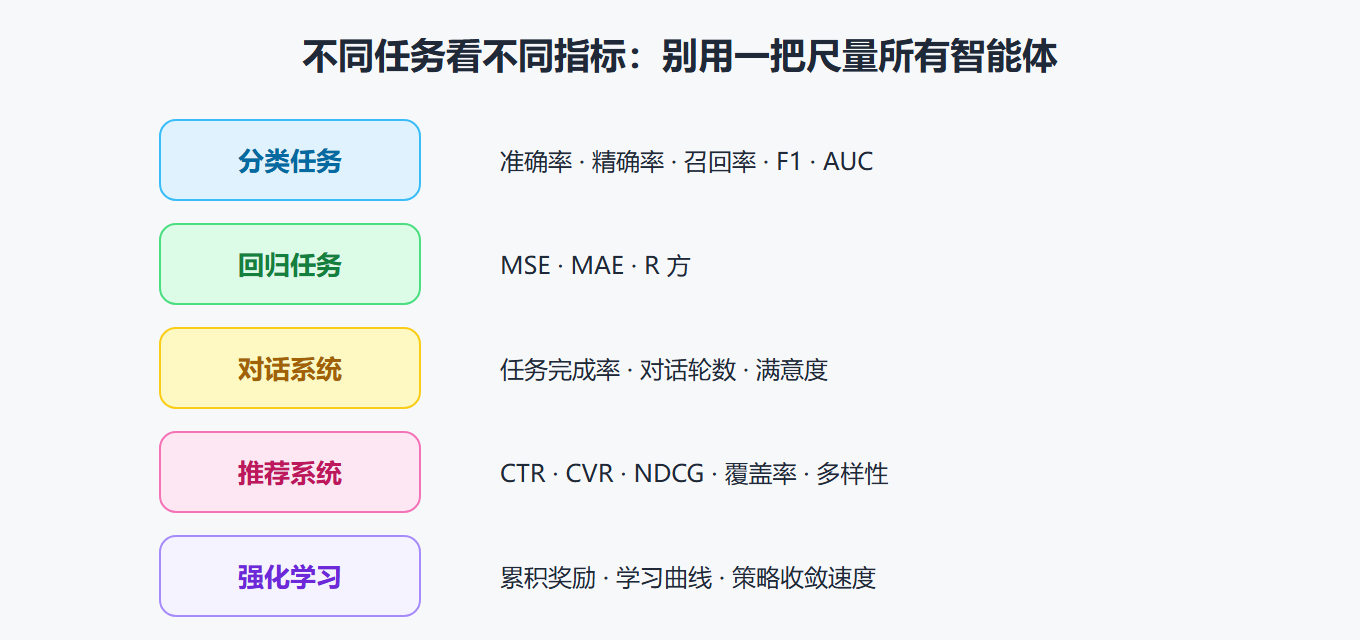
各类任务的关键指标
SOUCE 给了非常实用的「按任务选指标」清单:
| 任务 | 关键指标 |
|---|---|
| 分类 | 准确率、精确率、召回率、F1、AUC、混淆矩阵 |
| 回归 | MSE、MAE、R 方 |
| 对话系统 | 任务完成率、对话轮数、满意度、流畅度、连贯性 |
| 推荐系统 | 点击率 CTR、转化率 CVR、NDCG、MAP、覆盖率、多样性 |
| 强化学习 | 累积奖励、学习曲线、探索率、策略收敛速度 |
注意推荐系统专门有「覆盖率、多样性」这类指标——推荐引擎如果只推热销品,点击率可能不错,但用户体验和长尾商业价值都完蛋。这提示:指标选择本身就是价值观选择——你重视什么,就考核什么,智能体就会朝什么优化。
精确率与召回率:一对天生的冤家
SOUCE 用了大篇幅讲这对指标,值得吃透。精确率(Precision)= TP/(TP+FP):预测为正例的样本里,真有多少是对的——「我说是垃圾邮件的,真的垃圾吗」。召回率(Recall)= TP/(TP+FN):真正例里被找出来多少——「真正的垃圾邮件,我抓到了几成」。
两者天然冲突:想提高精确率,就得更保守,只把最有把握的判为正例——结果漏掉不少真的正例,召回率下降。想提高召回率,就得更激进——误伤负例,精确率下降。SOUCE 给了两个直观场景:垃圾邮件检测重精确率(别把正常邮件误删了),疾病诊断重召回率(别漏诊病人)。F1 是两者的调和平均,用一指标综合两者。在类别不平衡的数据上(垃圾邮件 1%、正常 99%),准确率会骗人——全判正常也有 99% 准确率,但一个垃圾邮件都没拦住,这时必须看精确率/召回率/F1/AUC。
工程实践要点
分类智能体的完整评估代码
SOUCE 用逻辑回归垃圾邮件分类器演示了完整评估:
import numpy as np from sklearn.model_selection import train_test_split from sklearn.linear_model import LogisticRegression from sklearn.metrics import (accuracy_score, precision_score, recall_score, f1_score, roc_auc_score, confusion_matrix, classification_report) X = np.random.rand(1000, 10) y = np.random.randint(0, 2, 1000) X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42) model = LogisticRegression() model.fit(X_train, y_train) y_pred = model.predict(X_test) y_prob = model.predict_proba(X_test)[:, 1] print(f"准确率: {accuracy_score(y_test, y_pred):.4f}") print(f"精确率: {precision_score(y_test, y_pred):.4f}") print(f"召回率: {recall_score(y_test, y_pred):.4f}") print(f"F1: {f1_score(y_test, y_pred):.4f}") print(f"AUC: {roc_auc_score(y_test, y_prob):.4f}") print("混淆矩阵:\n", confusion_matrix(y_test, y_pred)) print(classification_report(y_test, y_pred))
这个示例用了随机数据,所以各项指标都在 0.5 附近——SOUCE 特意保留这个「不好看」的结果,就是提醒读者:看到指标先想「这个结果有没有意义」,别急着欢呼。随机数据都能跑出 0.51,那模型可能压根没学到东西。真实项目里对照随机基线(baseline),是评估的第一步。
六种评估方法
SOUCE 列的六种方法各有定位:基准测试(标准数据集对比,客观可复现)、用户研究(真实用户试玩,反映真实体验)、A/B 测试(线上分流对比版本,适合迭代优化)、模拟环境评估(降成本、测极端场景,自动驾驶标配)、专家评估(领域专家主观评价,看创新性和专业度)、自动化评估(脚本批量跑,支持 CI/CD 持续集成)。
| 评估目标 | 首选方法 |
|---|---|
| 初步验证 | 基准测试、自动化评估 |
| 用户体验 | 用户研究、A/B 测试 |
| 复杂/危险场景 | 模拟环境评估 |
| 创新性/专业度 | 专家评估 |
| 持续监控 | 自动化评估 |
SOUCE 特别提到「自动驾驶智能体可以在模拟驾驶环境中进行大量测试」——这正是模拟评估的价值:真实路上跑一百万公里既危险又费时,模拟环境里可以安全地、廉价地、可控地复现极端场景(暴雨、突发障碍、传感器故障)。这也是为什么第 1.2 节把「安全性」列为仿真环境的优势之一。
⚠️ 常见坑:用单一指标下结论。准确率高但召回率崩了、延迟低但准确率掉了——单指标都会掩盖另一面。SOUCE 的建议是「多维度、多指标」一起看,再配混淆矩阵定位具体错误类型。
💡 关键直觉:评估指标不是「越高越好」,而是「和你的业务目标对齐」。客服智能体把「解决率」从 60% 提到 80%,比把「响应速度」从 1 秒压到 0.5 秒更有价值。先定业务上最重要的 1-2 个北极星指标,再配辅助指标,别被指标表淹没。
评估流程与报告
SOUCE 的评估流程图给了标准动作:定义评估目标与指标 → 准备评估数据集 → 选择评估方法 → 执行评估实验 → 分析评估结果 → 撰写评估报告。这个流程里最容易被跳过的「分析结果」一步,恰恰是最有价值的——指标数字只是表象,要能回答「好在哪里、差在哪里、为什么差」。评估报告的定位是「为后续决策提供依据」:上线与否、优化方向、预算分配,都从报告里来。SOUCE 强调「持续监控能及时发现性能退化」——评估不是上线前的一次性动作,而是跟着智能体终身走的。
数据质量与评估可信度
「评估结果可信吗」这个问题,答案大半取决于数据集质量。SOUCE 提醒「数据集的质量和代表性直接影响评估结果的可靠性」——但提醒得温和了,实际影响是致命的:测试集跟训练集来自同一分布且都在模拟环境里,评估再好看,到真实世界照样翻车。工程上保证可信度的三件事:分布匹配(测试集要覆盖真实使用的输入分布,包括长尾场景)、数据新鲜(业务在变,旧测试集要定期重采)、避免污染(训练数据混进测试集是评估作假的头号来源——模型「见过」测试题,分数自然高)。这三件事做不好,评估就是给决策喂错数据。
评估的自动化与进化
SOUCE 的展望部分提到评估自身也在进化:智能体越来越复杂(多智能体、AGI),需要更全面的评估;环境越来越动态,需要更强的鲁棒性评估;伦理、公平性、透明度成为新维度;评估本身也在 AI 化——用自动化、智能化的评估工具提高评估效率。这意味着「评估」不是学一次就够的静态技能,而是跟着智能体技术一起进化的动态能力。做评估时保持「我的指标还够用吗」的自问,比固守一套指标更安全。
这里特别提一下「评估对象是智能体不是模型」这个视角。第 2 章的五大能力、第 3 章的多智能体协作,评估时要分开测:感知模块单独测感知指标,决策模块单独测决策指标,整体再测端到端任务指标。SOUCE 的案例评估(客服看意图识别准确率和对话轮数)正是这种「分模块 + 端到端」的组合。只测端到端指标,出了问题不知道卡在哪个模块;只测模块指标,又不知道整体协作有没有崩。两层都要,评估才真正「定位问题」而不是「宣布结果」。
温故知新
- 五重角色:验证、优化、比较、监控、建立信任
- 四维度:功能、性能效率、用户体验、可靠鲁棒
- 延迟看百分位:P95/P99 比平均值更能反映真实体验
- 指标匹配:分类看 P/R/F1/AUC,对话看完成率/轮数,推荐看 CTR/NDCG/覆盖率
- 精确率 vs 召回率:保守换精确、激进换召回,F1 调和平均
- 六方法:基准、用户研究、A/B、模拟、专家、自动化
- 先看基线:随机基线跑出 0.51,说明模型可能没学到东西
- 北极星指标:先定业务上最重要的 1-2 个,再配辅助指标
- 评估终身化:上线前评估 + 上线后持续监控
- 分模块+端到端:两层都测,评估才能定位问题
评估方法论齐了,下一节用三个完整案例把它们串起来——案例研究。