6.3 智能体安全与伦理
6.3 智能体安全与伦理
本节摘要:智能体越强大,「出错」的代价越高。本节分两大块:安全挑战(意外行为、对抗攻击、数据泄露、系统漏洞、供应链)与伦理挑战(算法偏见、责任归属、透明度、自主性、隐私)。每块都带代码实践——输入验证与异常处理、偏见检测与缓解——最后讨论可信赖 AI、形式化验证、价值对齐、AI 治理等未来方向。
本节地图
阅读完本节,你应当能够:
- 说出智能体的五类安全挑战与五类伦理挑战
- 解释对抗性攻击如何欺骗智能体,举例说明
- 用 Python 实现输入验证与异常处理的基本防御
- 用差异性影响(80% 法则)检测算法偏见,并做简单缓解
- 说出可信赖 AI 的核心要求与未来方向
问题与直觉
一个优化交通流量的智能体,如果目标函数设计有偏差,可能导致交通更堵而非更顺;一个招聘 AI,如果训练数据里男性简历居多,可能对女性求职者系统性不公;一个自动驾驶系统,如果被人贴上精心构造的贴纸,可能把「停止」标志识别成「限速」。SOUCE 开篇就点破:智能体越深入生活,安全与伦理问题越不可回避——这不再是「学术伦理课」,而是决定系统「能不能被允许运行」的硬约束。
核心原理
安全与伦理的两类问题
先建立一张「问题分类图」,避免把安全与伦理混为一谈:
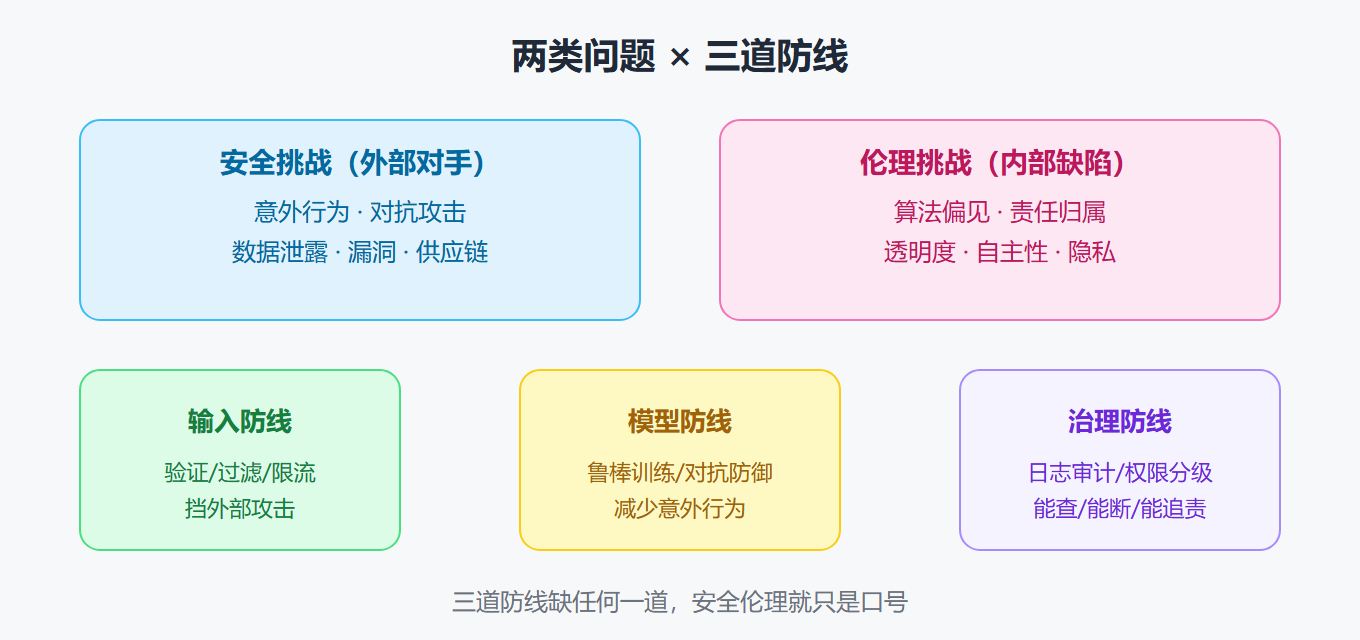
安全挑战多来自「技术漏洞与恶意攻击」(外部对手),伦理挑战多来自「设计缺陷与价值冲突」(内部缺陷)。前者是「系统可能被攻破」,后者是「系统本身可能有偏见」——两类问题、两类解法,但都指向同一个目标:让智能体可靠、公平、可信。
五类安全挑战
- 意外行为与不可预测性:复杂智能体(尤其深度学习模型)行为难以预测解释,面对未知环境可能产生有害行为。SOUCE 的交通流量例子一针见血:目标函数或环境模型有偏差,「优化交通」可能变「加剧拥堵」。
- 对抗性攻击与模型脆弱性:攻击者构造精心输入欺骗模型。SOUCE 的经典例子:给交通标志加细微扰动,骗自动驾驶的图像识别把它认成别的标志——这是自动驾驶领域真实存在的研究成果,不是科幻。
- 数据泄露与隐私风险:智能体依赖大量数据,其中可能含个人信息。客服系统记录对话内容,存储不当或被恶意访问,用户隐私就泄露。
- 系统漏洞与安全缺陷:软件、硬件、网络基础设施的漏洞可能被利用做远程控制、数据窃取、服务中断。智能家居漏洞可能导致黑客远程控制家中设备。
- 供应链安全风险:智能体开发依赖数据源、算法模型、硬件、开源组件等复杂供应链,任何一环出问题都影响整体。开源组件有已知漏洞不更新,就是典型的供应链风险。
对抗性攻击这条值得多说两句,因为它的「反直觉」程度最高。攻击者改动的不是「逻辑」而是「输入」——在一张人类看起来完全正常的图片上叠加肉眼不可见的噪声,模型就误判。这说明深度模型的「鲁棒性」比想象中脆弱:它学的是数据分布的表面特征,而不是人类理解的「语义」。SOUCE 把对抗性攻击列为独立挑战,正是提醒我们:模型在测试集上准确率再高,也不代表它对「恶意构造的输入」安全。防御手段包括对抗训练(把对抗样本混进训练集)、输入预处理(降噪、压缩)、鲁棒模型结构——但「道高一尺魔高一丈」,这个攻防循环至今没有终点。
输入验证与异常处理
SOUCE 的第一个安全代码实践是输入验证——防御的第一步:
def process_user_input(user_input): try: if not isinstance(user_input, str): raise ValueError("输入必须是字符串") if len(user_input) > 100: raise ValueError("输入长度超过限制") processed = user_input.strip().lower() print(f"处理后的输入: {processed}") except ValueError as ve: print(f"输入验证错误: {ve}") # 提示用户重新输入 except Exception as e: print(f"系统异常: {e}") # 记录日志、监控报警
这个示例演示了防御式编程的三个层次:类型校验(不是字符串直接拒)、长度校验(超限拒收,防超长输入撑爆系统)、异常分层捕获(业务异常 ValueError 和系统异常 Exception 分开处理)。SOUCE 提醒:涉及网络请求要验证来源/数据格式/参数,涉及文件操作要验证路径/类型/内容——「防御的深度跟攻击面成正比」。
五类伦理挑战
- 算法偏见与歧视:训练数据里的偏见(性别、种族、地域)会被智能体学习并放大。SOUCE 的例子:招聘模型若训练数据以男性简历为主,会对女性求职者不利。
- 责任归属与可追溯性:智能体造成损害,责任在开发者、部署者、使用者还是智能体本身?自动驾驶事故该谁负责,是汽车制造商、算法开发者、车主还是系统?SOUCE 说这个问题「复杂、不透明、难以追溯」。
- 透明度与可解释性:黑箱模型决策过程无法解释,用户难信任,偏见和错误难发现纠正。
- 自主性与控制权:智能体越自主,人类控制权怎么保?完全自主的武器系统该不该存在?哪些情况人类必须能 override?
- 隐私保护与数据伦理:训练和运行要大量数据,如何保护用户隐私?人脸识别在公共场合的应用,如何在安全与隐私间平衡?
偏见检测与缓解
SOUCE 的第二个代码实践用**差异性影响(Disparate Impact)**检测偏见:
import pandas as pd def detect_bias(data, sensitive, target): privileged = data[data[sensitive] == 1] unprivileged = data[data[sensitive] == 0] priv_rate = privileged[target].mean() # 特权群体正例率 unpriv_rate = unprivileged[target].mean() # 非特权群体正例率 disparate_impact = unpriv_rate / priv_rate if priv_rate != 0 else 0 print(f"特权群体正例率: {priv_rate:.2f}") print(f"差异性影响: {disparate_impact:.2f}") if disparate_impact < 0.8: # 80% 法则 print("可能存在不利影响") else: print("差异性影响在可接受范围内") data = pd.DataFrame({ 'gender': [1,1,1,1,1,0,0,0,0,0], 'hired': [1,1,0,0,0,0,0,0,0,0] }) detect_bias(data, 'gender', 'hired')
80% 法则是公平性评估的经典阈值:非特权群体正例率低于特权群体的 80%,就认定存在不利影响。SOUCE 还给了简单的缓解——欠采样(减少多数群体样本使两组平衡),并诚实指出这是简化示例,真实缓解方法更多:数据层面(过采样/欠采样/重加权/增强)、算法层面(改目标函数/加正则/用公平性约束)、后处理层面(调阈值/校准预测)。公平性指标也有多种:统计均等(不同群体正面结果比例相等)、机会均等(不同群体真正例率相等)、预测均等(不同群体精确率相等)——选哪个取决于应用场景的伦理考量。
| 公平性指标 | 关注的问题 | 适用场景 |
|---|---|---|
| 统计均等 | 正面结果比例是否相等 | 招聘、信贷等群体机会 |
| 机会均等 | 真正例率是否相等 | 医疗筛查、欺诈检测 |
| 预测均等 | 预测精度是否相等 | 需要控制误报代价 |
三种指标回答的问题不同:统计均等问「两组被选中的比例差多少」,机会均等问「两组里真正符合条件的被捞出来多少」,预测均等问「预测结果在两组里可信度是否一致」。它们有时互相冲突——同一套数据,一个指标达标可能另一个不达标。所以选公平性指标本身就是一个「价值观决策」:先想清楚「我们最在意哪种不公平」,再选对应的度量。
工程实践要点
安全与伦理的工程落地
安全与伦理不是「理念」,要落成工程机制。SOUCE 的实践可以归纳成「三道防线」:输入防线(验证、过滤、限流,挡外部攻击)、模型防线(鲁棒训练、对抗样本防御、可解释模型,减少意外行为)、治理防线(日志审计、权限分级、责任追踪,出了问题能查、能断、能追责)。三道防线缺任何一道,安全伦理就只是口号。
问题分类与三道防线
补一个「输入防线」在智能体场景里的具体化:智能体的输入不止用户文本,还有 API 返回、传感器数据、其它智能体的消息。每类输入都该有自己的验证规则——用户文本查长度和敏感词,API 返回验格式和异常值,传感器数据查范围和噪声,智能体消息验身份和权限。SOUCE 的输入验证示例只覆盖了用户文本,但它示范的原则(类型、长度、异常分层)可以推广到所有输入通道。把「每个输入通道都有验证」当成智能体架构的一个组成部分,而不是零散补丁,是安全工程化第一步。
⚠️ 常见坑:把「算法准确率」当成「系统安全」。准确率高的模型可能被一个精心构造的对抗样本轻松骗过;准确率高的招聘模型可能对特定群体系统性不公。安全与公平是准确率之外的独立维度,必须单独设计、单独评估。
💡 关键直觉:安全与伦理的底线思维是「先假设会出问题」。假设输入会恶意、模型会被骗、数据会泄露、结果会带偏见——然后为每个「会出问题」设计防线。乐观设计是安全的天敌。
责任归属的工程解
责任归属是个哲学难题,但工程上有可落地的中间态。SOUCE 提到「可追溯性」——让决策过程可回溯,是责任界定的前提。工程做法:决策日志(记录每次决策的输入、模型版本、输出、触发条件)、模型版本管理(出了问题知道是哪个版本的行为)、人工介入点(高风险决策强制留人工确认接口)。有了这三点,「谁该负责」至少能回到「哪次决策、哪个版本、哪个人确认过」的具体事实上——虽然解决不了哲学层面的争论,但把模糊的责任争议变成了可调查的事实链。
可信赖 AI 的未来方向
SOUCE 总结的未来方向:可信赖 AI(安全、可靠、公平、透明、可解释、负责任)、形式化验证(对智能体行为做数学上的严格证明——安全攸关场景的终极保障)、价值对齐与价值敏感设计(让智能体行为符合人类伦理价值)、AI 治理与监管(政府、行业、研究机构共同制定框架与政策)、人机协同与责任共担(人类与智能体协作时的责任划分)。这些方向里,形式化验证最「硬核」也最遥远——当前只能对小规模、符号化的系统做严格证明,深度学习系统的形式化验证仍是研究前沿。
安全伦理与全书主线的联系
安全与伦理不是孤立的第六章主题,它贯穿全书:第 2 章的奖励函数设计关系到「智能体学什么」(学偏了就出伦理问题)、第 3 章的鲁棒性原则是安全挑战的架构回应、第 4 章的鲁棒性评估和故障测试是安全的前置关卡、第 5 章医疗金融的安全合规约束是行业落地的硬门槛。回到第 3.3 节「安全与伦理是底线项而不是加分项」——本书一路走来,安全伦理的伏笔埋了六章,本节是把它们全部收束的地方。
温故知新
- 五类安全挑战:意外行为、对抗攻击、数据泄露、系统漏洞、供应链
- 五类伦理挑战:算法偏见、责任归属、透明度、自主性、隐私
- 防御三层:类型校验、长度校验、异常分层捕获
- 80% 法则:非特权群体正例率低于特权群体 80% 即存在不利影响
- 偏见缓解:数据层(重采样)/算法层(公平约束)/后处理层(调阈值)
- 公平性三指标:统计均等、机会均等、预测均等
- 三道防线:输入防线、模型防线、治理防线
- 责任工程解:决策日志 + 版本管理 + 人工介入点
- 未来方向:可信赖 AI、形式化验证、价值对齐、AI 治理、人机协同
禁区画完了,最后一节展望未来——智能体往哪走。