6.1 强化学习进阶
6.1 强化学习进阶
本节摘要:朴素 Q-Learning 在 Atari 游戏里撑不住,DQN 用「经验回放 + 目标网络」解决了高维状态下的学习问题。本节从维度灾难出发,讲透 DQN 的两大创新与四大局限(过估计、离散动作、样本效率、稳定性),再展开策略梯度方法(REINFORCE 的直觉与实现)与 Actor-Critic(降低方差),最后给出现代强化学习的选型地图。
先说结论
阅读完本节,你应当能够:
- 解释为什么朴素 Q-Learning 在高维状态空间失效
- 说明 DQN 的经验回放与目标网络各自解决什么问题
- 说出 DQN 的四大局限与对应改进算法
- 对比价值函数方法与策略梯度方法的思想差异
- 理解 Actor-Critic 为什么能降低方差
- 根据任务类型选择现代强化学习算法
问题与直觉
第 2.3 节的 Q-Learning 用一张 Q 表记住「每个状态下每个动作的价值」,在 5×5 网格世界里完美工作。但把它扔到 Atari 游戏里就崩了——游戏画面是 210×160 像素,每个像素有多种颜色,理论上可能的「状态」数量是天文数字,Q 表根本装不下。这就是维度灾难:状态空间大到表无法枚举。
SOUCE 给出的解法思路是函数逼近:不存一张表,而是训练一个神经网络,输入状态、输出每个动作的 Q 值。深度学习负责「压缩」高维状态(画面→特征→Q 值),强化学习负责「学习策略」——两者结合就是深度强化学习(DRL)。但「直接用神经网络替换 Q 表」在实践中崩得很快,SOUCE 用 DQN 的两个关键创新点解释了为什么,以及怎么修。
核心原理
DQN 的两大创新
经验回放(Experience Replay):智能体把交互经验(状态、动作、奖励、下一状态)存进缓冲区,训练时随机采样一小批。SOUCE 解释它「打破数据之间的相关性,提高数据利用率和学习稳定性」。为什么需要它?因为相邻的经验高度相关(连续几帧画面几乎一样),直接用顺序经验训练,神经网络会被「同一画面反复教」,学得又慢又偏。随机采样让训练数据多样化,像「把一年前的事和刚发生的事混合着复习」。
经验回放还有一个常被忽略的工程红利:数据复用。在线学习里每步经验只用一次,经验回放里同一段经验可以被反复采样多次——在模拟环境(第 4.2 节讲过)里无所谓,但真实机器人(第 5.2 节)里一次交互很贵,能复用就值钱。这也是 DQN 这类「off-policy」算法(第 2.3 节讲过 off-policy 概念)在真实系统里比 on-policy 更受欢迎的原因之一——它可以回头翻旧账。
目标网络(Target Network):DQN 用两个结构相同的网络——Q 网络评估当前 Q 值,目标网络计算目标 Q 值。目标网络的参数更新频率更低。SOUCE 说这「有助于稳定学习过程,避免目标 Q 值剧烈波动」。深层原因是:如果只用同一个网络既算预测又算目标,每次更新都会「移动靶子」——目标值跟着当前网络一起变,训练目标飘忽不定,容易震荡发散。固定住目标网络,让「靶子」暂时静止,学习才稳。
可以拿「打靶」做类比:价值网络每次更新都朝「当前估的目标」迈一步,如果靶子(目标值)每步都在动,射手永远瞄不准。目标网络让靶子每隔一段时间才挪一次,射手有足够时间调整。工程上「多久复制一次权重」是超参数——太频繁等于没固定,太久则目标过时。SOUCE 的实现里每个 episode 结束复制一次,就是一个简单好用的节奏。
DQN 的最小实现
SOUCE 的 DQNAgent 用 TensorFlow/Keras 实现,核心结构(简化):
class DQNAgent: def __init__(self, state_size, action_size): self.memory = [] # 经验回放缓冲区 self.gamma = 0.99 # 折扣因子 self.epsilon = 1.0 # 探索率(会衰减) self.batch_size = 32 self.q_network = self._build_q_network() # 当前网络 self.target_network = self._build_q_network() # 目标网络 self.target_network.set_weights(self.q_network.get_weights()) def memorize(self, state, action, reward, next_state, done): self.memory.append((state, action, reward, next_state, done)) def replay(self): if len(self.memory) < self.batch_size: return minibatch = random.sample(self.memory, self.batch_size) # 随机采样 for state, action, reward, next_state, done in minibatch: target = reward if not done: target = reward + self.gamma * np.amax( self.target_network.predict(next_state)[0]) # 目标网络算目标 target_q = self.q_network.predict(state) target_q[0][action] = target self.q_network.fit(np.array(state), np.array(target_q), verbose=0) def update_target_network(self): self.target_network.set_weights(self.q_network.get_weights())
三个关键动作:random.sample 实现经验回放、target_network.predict 计算目标值(而非当前网络)、update_target_network 定期把当前网络权重复制给目标网络。SOUCE 在 CartPole-v1 上训练 500 轮,epsilon 从 1.0 按 0.995 衰减——早期疯狂探索,后期专注利用。这是「探索利用平衡」在现代算法里的标准工程化写法。
这里有个关于超参数的提醒:SOUCE 的 DQN 里 gamma=0.99、epsilon_decay=0.995、batch_size=32 这些数字是「能跑」的参数,不是「最优」参数。深度强化学习的超参数极其敏感——改一下网络层数、学习率或探索衰减,性能可能天差地别。业内有个不成文的共识:同一套超参数在 A 任务好用,不代表在 B 任务好用。所以复现 DQN 类项目时,先把 SOUCE 这类「已知可跑的配置」跑通,再谈调参——先建立基线,再优化,永远不要从零盲调。
DQN 的四大局限与改进
SOUCE 诚实列出了 DQN 的问题:过估计(Q 值被高估,噪声环境下选错动作——用 Double DQN 解耦动作选择与价值评估)、离散动作空间(连续动作只能离散化丢精度——策略梯度方法解决)、样本效率低(要大量样本——用 Prioritized Experience Replay 按重要性采样)、训练不稳定(Dueling DQN 把价值函数和优势函数分成两个分支提升稳定)。Rainbow DQN 把 DDQN、Dueling、PER、Noisy Networks 等整合进一个模型,是价值函数路线的集大成者。
工程实践要点
策略梯度:直接学策略
价值方法「先算价值、再贪心选动作」,策略梯度「直接学状态到动作的概率分布」。SOUCE 给出的核心直觉非常清楚:如果一个动作序列获得了较高回报,就增加它发生的概率;回报低,就降低概率。
REINFORCE 是最基础的策略梯度算法:采样一条完整轨迹 → 算折扣回报 → 按「回报 × 对数概率」的梯度更新策略参数。SOUCE 的 PyTorch 实现要点:
class REINFORCEAgent: def act(self, state): probs = self.policy_network.predict(state)[0] return np.random.choice(self.action_size, p=probs) # 按概率采样 def train_step(self, states, actions, discounted_rewards): # 损失 = - 折扣回报 × 对数概率,梯度上升就是最小化这个损失 loss = -tf.reduce_sum(discounted_rewards * log_probs) grads = tape.gradient(loss, self.policy_network.trainable_variables) self.optimizer.apply_gradients(zip(grads, ...))
REINFORCE 的问题是高方差——完整轨迹的回报波动大,学习不稳定。改进方向:Actor-Critic(引入 Critic 网络估计价值,作为「基线」降低方差)、A2C(用优势函数替代回报)、TRPO(限制策略更新幅度)、PPO(简化 TRPO 且性能优秀,成了当前最流行的策略梯度算法之一)。
策略梯度方法的「概率分布」还有个隐藏好处值得点透:它天然支持随机策略。围棋里同样局面可能有多种合理下法,随机策略可以输出「这步 60%、那步 40%」,比价值方法的「硬选最优」更符合真实博弈需要。另外,策略梯度输出的是分布,训练时用 softmax 保证概率和为 1、用 log-prob 保证梯度可计算——SOUCE 代码里 CategoricalCrossentropy 正是干这个的。理解了「为什么要分布」,再看策略梯度的方法论就不悬浮。
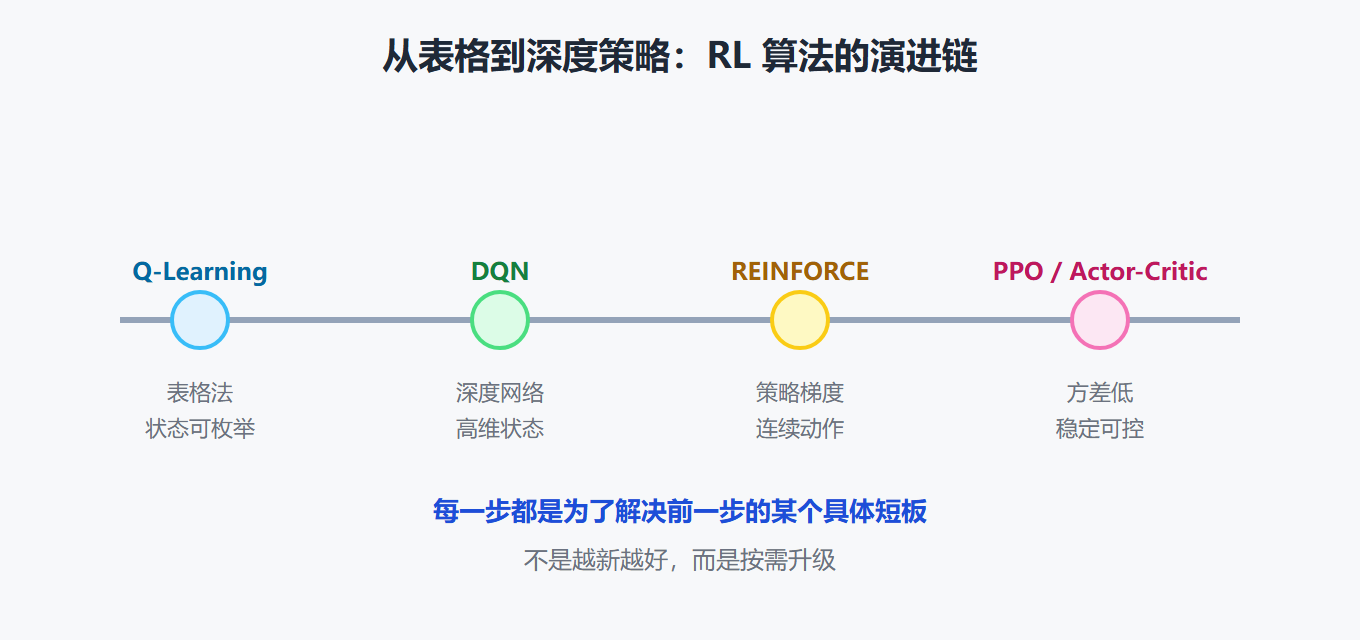
强化学习算法演进时间线
选型地图
| 问题特征 | 推荐方法 | 理由 |
|---|---|---|
| 离散动作、状态可枚举 | Q-Learning/表格式 | 简单够用 |
| 高维状态、离散动作 | DQN 及其改进 | 神经网络压缩状态 |
| 连续动作空间 | 策略梯度/PPO | 直接输出动作分布 |
| 需要稳定可控训练 | Actor-Critic 家族 | 方差低、样本效率高 |
| 追求 SOTA 性能 | Rainbow/PPO | 集大成、成熟稳定 |
这张表可以再压成一条「从简到繁」的路径:表格式 Q-Learning → 深度 Q 网络 → 策略梯度 → Actor-Critic → PPO。每一步都是为了解决前一步的某个具体短板:表装不下→上神经网络,离散装不下连续→上策略梯度,回报方差大→上基线/优势函数,更新不稳→上 TRPO/PPO 的信任区域约束。这条链不是「越新越好」,而是「按需升级」——每层有每层的适用场景,第 2.3 节的选型铁律在这里完整延续。
⚠️ 常见坑:跳过「先确认问题性质」。连续动作空间硬用 DQN、离散动作硬用策略梯度,都是「用错了武器」。选型先看两个维度——状态是高维还是可枚举、动作是离散还是连续。
💡 关键直觉:价值方法适合「动作空间有限、价值可清晰估计」,策略梯度适合「动作连续、策略本身是概率分布」。两者的分界线就是「能不能把所有动作的价值都算一遍」——算得过来用价值方法,算不过来用策略梯度。
现代 RL 的工程三件套
无论用哪个算法,三个工程习惯几乎是通用的:环境接口规范化(第 4.2 节的 Gym 规范,让算法和环境解耦,任意换算法不用改环境)、训练监控(记录每个 episode 的累积奖励和学习曲线——SOUCE 的打印语句就是最小监控,真实项目会用 TensorBoard 这类工具)、可复现性(固定随机种子、记录超参数,否则「昨天能跑通今天跑不通」会变成常态)。这三件套能救回大量「算法没问题、工程一团糟」的项目。
Actor-Critic 的直觉
Actor-Critic 名字里的两个角色正好对应它的两个网络。Actor(演员) 是策略网络,负责「表演」——根据状态输出动作;Critic(评论家) 是价值网络,负责「打分」——评估当前策略的价值。训练的循环是:Actor 表演动作 → 环境给反馈 → Critic 打分 → Actor 根据「自己动作与 Critic 评分的差距」改进表演。关键在「差距」这个词:Actor 学的不再是「整个轨迹的回报」(方差大),而是「这个动作相对平均水平的优势」(方差小)——Critic 提供的基线把「运气成分」从回报里剥离了。这也是为什么 SOUCE 说 Actor-Critic「降低了方差,提高了样本效率」:它把「好坏」从「绝对分数」变成「相对优势」,训练信号更稳定。
强化学习在智能体里的位置
回到本书主线:强化学习是第 2 章「学习与进化」能力的现代实现,是第 3 章「学习型架构」的算法核心,也是第 5 章游戏、机器人领域的主要驱动力。SOUCE 从 Q-Learning 一路讲到 PPO,实际上是给「智能体怎么在复杂环境里自己学会决策」画了一条完整的进化链。理解这条链的起点(表格方法)和终点(深度策略方法),再回头看第 2 章的基础,会有「原来如此」的贯通感。
最后给一个「何时值得上深度 RL」的现实判断。深度 RL 的训练成本高(GPU、百万级交互)、调参玄学(奖励设计、超参数敏感)、复现难。SOUCE 反复强调的「由简到繁」同样适用于此:表格方法能解决就别上 DQN,DQN 能解决就别上 PPO。判断标准是「状态空间的规模和连续性」——状态能枚举就用表,状态是高维离散就用 DQN,动作连续就用策略梯度。技术栈跟着问题走,别让问题迁就技术栈。这是全书反复出现的工程主旋律,在强化学习这个「最吃资源」的领域尤其要守住。
本章回顾
- 维度灾难:状态空间大到表装不下,用神经网络做函数逼近
- 经验回放:随机采样打破相关性,稳学习、提效率
- 目标网络:固定「靶子」,避免目标值跟着网络漂移
- 四大局限:过估计→DDQN、离散→策略梯度、样本低效→PER、不稳定→Dueling
- 策略梯度:回报高加概率、回报低减概率,直接学策略
- REINFORCE 短板:高方差,Actor-Critic 引入基线降低方差
- 选型二分:价值方法 vs 策略梯度,看「动作能否全部估值」
- 工程三件套:环境规范化、训练监控、可复现性
算法层面的「能力极限」讲完了,下一节从结构层面逼近——认知架构与通用人工智能。