1.1 大模型概述与核心特点
1.1 大模型概述与核心特点
本节摘要:大模型(Large Model)是参数规模巨大、在海量数据上预训练得到的深度神经网络,处理语言的叫大语言模型(LLM)。它的"大"同时体现在参数、数据、算力三个维度,而规模跨过临界点后出现的能力涌现,是它区别于以往一切模型的核心特征。本节从定义讲到演进脉络,帮你建立整个领域的坐标系。
阅读目标
阅读完本节,你应当能够:
- 给出大模型的准确定义,指出 LLM 与多模态大模型的关系
- 解释"大"的三重含义以及三者为什么缺一不可
- 说明能力涌现现象及其争议
- 区分少样本学习、零样本学习与在语境中学习
- 复述从词向量到多模态开源生态的关键演进节点
一、什么是大模型
先给定义:大模型是参数规模通常达到数十亿甚至数千亿、在海量通用数据上通过自监督方式预训练得到的深度神经网络。其中以文本为输入输出的叫大语言模型(LLM),如 GPT、LLaMA、GLM、Qwen;把语言与图像、音频等多种模态统一起来的叫多模态大模型。日常语境里说"大模型",多数时候指的就是 LLM。
这个定义里最值得推敲的词是"通常"。没有人规定参数过十亿才算大模型——2019 年 BERT-Large 的 3.4 亿参数在当时也被称作大模型。定义的关键不在某个阈值,而在一个现象:当参数、数据、算力的规模同时跨过某个临界点,模型会表现出小模型完全不具备的能力——不做专门训练就能翻译、写代码、做多步推理。这种量变引起质变的特征,才是"大模型"这个名称真正的含义。
换个角度理解:传统机器学习是"一个任务、一批标注数据、一个模型",模型的角色是学生,题库(训练集)决定它能学会什么。而大模型更像把整个互联网的文本当作教材先通读一遍,再针对具体任务做少量点拨。通读的阶段叫预训练,点拨的阶段叫微调或提示。范式从"教一个专项选手"变成了"培养一个通才再岗前培训"。
二、"大"的三重含义
"大"不是单指参数量。它同时体现在三个维度:
| 维度 | 量级 | 说明 |
|---|---|---|
| 参数规模 | 数十亿 ~ 数千亿 | 模型的"容量",决定能记住和组合多少知识与模式 |
| 训练数据 | TB 级、数万亿 token | 决定模型见过多少种世界的表达方式 |
| 算力 | 千卡 GPU 集群、训练数周至数月 | 把前两者兑现的工程门槛 |
三者缺一不可,而且要相互匹配。参数多但数据少,模型会过拟合,把训练集背下来而不是学会规律;数据够但参数少,模型容量不足,知识装不下;两者都够但算力不足,训练一次要一年,等于做不了。实践中这三个量大致遵循经验规律共同放大——第 4 章讲规模定律(Scaling Laws)时会展开:给定算力预算,参数量与数据量之间存在一个最优配比,盲目堆参数反而是浪费。
还有一个容易被忽略的第四维:人力工程。数据清洗流水线、分布式训练框架、故障恢复、评测体系,这些"看不见的大"往往决定一个团队能不能真正训出可用的模型。
三、核心特点
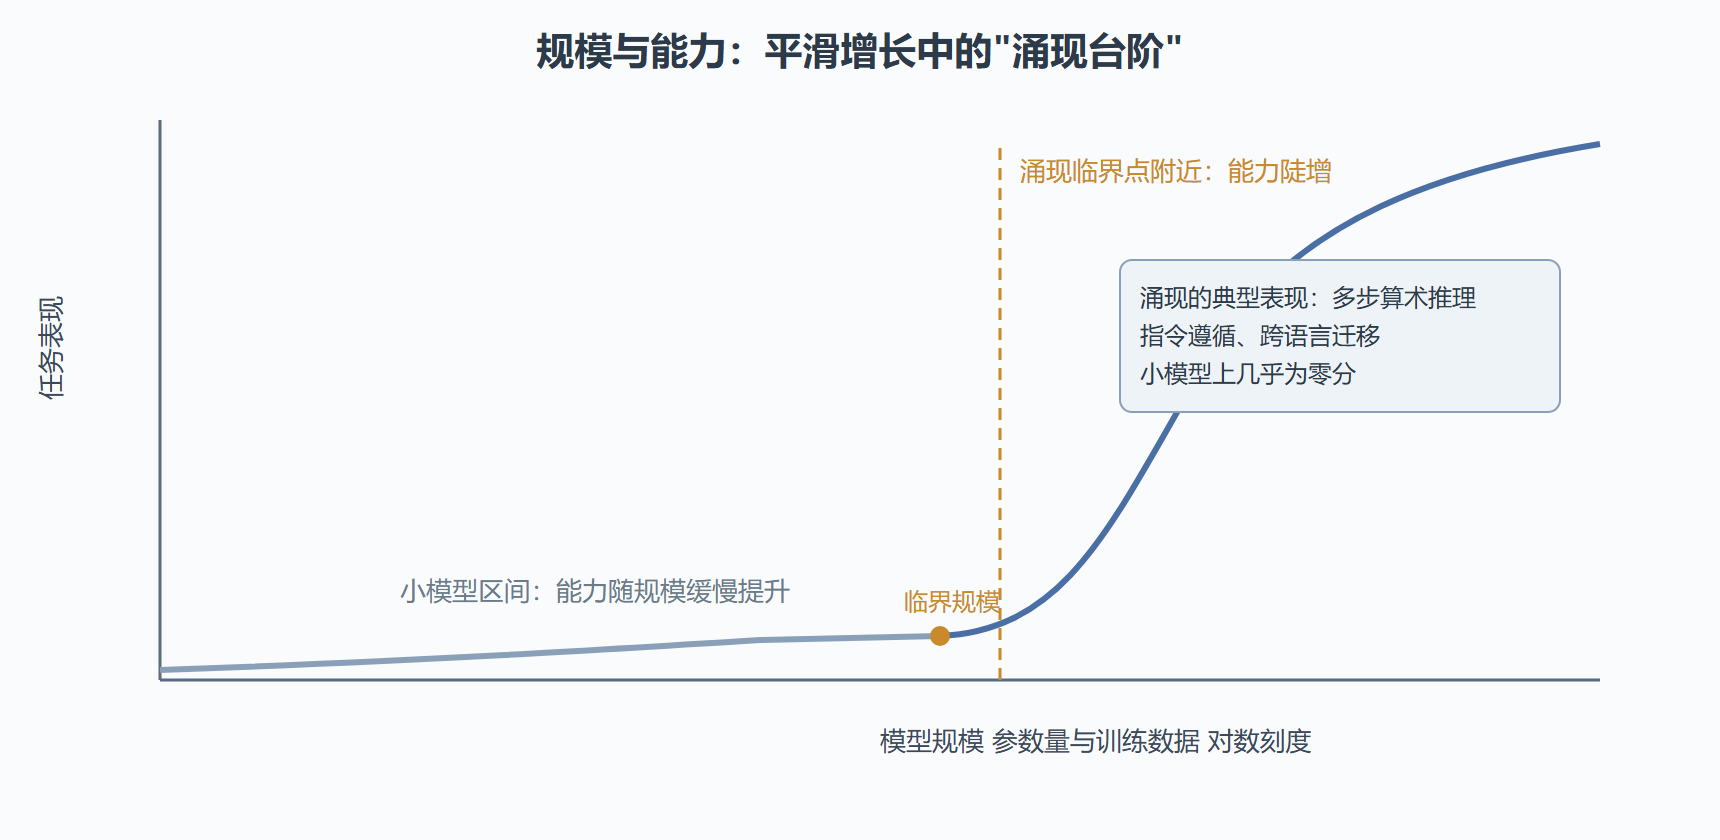
- 能力涌现(Emergent Abilities):规模过临界点后出现小模型没有的能力,如多步推理、跨任务泛化。下图直观展示了这种"阶跃"。
涌现能力示意图
- 通用性(Generalization):一个模型能做翻译、摘要、问答、写代码等大量任务,不用每个任务单独训练。这在预训练范式出现之前是不可想象的。
- 少样本 / 零样本(Few-shot / Zero-shot):给几个示例(少样本)甚至不给示例(零样本)就能完成新任务。GPT-3 论文最轰动的部分不是模型本身,而是它不用更新任何参数、只在提示词里塞几个例子就能做翻译和问答。
- 在语境中学习(In-context Learning):少样本背后的机制——把例子放进提示词,模型当场"学会"任务模式,权重全程不变。它与传统梯度更新式学习是两种完全不同的学习方式,学界至今对其机理没有定论。
- 知识压缩:预训练把海量文本中的世界知识压缩进参数,问答时再"回忆"出来。这也是幻觉问题的根源——回忆没有校对机制,知识过时或缺失时会编造。
💡 关键认知:大模型的革命性不是"更准",而是"通用"。过去做智能客服要标注几万条对话训练分类器,做摘要要再训一个模型;现在一个模型加上几段提示词全做了。评估大模型的价值,要看它替代了多少个专用系统的搭建成本。
⚠️ 别误解"涌现":涌现不是魔法,它仍来自规模与数据的量变。也有研究者指出部分"涌现"其实是度量方式造成的假象——用不连续的指标(如完全答对才算分)衡量连续提升的能力,会放大台阶感。此外不是所有能力都稳定涌现:精确算术、事实一致性、遵守字数限制这类任务,大模型至今经常翻车。
四、发展脉络:一条问题驱动的演进线
理解大模型最好的方式不是背年代,而是看每一代技术解决了上一代的什么问题:
- 词向量(2013):把词变成稠密向量,"国王 − 男人 + 女人 ≈ 女王"第一次让人看到语义可以计算。但它把每个词固定成一个向量,无法处理一词多义。
- RNN / LSTM / GRU(2014–2016):按顺序读句子,用隐状态记忆上下文,解决了一词多义。代价是必须串行计算、训练无法并行,且长距离依赖会衰减——句子一长,开头的信息就"忘了"。
- Transformer(2017):自注意力机制让任意两个位置直接建立联系、整个序列并行计算,训练效率数量级提升。这是今天所有大模型的共同基石。
- 预训练范式(2018,BERT / GPT):海量无标注文本上自监督预训练,再在下游任务微调。数据瓶颈从"标注数据"变成"只要有文本就行",从此模型规模开始起飞。
- 规模化(2020,GPT-3):1750 亿参数验证"规模即能力",少样本学习涌现。但原始 GPT-3 是个"会说续写腔"的模型,直接对话体验很差。
- 对齐(2022,ChatGPT):指令微调(SFT)+ 基于人类反馈的强化学习(RLHF),把模型从"会续写文本"改造成"会听指令的助手"。底层模型能力相比 GPT-3 没有质变,质变在对齐。
- 开源与多模态(2023 至今):LLaMA 等开源权重把门槛从"千卡集群"降到"单机可微调",社区生态爆发;同期模型普遍长出眼睛和耳朵,图像理解、语音对话成为标配;推理增强(让模型先思考再回答)又打开了能力天花板。
这条线上有两个决定性节点。Transformer 解决了"怎么把模型训大"——没有并行注意力,千亿参数根本训不动;对齐解决了"怎么让大模型好用"——没有 RLHF,再大的模型也只是个续写引擎。本教程第 4 章与第 6 章将分别深挖这两个节点。
常见问题
问题:参数量越大的模型一定越好吗?
不一定。模型表现由参数、数据质量、训练充分度、对齐水平共同决定。一个 7B 参数、数据精洗、对齐良好的模型,实际使用体验完全可能超过 30B 参数但数据粗糙的模型。参数量只是容量上限,不是能力本身。
问题:大模型"知道"它说过的话是对是错吗?
不知道。它做的是基于上下文的概率生成,没有内置的真值校验。这就是为什么第 8 章的评估与第 10 章的安全治理如此重要——可靠性目前要靠外部机制兜底,而不是指望模型自觉。
问题:零样本、少样本、微调三者什么关系?
零样本和少样本靠提示词、不更新参数,便宜但上限受限;微调更新参数,效果好且推理时无需长提示,但需要训练数据与算力,且每个任务要单独维护。工程上常用顺序是:先试零样本,不够加少样本示例,仍不满足且任务高频稳定,才考虑微调(第 6 章展开)。
五、两个常见的能力迷思
初学者容易在两个极端之间摇摆:一端是把大模型当全知神明,另一端是抓住一次翻车就全盘否定。用两个迷思收束本节,帮你在两端之间找到校准点。
迷思一:"大模型等于数据库"。 有人以为模型内部有一个可以查询的知识库,问什么查什么。实际情况更像"压扁的记忆":知识以分布式权重的方式融在参数里,回忆是概率性的重建而非精确检索,所以会有版本混淆(把两次发布会的参数记串)、时间错乱(用过时的汇率回答问题)。这就是为什么严肃的知识问答要走检索增强的路子(第 9.2 节展开)——把"回忆"换成"查资料",可靠性立刻上一个台阶。
迷思二:"会推理等于不会算错"。 模型能做多步逻辑推理,却可能在两位数乘法上出错——因为它的"计算"是基于模式补全,不是执行算法。能力呈现明显的锯齿形分布:难的推理能做对,简单的算术反而翻车。工程上的应对是把精确计算交给工具,让模型调用计算器或代码执行环境,自己只负责擅长的语言理解与任务规划。
带着这两个迷思再回看下一节的对比矩阵,你会更理解"混合架构"为什么是常态:大模型的长板与短板都太鲜明,好的系统设计就是扬长避短的组织学。
常见追问:大模型与搜索引擎有什么区别?
搜索引擎检索已有内容,返回的是网页链接;大模型生成新内容,返回的是"为你组织过的回答"。这个区别带来两个推论:搜索引擎的事实性由源页面背书,大模型的事实性没有天然背书(幻觉问题的另一面);但搜索引擎不能理解、改写、组合,大模型可以。当代产品的融合形态——检索提供事实、模型负责理解与组织——正是各取所长的结果,第 9 章会反复见到这个组合。
本节要点回顾
- 大模型 = 参数巨大、海量数据自监督预训练的深度网络;LLM 是其语言分支。
- "大"指参数、数据、算力三维匹配放大,外加常被忽视的数据与训练工程。
- 核心特点:能力涌现、通用性、少样本/零样本、在语境中学习、知识压缩;革命性在通用,不在单项精度。
- 脉络:词向量 → RNN/LSTM → Transformer → 预训练 → 规模化 → 对齐 → 开源/多模态;Transformer 解决训得大,对齐解决用得好。
- 涌现有争议、有能力边界,精确性与事实性任务上大模型并不天然占优。
下一节把镜头拉近:大模型今天究竟用在了哪些场景,以及它与传统机器学习模型的边界画在哪里。