10.2 资源能耗与架构演进方向
10.2 资源能耗与架构演进方向
本节摘要:算力与能耗是大模型规模化的物理约束,也是架构创新的驱动力。本节算训练与推理两笔能耗账,看架构侧的应对:MoE 如何把容量与计算解耦、高效注意力家族的降本路线、长上下文的攻坚方向(以及"长上下文会取代 RAG 吗"的现实判断),最后展望 Transformer 之外的新架构探索。
学习目标
阅读完本节,你应当能够:
- 说出训练与推理各自的能耗量级与可持续性含义
- 解释 MoE 的路由机制与"总参数 vs 激活参数"的区别
- 梳理注意力效率优化的三条路线
- 权衡长上下文与 RAG 的成本关系
- 客观看待新架构(Mamba 等)的定位
两笔能耗账:训练贵一次,推理贵一辈子
训练账:旗舰模型的训练消耗的 GPU 时数以千万计,耗电量的直观类比是一座小型城镇的日常用电量级,碳排放可观。这笔账由少数头部厂商支付,且随着规模定律的加码持续上涨。
推理账更值得注意:训练是一次性支出,推理是永久性经常支出。当数亿用户每天调用,推理的累计能耗与成本在数年内就会超过训练本身。第 7 章的全部优化技术(量化、批处理、KV 缓存管理)本质上都是在还这笔账;"推理时计算"(推理增强模型的长思考)又在给这笔账加码——能力与成本的拉锯进入新阶段。
可持续性的应对在四个层面同步推进:算法层(本节的架构演进)、系统层(第 7 章的推理优化)、硬件层(专用加速芯片、能效比提升)、能源层(数据中心配绿电、余热回收)。对开发者的含义很实际:每一个 token 都有电费——提示词的长度、上下文的策略、模型档位的选择,都是能耗决策。
二、MoE:容量与计算的解耦
第 4.1 节提过 MoE 的思路,这里展开机制。传统稠密模型每次前向要过全部参数——容量与计算量绑死,模型越大越贵。MoE 把 FFN 层替换为多个并行的"专家",配一个路由器:
token 到来 → 路由器打分 → 只送往得分最高的 1~2 个专家 → 输出加权组合
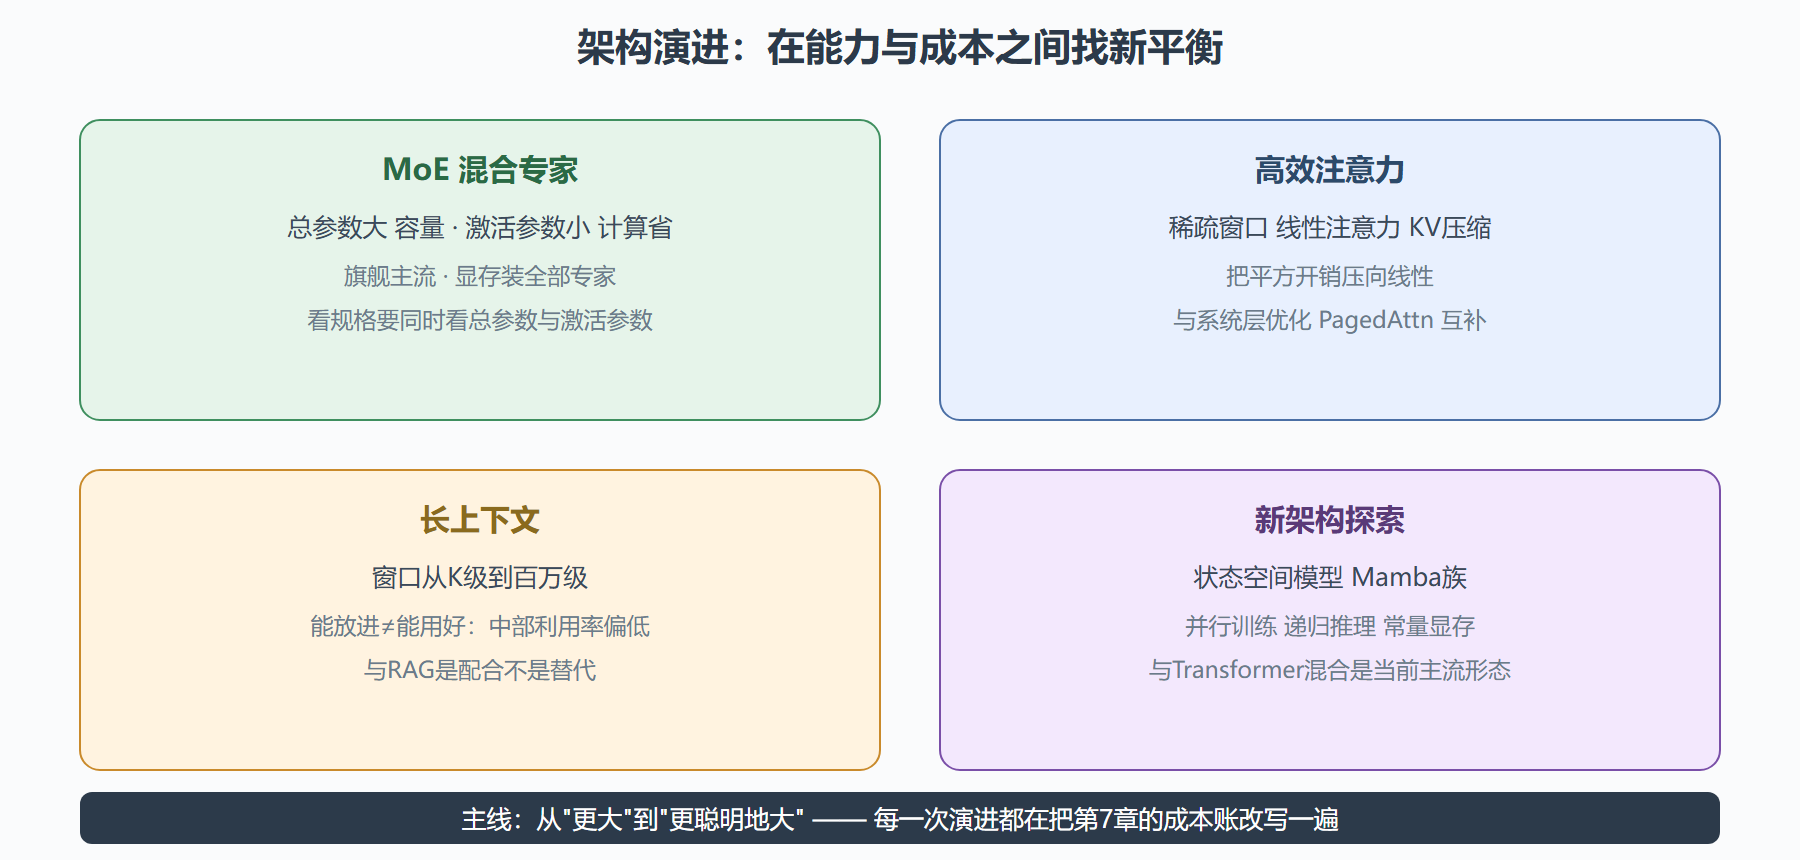
效果是两个数字的分离:总参数量可以做到数千亿(容量大、知识多),每次激活的参数只有几百亿(计算省、速度快)。旗舰模型广泛采用这条路,"总参数千亿、激活几十亿"的配置已成当代旗舰的常见形态。
工程代价也要知道:显存要装下全部专家(激活省计算不省显存);路由的训练不稳定(负载不均、专家闲置)需要辅助损失调平衡;训练与推理框架的复杂度更高。所以看 MoE 模型的规格表,要同时看总参数与激活参数——比较模型大小时只看总参数,会得出完全错误的结论(这已是常识级陷阱)。
三、注意力效率:三条降本路线
第 7.1 节讲过注意力是序列长度的平方开销,架构层面的缓解沿三条路线推进:
- 稀疏注意力:不让每个 token 看所有 token——滑动窗口(只看邻居)+ 少量全局位置(关键信息中转站),把平方降为近线性。长文本模型的常用配置。
- 线性注意力:数学上改写注意力的计算顺序(先结合 K、V 再算 Q),彻底去掉平方项,代价是表达力有折损,多与其他技术组合使用。
- KV 缓存压缩:4.1 节的 GQA(多 Q 头共享 KV)之外,还有 KV 量化(缓存本身降精度)、滑动窗口缓存(旧位置的缓存丢弃)——直接砍长上下文的显存大头。
这三条路线与第 7 章的系统层优化(PagedAttention 等)是互补关系:架构改计算量,系统改利用率,两层一起把百万 token 上下文从论文推向了产品。
四、长上下文:攻坚与冷静
上下文窗口从早期 2K 一路推到百万 token 量级,驱动力是"把整本书、整个代码库直接塞给模型"的诱惑。但冷静的账要算三笔:
成本账:预填充计算随长度线性涨、注意力随长度平方涨(优化后仍未消除)、KV 缓存显存随长度涨、并发能力随缓存占用下降(第 7.1 节)。百万 token 的单次请求成本是千 token 级的百倍以上。
效果账:"能放进窗口"不等于"能用好窗口"——长上下文中部的信息利用率偏低(所谓"迷失在中间"现象)、超长范围的精确检索(找一个数字、一处改动)仍不可靠。放进去了,未必找得到。
替代账:RAG 按需检索几段相关内容,成本只有全量塞入的零头,且知识可随时更新。"长上下文取代 RAG"在可预见的成本结构下不会发生;现实形态是混合——检索做初筛(省成本),适度加长上下文做精读(保覆盖),两者配合而非互斥。
架构演进路线图
五、Transformer 之外:新架构的冷静观察
Mamba 等状态空间模型(SSM)代表另一条路线:训练时可并行(像 Transformer)、推理时按递归方式运行(像 3.2 节的 RNN,但解决了梯度问题),显存不随序列长度增长——正中长上下文的痛点。早期结果令人兴奋,但工程现实是:Transformer 的生态(算子优化、推理框架、微调工具、规模验证)领先太多,纯粹的新架构替换代价巨大。
当前的实际演化形态是混合架构:底层用 SSM 类模块处理长程(省显存),关键层保留注意力(保精确检索能力),取两家之长。"取代 Transformer"暂时不是正确的问题,"在哪些层用什么模块"才是。
对读者的建议不变:架构新闻可以追,生产选型看成熟度——生态完备的标准架构配合系统层优化,在多数场景仍是最稳妥的答案。
常见问题
问题:推理增强(长思考)会不会让能耗问题失控?
它确实把"算力换能力"从训练期挪到了推理期,成本压力大增。业界的应对是分层:日常任务用快思考模型,难题升级到慢思考,并把思考过程做缓存复用。这本质上是又一层"能力-成本"路由,与模型档位选择同一逻辑。
问题:MoE 的小团队可用性如何?
开源 MoE 模型的总参数带来显存门槛(全部专家要装进显存),但配合量化与流水并行,中等集群已可服务。对个人开发者,稠密小模型仍是最省心的选择。
问题:上下文窗口还会继续涨吗?
会,但增长的经济动机会被成本约束——窗口大小与单位 token 价格共同决定"可用的上下文"。工程上更健康的指标是"每块钱能处理的上下文量",而不是裸窗口数字。
六、给团队的成本治理建议
能耗与成本议题落到团队层面,是一套可以马上执行的成本治理方法:
第一,建立单位经济学指标。定义"每千次有效调用的总成本"(含推理、检索、重试、人力审核),按业务线拆分。没有单位经济学,降本无从谈起——你不知道每一块钱花在哪、哪一块最肥。
第二,流量分层路由。分析请求日志,把流量按难度分层:高频简单请求路由到量化小模型,困难请求升级到旗舰。多数业务的简单请求占七成以上,仅此一项可降本过半(第 7.2 节蒸馏方案的理论依据)。
第三,缓存与去重。高频同质问题(客服场景常见)用语义缓存直接返回历史优质回答;提示词中的固定部分(系统提示、知识背景)利用前缀缓存特性降低重复计算。
第四,把能耗写进设计评审。新功能评审加一问:"这个功能的调用规模 × 单次成本是否与它的业务价值匹配?"——很多"顺手加上大模型"的功能,算完这笔账会主动降级到规则实现。
第五,追踪强度指标。关注单位任务能耗的行业趋势(每 token 成本的下降曲线),据此动态调整自建与外购的边界。成本结构每年都在变,去年的最优架构今年可能已不经济。
五条建议的共同底色:能耗治理不是环保姿态,是工程纪律——它逼着每个功能证明自己的存在价值。
补充:架构判断力的三则思维训练
面对层出不穷的架构新闻,给三则思维训练保持判断力:其一,问"它省的是哪一种成本"——计算、显存、带宽、通信,任何新架构必居其一,定位了成本类型就能推断适用场景(省显存的适合长文本、省通信的适合多卡)。其二,问"它牺牲了什么"——没有免费的午餐,线性注意力牺牲精确检索、MoE 牺牲显存、量化牺牲精度,找到代价才能评估匹配度。其三,问"生态成熟度几年了"——新架构的收益要打生态折扣,三年内的架构默认按"值得实验"而非"值得生产"对待。三问在手,架构新闻从情绪来源变成信息来源。
常见追问:个人开发者在能耗议题上能做什么?
三件实际的事:其一,选型时把单位任务成本纳入决策(小模型能做的别用旗舰,量化版够用的别跑全精度);其二,用好缓存(语义缓存与前缀缓存直接减少重复计算);其三,实验时随手记录成本,让"这次实验花了多少"成为肌肉记忆。单个开发者的影响微小,但这套习惯决定了未来系统设计者的默认直觉——行业的能耗水平,最终由千万个这样的默认值叠加决定。
再追问:边缘侧大模型的现实能力边界在哪?
以当前与可预见的技术:参数量在三十亿到七十亿级、量化后体积三五 GB 的模型,能在旗舰手机与笔记本上流畅运行,胜任日常问答、摘要、简单代码与翻译;精确的复杂推理、专业知识、多模态重任务仍需云端。务实的端云分工线画在"任务复杂度与隐私要求"两维上:简单敏感任务端侧,复杂公开任务云端,中间地带按成本动态路由。这条线每年都在上移,值得每年重估一次。
本节要点回顾
- 能耗两笔账:训练贵一次,推理贵一辈子——推理的累计成本最终超过训练;每个 token 都有电费。
- MoE 解耦容量与计算(总参数大、激活小);看规格必须同时看两个参数;显存装全部专家是隐性门槛。
- 注意力降本三路线:稀疏、线性、KV 压缩,与系统层优化互补。
- 长上下文三笔账(成本、效果、替代):放进≠用好,长上下文与 RAG 是配合不是替代。
- 新架构(SSM/Mamba)价值真实但生态差距大,混合架构是当前演化形态;选型看成熟度。
最后一节,走向远方:多模态统一、智能体、AGI 争辩与开源生态——并收束整个教程。