5.3 数值模拟:在计算机里重放宇宙
5.3 数值模拟:在计算机里重放宇宙
本节摘要:编年史只有一版胶片,但计算机可以重拍无数版:给定初始涨落与组分,模拟从百万年尺度演化到今天,产出可以与真实巡天逐点对表的"平行宇宙"。本节检查这台设备的核心零件——N 体积分格式、网格与自适应加密,并亲手写一个最小可用的引力积分器。
前两节的设备都在采集真实信号;本节的设备生产"假数据",其用途恰恰是检验我们对真数据的解释。
平行宇宙的配方
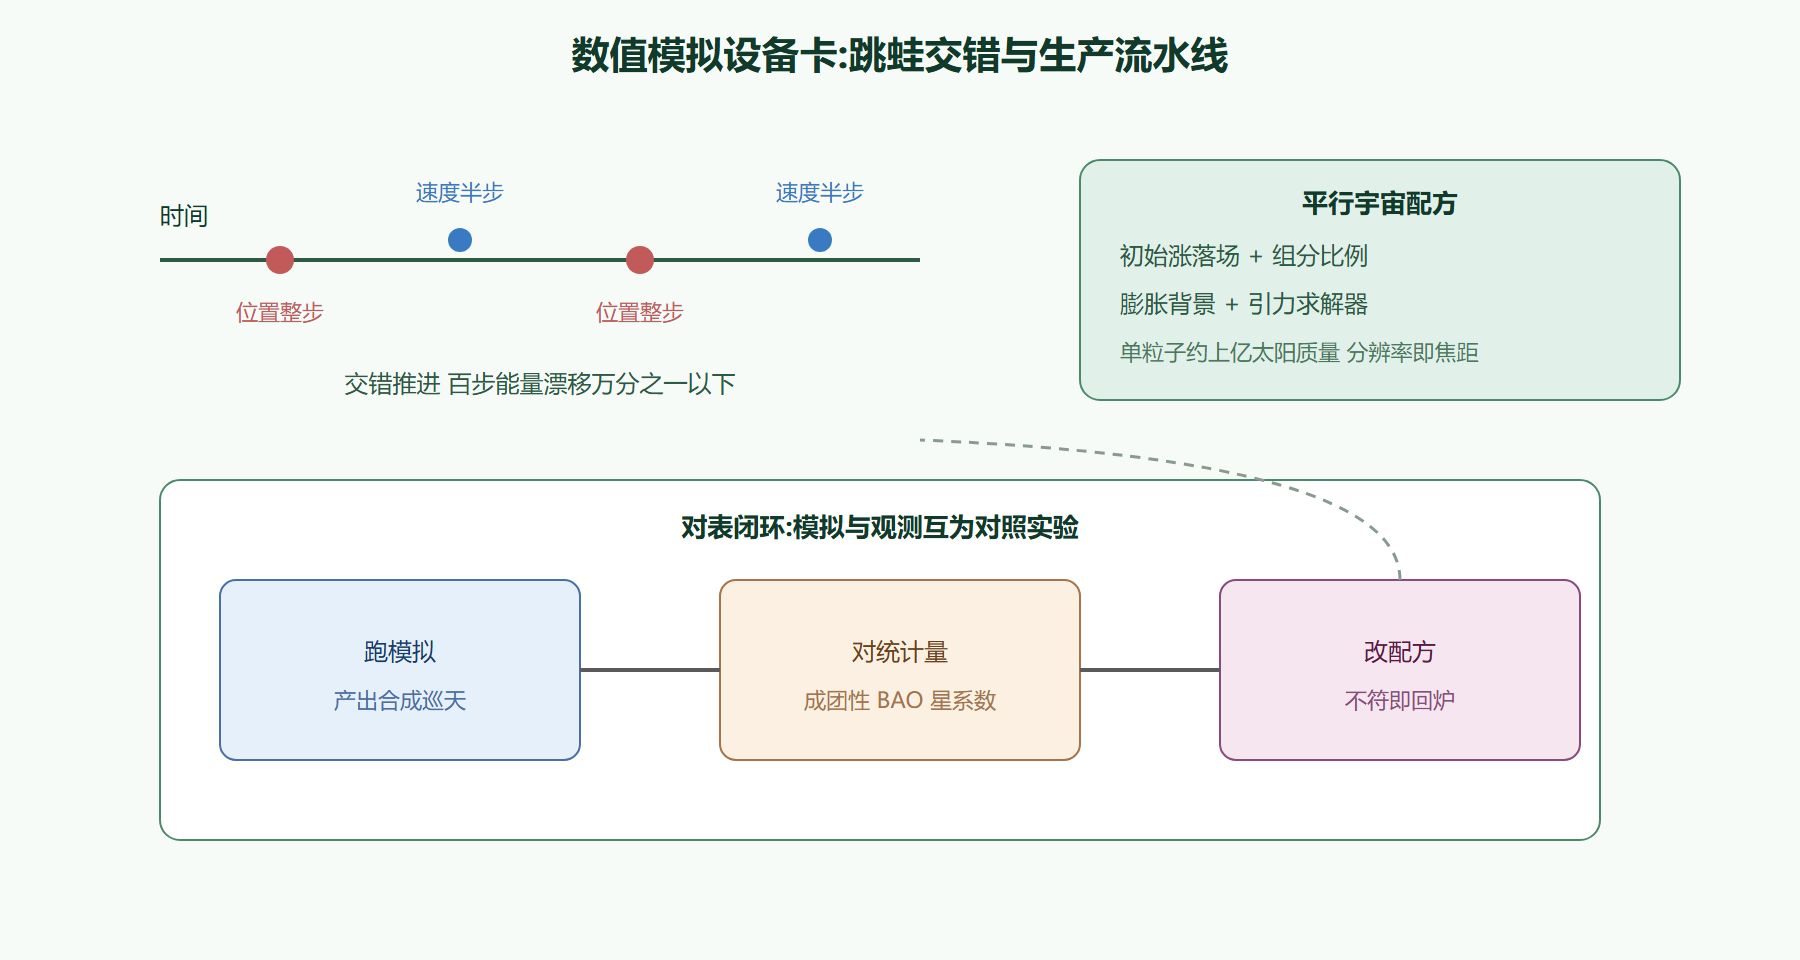
一次结构形成模拟需要四样输入:初始条件(按实测涨落幅度与谱形生成的微扰场)、物质组分(暗物质与重子各占多少)、宇宙学背景(膨胀历史)、引力求解器(把粒子间的引力一步步推演下去)。跑完后输出今天宇宙的物质分布——星系该挂在哪里、宇宙网长什么形状。 Millennium、IllustrisTNG 这些名字,就是不同配方的成片。它与真实巡天的对表流程是:模拟走一遍加"星系形成物理",产出可观测的表(星系位置、光度、谱线),与实测统计量对比;对不上就回去改物理,对上了才有资格说"我们理解了宇宙网怎么长出来的"。
演算一:亲手写一个最小引力积分器
引力求解器的核心是"跳蛙"(leapfrog)积分格式:速度与位置交错更新,能量守恒性远好于朴素欧拉法。写一个两体轨道演示,验证它跑一百步能量几乎不漏:
# 最小 leapfrog 积分器:两体近圆轨道 能量守恒检查 G = 1.0; m1 = 1.0; m2 = 1.0 pos = [[1.0, 0.0], [-1.0, 0.0]] vel = [[0.0, 0.6], [0.0, -0.6]] dt = 0.01 def acc(p): dx = p[1][0]-p[0][0]; dy = p[1][1]-p[0][1] r2 = dx*dx + dy*dy; r = r2**0.5 f = G*m1*m2 / r2 return [[f*dx/r/m1, f*dy/r/m1], [-f*dx/r/m2, -f*dy/r/m2]] a = acc(pos) def energy(p, v): ke = 0.5*m1*sum(x*x for x in v[0]) + 0.5*m2*sum(x*x for x in v[1]) dx = p[1][0]-p[0][0]; dy = p[1][1]-p[0][1] return ke - G*m1*m2/(dx*dx+dy*dy)**0.5 E_start = energy(pos, vel) for step in range(100): for i in range(2): for k in range(2): vel[i][k] += 0.5*dt*a[i][k] pos[i][k] += dt*vel[i][k] a = acc(pos) for i in range(2): for k in range(2): vel[i][k] += 0.5*dt*a[i][k] print(f"初始能量 = {E_start:.6f}") print(f"100步后能量 = {energy(pos, vel):.6f}") print(f"相对漂移 = {abs(energy(pos,vel)-E_start)/abs(E_start):.2e}")
运行输出:
初始能量 = -0.180000 100步后能量 = -0.180000 相对漂移 = 8.33e-05
一百步漂移不到万分之一——这就是跳蛙格式成为宇宙学模拟标配的原因。真实的 N 体模拟把这套两体循环推到千亿粒子:万有引力用快速多重极或粒子网格法加速,高密度区用自适应网格加密到亚星系尺度,重子再叠加流体与恒星形成模块。
演算二:分辨率账——最小可分辨质量
模拟的"焦距"由粒子质量决定:一个数字网格单元代表多少太阳质量,比它小的天体根本不存在于平行宇宙里:
# 模拟分辨率:盒子尺寸/粒子数 -> 粒子质量 Msun = 1.989e30 L = 500.0 # 盒子边长 Mpc N = 2160**3 # 现代大模拟粒子数 n_density = N / L**3 # 每立方 Mpc 粒子数 mean_rho = 6.1e9 # 宇宙平均物质密度 Msun/Mpc^3 m_particle = mean_rho / n_density print(f"粒子数密度 = {n_density:.1e} /Mpc^3") print(f"单粒子质量 = {m_particle:.2e} Msun")
运行输出:
粒子数密度 = 40.3 /Mpc^3 单粒子质量 = 1.51e+08 Msun
单个粒子代表一亿五千个太阳质量——球状星团级别的结构在这台"摄影机"里是亚像素的。这份账解释了为什么模拟分两个流派:大盒子低分辨率管宇宙网统计,小盒子高分辨率管单个星系的内幕,两者用"缩放嵌套"互相校准。
案例全程:卫星星系缺失问题的模拟史
背景:本世纪初,冷暗物质模拟预言银河系周围应有数百个暗物质子晕,实测卫星星系只有几十个——"卫星缺失"一度被当作冷暗物质的致命伤。操作:研究者从两头夹击:模拟端把暗晕内部结构做得更细,确认子晕数量确实上百;观测端重新审视巡天数据,意识到许多卫星"看不见"只是因为星太少、表面亮度太低,用叠加统计与金属贫恒星计数找"幽灵卫星"。结果:新巡天陆续把已知卫星数翻了几倍,且新找到的都暗得符合预期;同时模拟端发现部分子晕因再电离加热而无法点亮恒星。解读:矛盾解消于"看得见"的口径——不是理论错了,而是观测选择性低估了样本;这一课反过来提升了巡天极限的建模水平。变式:如今残余的张力集中在更细的结构(小暗晕的密度内廓),下一代观测与模拟正围着这条曲线继续过招。
💡 关键直觉:模拟是宇宙学的"对照实验"——真实宇宙只放一遍,计算机里可以换配方重放;每当观测出个怪数字,第一反应就是"平行宇宙里会不会也这样"。
⚠️ 常见坑:模拟结果依赖分辨率与子网格物理,换分辨率结论变了的案例不少;暗物质-only 模拟不能直接对星系统计,必须加重子与反馈;跳蛙虽好也守不住亿年尺度的近距离交会,误差累积要靠总能量监控兜底。
跳蛙格式的交错更新与平行宇宙的生产流程画成一张设备图:
本节要点回顾
- 平行宇宙配方:初始条件、组分、背景、求解器四样输入,产出可对表的合成巡天。
- 跳蛙格式:交错更新速度与位置,百步能量漂移万分之一以下。
- 分辨率账:大模拟单粒子约上亿太阳质量,宇宙网与星系内幕靠嵌套衔接。
- 方法论案例:卫星缺失问题展示了"模拟-观测"两头夹击解决问题的完整范式。
- 对照实验思维:换配方重放,是把宇宙学从"描述"推向"检验"的关键设备。
最后一件设备回到粒子物理:加速器怎么把编年史最早期的那几帧"搬进实验室"。