5.1 基因组测序实验决策
5.1 基因组测序实验决策
本节摘要:基因组测序的决策发生在下单之前:你要找单碱基变异、结构变异、还是组装一个没有好参考的物种?短读长重测序擅长单碱基和短 indel,结构变异和重复区需要长读长或配对末端策略。覆盖度不是越大越体面,是相对变异频率和样品纯度的数学。先写清楚问题,再选文库,否则你会买到一张看不懂也回答不了问题的表。
本节地图
阅读完本节,你应当能够:
- 区分重测序、从头组装、靶向捕获、宏基因组各自回答什么
- 用覆盖度和等位基因频率估计低频率变异能不能看见
- 说明 PCR 重复、GC 偏差、参考基因组漏洞如何制造假变异
- 在肿瘤纯度、污染、混样被发现时知道先查实验而不是先发新基因
先写问题,再写测序仪型号
“做个全基因组”不是实验设计。找孟德尔病的编码变异,外显子捕获通常更划算。找调控区或结构变异,才需要更全的基因组或长读长。组装新物种,短读长拼重复区会碎,长读长和高准确短读长常要搭配。宏基因组问群落里有谁、有什么基因,个体染色体的相位反而不第一。
把它当成测绘。你要的是门牌号(单碱基)、还是整栋楼拆迁(结构变异)、还是一张从没画过的城市(组装)。门牌号用短读长沿已知地图比对即可;拆迁要用能跨过重复街区的长尺子;新城市不能靠把读段硬贴到别的城市地图上。
决策清单: 有没有可用参考基因组 变异类型:单碱基、indel、拷贝数、重排、表观 样品:单克隆、组织混合物、肿瘤纯度 预算换成覆盖度还是样本数 是否需要相位信息
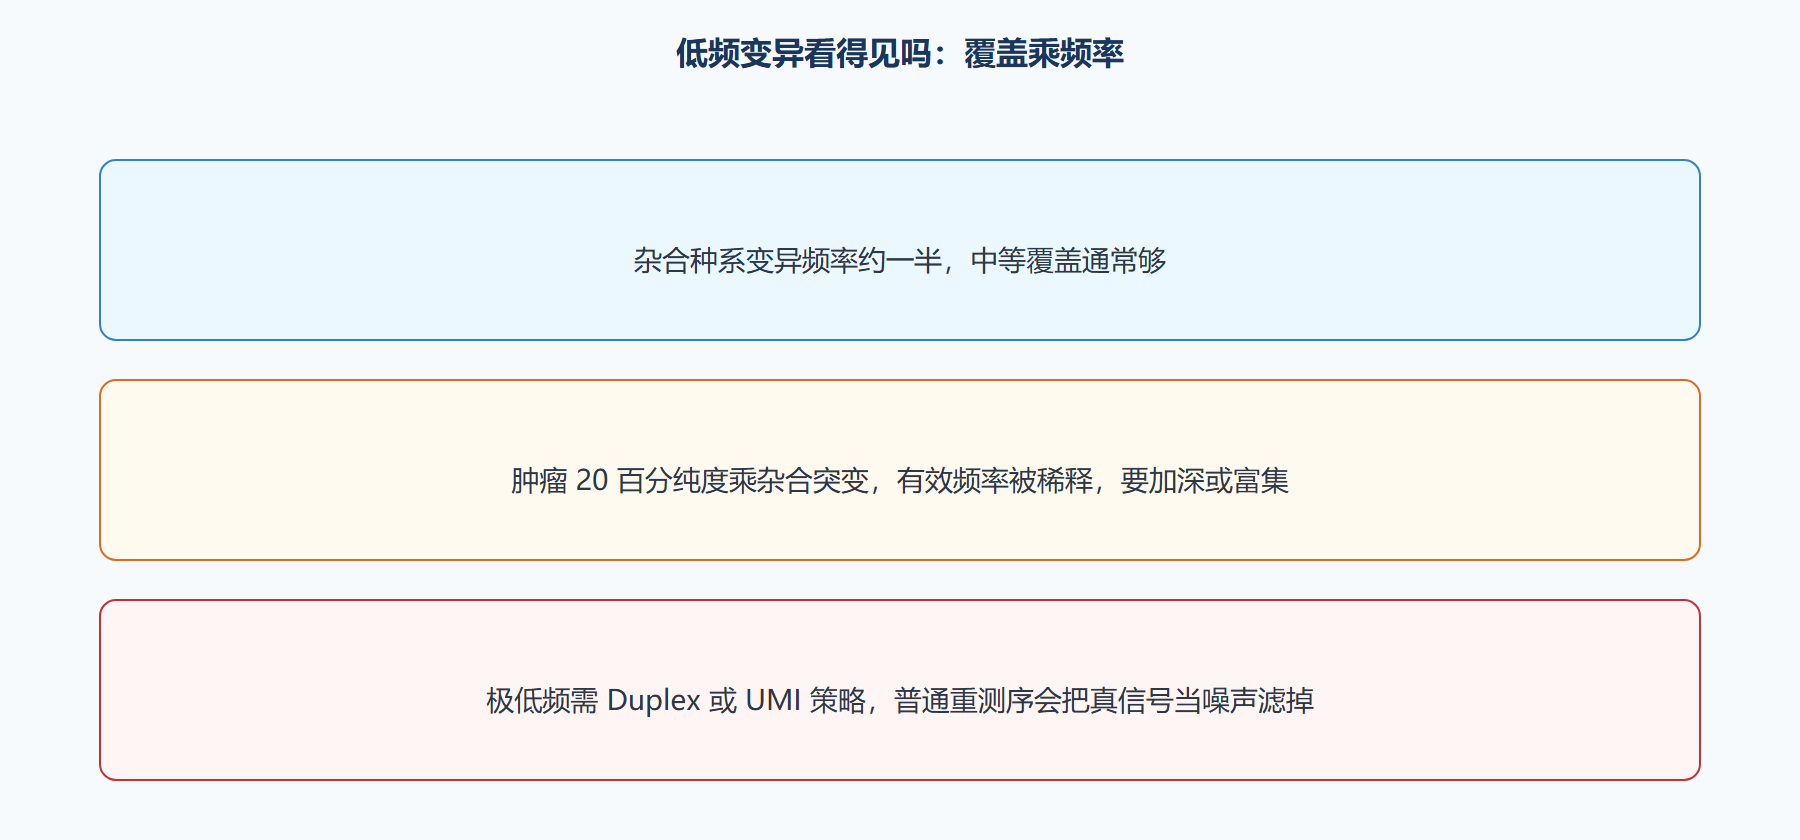
覆盖度是平均每个碱基被读到几次。孟德尔杂合变异在中等覆盖下通常可见;体细胞低频突变在肿瘤纯度低时会被稀释,需要更高覆盖或富集。公式直觉:期望读到的次数约等于覆盖度乘以该等位基因的真实频率。频率 5%、覆盖 50,期望只有大约 2-3 个读段,很容易被当成噪声滤掉。这时不是算法不善良,是你买的层数不够。
| 目标 | 更常见的选择 | 别默认 |
|---|---|---|
| 已知基因点突变 | 靶向扩增或捕获 | 全基因组深测 |
| 孟德尔外显子 | 外显子组 | 单细胞全基因组 |
| 结构变异 / 重复 | 长读长或专库 | 只靠短读长比对 |
| 新物种染色体 | 长加短杂交组装 | 只跑一层短读长 |
| 群落组成 | 宏基因组或扩增子 | 把混合物当单基因组组装硬拼 |
文库步骤在制造系统误差
打断插入片段长度决定你能跳过多远的重复。配对末端提供两个锚点。PCR 扩增文库会让某些 GC 极端区消失或重复,PCR-free 对基因组更诚实也更吃起始量。重复读段来自同一分子的克隆,当独立证据会假升高等位基因频率,必须去重。UMI 独特分子标签能帮你分清“真的很多分子”还是“PCR 复印了很多”。
参考基因组不是真理。缺口、错误、次要单倍型、基因家族塌缩,都会让比对把读段放错家,造出假 SNP 或假缺失。重复区和假基因是重灾区。变异列表必须带质量与注释,并抽一部分用 Sanger 或第二种技术验证,尤其你要拿它做功能结论时。
⚠️ 常见坑:把未去重的深度当成覆盖度,肿瘤突变负荷被 PCR 重复抬上天。
💡 关键直觉:测序读的是文库分子,不是细胞里的染色体。文库偏差写进了你的“基因组”。
污染是基因组学的羞辱教育。实验室间交叉、人员 DNA、试剂微生物基因组,都会出现在表里。阴性对照文库不是浪费。混样索引错误会让样本对调,临床场景是事故。双端索引和小心的液体处理比再买一轮测序便宜。
图 覆盖度与低频变异
工程实践:下单前的质控和下单后的抽查
DNA 完整性对长读长致命,短读长文库也讨厌严重断裂。肿瘤切片的甲醛交联会引入假 C 到 T 一类损伤,分析流程要有损伤感知。数量不够就全基因组 PCR 扩增,会把偏差放大,单细胞基因组尤其严重,解释必须非常钝。
拷贝数和纯度纠缠。肿瘤不是纯细胞系,正常细胞稀释突变,亚克隆让频率进一步散开。没有纯度估计的体细胞列表,很难谈驱动还是乘客。配对正常对照能减去种系变异,没有配对就不要轻易把数据库里没有的位点写成体细胞。
伦理和可识别性:全基因组几乎不可逆地标识个人。知情同意、存储、共享规则在第 6.5 节展开,这里先说技术人也要当数据管理员,不能把 identifiability 当生信细节。
验证:关键位点用正交方法。结构变异看是否有分裂读段和深度支持同时在。只在重复区出现、质量低、方向异常的变异,优先当比对伪影。
问题:要不要上超深度?
钱应优先花在样本设计和纯度上。一个脏样本的超深度,不如三个干净生物学重复更能回答多数生物学问题。临床低频监测除外,那是另一套检测限设计。
问题:长读长可以取代短读长吗?
长读长在结构变异和组装上更强,单碱基准确率历史上较弱,近年明显改善,但仍常与短读长互补。按变异类型混合,比信仰某一平台更像实验。
文库插入片段分布要用电泳或仪器看一眼。太短则配对末端跨距不够,结构变异和重复区更无助;太长则某些平台测序质量掉。捕获文库要看中靶率,中靶低等于钱花在靶外。外显子组对非编码调控变异几乎看不见,讨论增强子突变时不要用外显子组当证据。性别鉴定和近亲污染检测应写进常规 QC,样本对调有时靠这些才能发现。
体细胞突变调用要配对正常。没有配对时,把人群数据库里的多态减掉,仍会把稀有种系当体细胞。肿瘤异质性让频率呈连续分布,硬阈值会切掉亚克隆。报告应给频率和覆盖,而不是只给“检出/未检出”。拷贝数中性的杂合性缺失在短读长深度图上可能不明显,需要杂合 SNP 的等位失衡。这些不是软件彩蛋,是你下单时就要问的分析包。
伦理上,即使研究测序也要有同意。把研究 BAM 文件随手拷给合作者,可能已经越出同意范围。技术负责人不是法务,但要知道“文件能传”不等于“可以传”。第 6.5 节把这一条升格为红线,本节先让做基因组的人习惯把数据当人。
下单表上写清:参考版本、是否要线粒体、是否要 Y 染色体、是否要结构变异调用。默认套餐经常省略你真正要的那一层。覆盖度不是均值能保证每个碱基,低比对区要单独看缺口清单。重复序列的变异用短读长时降级为“不可评估”,不要硬叫。家系分析比单人更能过滤无关变异,设计时就采集,而不是测完再找亲属。肿瘤配对正常组织尽量同一人,否则种系背景不同。污染评估软件要跑,人源交叉并不罕见。阳性对照样本周期性测,看管道是否漂。漂了先修管道,再发新基因。基因组的动手优先,是把缺口和污染写进结果,而不是只把明星变异写进摘要。
覆盖度直方图比均值诚实,长尾低覆盖区才是漏检温床。重复区、极端碱基组成、缺口附近单独列表。家系共分离比预测软件更能缩小候选,设计阶段采集亲属。肿瘤异质性用多区域取样时,每一区都要有纯度估计。没有纯度的频率不能比。污染人源用指纹位点对上预期个体,对不上就是对调或污染。对调比新生物学更常见。把指纹分析写成常规,和测序仪开机一样。伦理同意覆盖再分析,否则不能把研究数据拿去跑新算法发新文。数据有人,算法没有豁免权。
覆盖度均值下面藏着长尾缺口。把缺口列表和重复区不可评估写进报告,比多报几个明星变异更接近基因组学的诚实。指纹核对防对调,对调比新基因常见。低频变异先算覆盖乘频率的期望读段,期望太低就不要硬叫。没有配对正常,不要轻易把数据库未见位点写成体细胞。同意要覆盖再分析。
缺口清单进报告。重复区降级为不可评估。指纹防对调。低频先算期望读段。无配对正常不轻易写体细胞。同意覆盖再分析。均值覆盖下面的长尾才是漏检温床。捕获中靶率要看。PCR重复不当深度。损伤化学会造假碱基,分析要知情。
缺口、不可评估、指纹、期望读段、配对正常、再分析同意,六项写进交付。均值覆盖是广告,长尾才是漏检。捕获看中靶。重复不当深度。损伤会造假碱基。对调比新基因常见。把清单当放行,比把明星变异当放行更像基因组学。
交付六项再核:缺口、不可评估、指纹、期望读段、配对正常、再分析同意。六项缺一不放行明星变异。均值是广告。损伤知情。捕获看中靶。重复去重。对调比新基因常见。数据有人。
覆盖度均值好看,不等于每个区间都够。碱基组成极端区、重复区和同源基因会一起变薄。低频变异声明之前,先看该位点的原始比对,而不是只看变异表上的数字。文库插入长度决定你能否跨过重复,短插入再加深测序也补不回结构信息。
本章回顾
- 问题决定文库:点突变、结构变异、组装、群落不是同一产品。
- 覆盖度乘频率:低频看不见时先算期望读段数。
- 测的是文库:PCR 重复、GC 偏差、损伤都会进表。
- 参考基因组有洞:重复区和假基因要人工怀疑。
- 去重和 UMI:深度不是复印次数。
- 污染和混样:阴性对照和双索引是卫生。
- 关键变异要正交验证:尤其功能结论和临床相关位点。
下一节把相对静态的字母换成动态的 RNA 清单:核糖体不去掉,差异表再漂亮也像在测核糖体。