4.1 从向量机到 GPU:硬件如何挑选算法
4.1 从向量机到 GPU:硬件如何挑选算法
本节摘要:天体物理算法的胜负,有一段必须写在机房里。向量处理器偏爱规则网格上的相同指令;GRAPE 把牛顿力做成管道,让直接 N 体在中等粒子数上重新可问;商品集群把 MPI 变成宇宙学普通话;GPU 用吞吐给树遍历、粒子网格和辐射包重新定价。硬件从不取消复杂度阶梯,它只改变某一级台阶的票价,从而改写下一年度的开题报告。
核心问题
阅读完本节,你应当能够:
- 解释向量机为何抬高规则网格、压低不规则树
- 说出 GRAPE 解决的是力的单价,不是平方墙的渐近符号
- 说明 GPU 对“大量相同核函数”友好,对分支严重的个别时间步不那么友好
- 判断一种新加速器宣传里,天体物理能立刻映射的是哪类核
- 把“我们用了某超算”翻译成:它让哪一层物理刚好处在可计算区
票价改了,提问单才改
同样是 N 体,星团组长期守着直接求和,因为近距必须准,平方墙用个别时间步局部挖洞。宇宙学组必须抛弃直接求和,因为粒子数是政治。这种分流在纸上是算法,在历史上也是机器。向量机上,规则网格的差分和傅里叶变换很顺;不规则的树遍历打断向量,编译器不高兴。于是有一段时间,网格宇宙学和网格流体显得“更科学”,其实有一部分只是更合当时的管道。
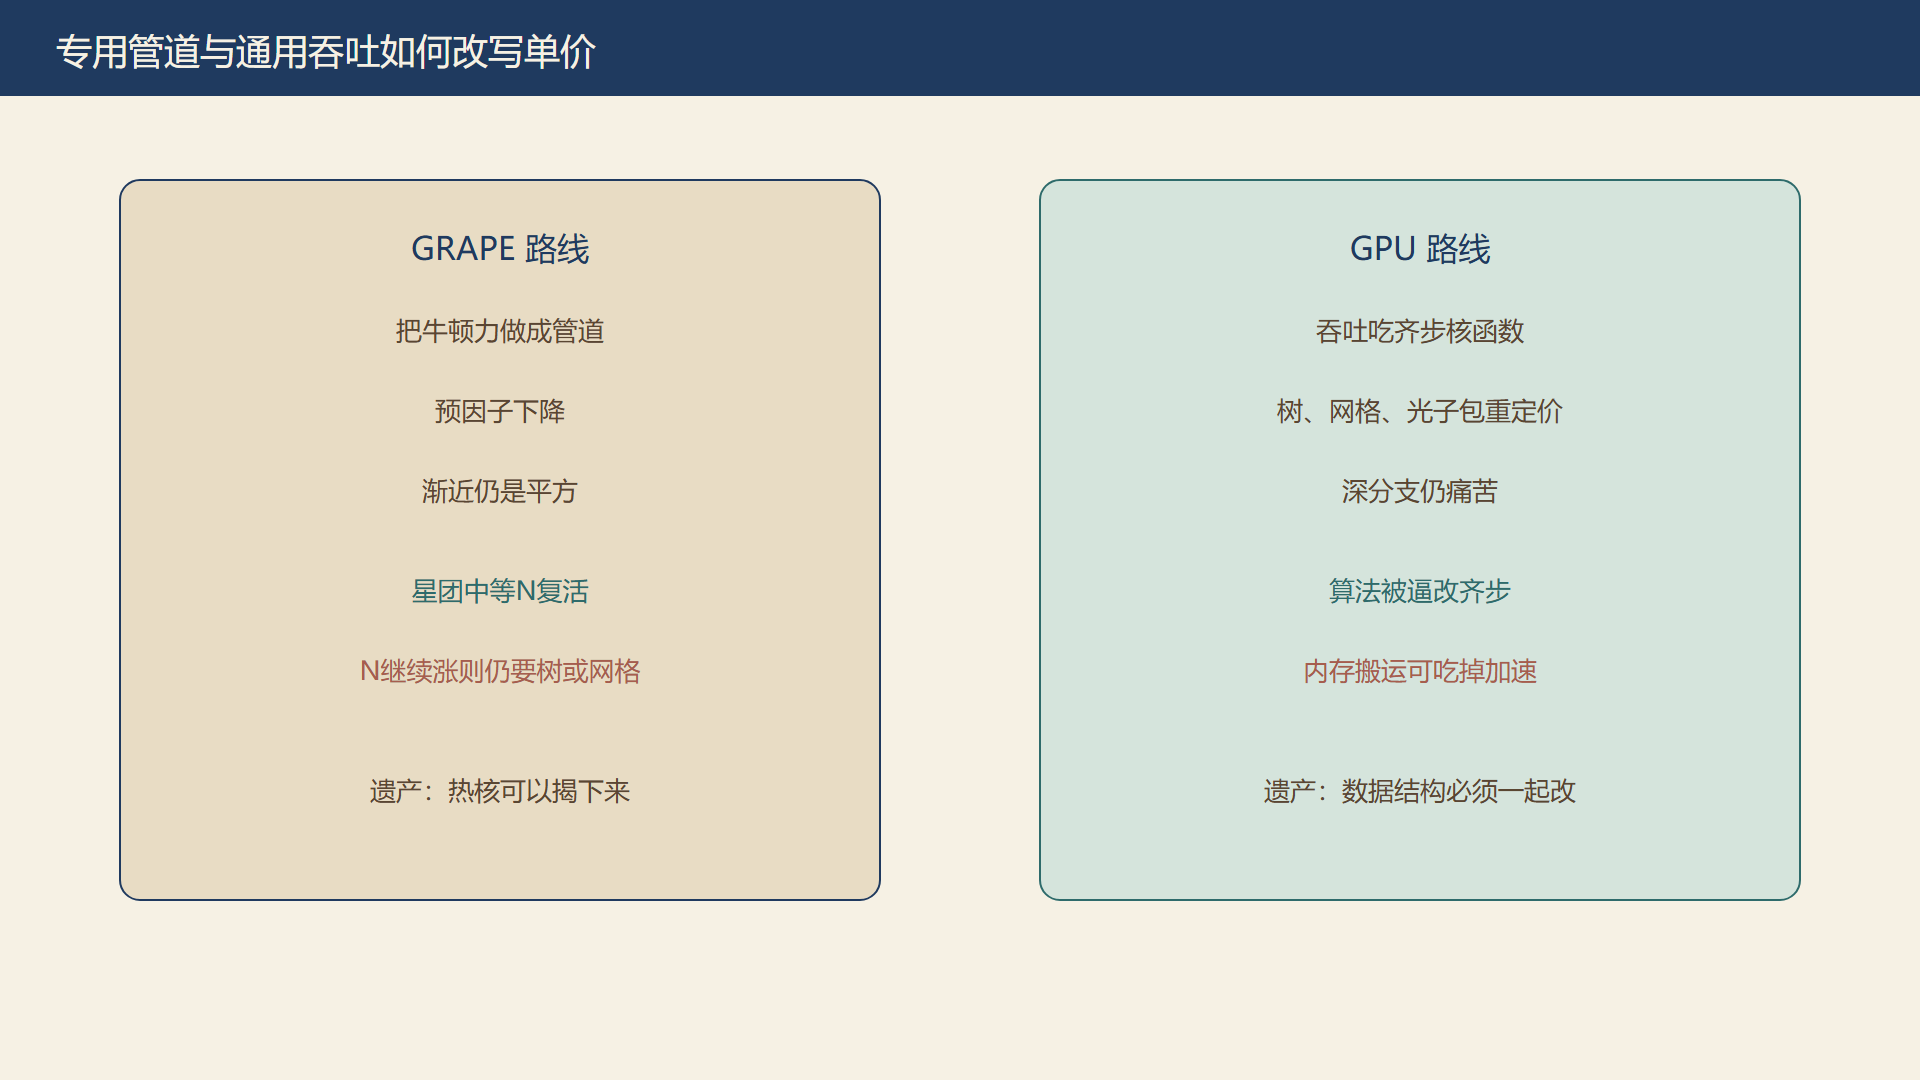
日本的 GRAPE 把力计算做成专用硬件:粒子数据流过管道,加速度流出来。直接求和的系数被打下来,星团和行星环一类中等 N 的问题重新活跃。渐近仍是平方,但平方的预因子可以被机器暂时赦免。赦免有期限。当宇宙学要的 N 继续涨,专用管道盖不过对数因子的树和近线性的网格。GRAPE 的遗产不是“专用芯片永远赢”,而是证明:把最热的核从通用 CPU 里揭下来,可以改写一个子领域十年的题目。
机器世代 突然变便宜的核 被拉进可计算区的问题 向量机 规则网格、FFT 流体激波、PM 宇宙学 GRAPE 牛顿力配对 星团、部分行星 N 体 商品集群 分布式内存消息 十亿粒子盒子 GPU 吞吐型核函数 树、网格、蒙特卡罗包
💡 关键直觉:开题报告里的“我们将解析某某尺度”,往往先通过了机时委员会,才通过了物理审查。
集群与 GPU:通用化之后的再定价
Beowulf 风格的商品集群让实验室能拼出自己的超算。MPI 成为宇宙学的普通话:空间切开,粒子或格子按域居住,边界用消息交换。TreePM 在这种机器上很自然——长程网格全局变换,短程树本地。负载均衡成为新墙:宇宙学演化后期物质集中到晕里,均匀切域会让有的进程算晕、有的进程看空洞。空间填充曲线、动态再划分,是集群送给算法的回礼。
GPU 把“大量相同运算”的单价再次打下来。粒子-粒子力、网格核、辐射蒙特卡罗包,映射愉快。分支严重、数据依赖强的个别时间步、AMR 的不规则层次,映射痛苦。于是出现新的谱系压力:有人把个别时间步改成更齐步的块,有人把 AMR 改成更规则的补丁。物理上不见得更正确,工程上才能吃到吞吐。方法史必须把这层压力写进去,否则你会以为算法自己变美了。
异构之后,CPU 常负责不规则与消息,GPU 负责热核。内存墙比算术墙更硬:把粒子列表在主机与设备间搬来搬去,可以吃掉加速。所以“我们移植到 GPU”这句话,要听它有没有把数据结构一起改写。只把力循环贴上加速指令、数据结构仍按 CPU 缓存来,加速比会很难看。
| 硬件 | 友好的离散 | 不友好的离散 | 对提问单的影响 |
|---|---|---|---|
| 向量 CPU | 规则网格 | 深树、乱序遭遇 | 抬高欧拉流体 |
| GRAPE | 直接力 | 多物理耦合 | 抬高纯 N 体星团 |
| MPI 集群 | 领域分解 | 极端负载不均 | 抬高周期盒子 |
| GPU | 齐步核函数 | 深分支 AMR | 逼算法改齐步 |
图:从专用力管道到吞吐核
专用硬件赦免预因子,通用吞吐改写核函数地图。两者都没有取消第 2 章的复杂度阶梯。
效率优化的诚实边界
把算法映射到新硬件,常被写成“持续优化”。优化有两类。一类不改离散:更好的缓存、向量化、通信与计算重叠。一类改离散:更大软化、更粗开角、更少辐射方向、更激进的亚网格。前者是工程美德,后者是在卖物理。混在同一张加速比图里,读者会以为格式没变、只是更快。审计问题很简单:分辨率声明有没有跟着变。
能耗和排队策略也在挑选题目。百万核小时的盒子,一年只能跑有限组参数。于是流体宇宙的参数扫描贵到必须求助半解析或第 5 章的仿真器。硬件在这里再次改写方法:不是因为它算错了,是因为它把“再来一组宇宙学参数”标成奢侈品。
⚠️ 常见坑:用 GPU 加速比宣传科学进步,却把开角加大、粒子数不变。票价下降被拿去买了更脏的力。
概念账本:
列出最热核:力、通量、光子包、化学网 问:齐步吗?数据局部吗? 能揭到管道或GPU则改数据结构 不能则留CPU并减少其调用次数 加速比必须与开角、软化、方向数一起报
硬件定价之后,需要一种语言把成千上万个进程组织起来。下一节是 MPI、领域分解,以及那些活了二十年的开源方言。
排队、能耗与“科学产出”的计量
超算中心按核时或节点时计费,委员会按论文与学生训练评估。计量方式会惩罚短而多次的参数扫描,奖励一次大运行。流体宇宙的单点著名模拟因此比套件更容易被批准,即使科学上套件更需要。仿真器与半解析部分是对这种计量的反抗:把昂贵前向集中到训练,把扫描移出排队。读领域的题目分布,能看见计量,而不只看见物理。
能耗把“还能不能再加密一档”变成伦理与预算问题。加密一档若只让细丝更好看、条款仍主导,电费买的是审美。方法节若能证明加密改变了盲测量,电费才买到提问权。GPU 的能效比在齐步核上更好,于是又一次出现第 4.1 节的压力:把算法改齐步以符合机房的能耗叙事。符合不等于物理正确,但会决定哪类论文先被写出来。
专用芯片的周期仍可能回来。引力波数据分析、辐射蒙特卡罗、某种固定的树遍历,都是潜在的管道。历史教训是:专用化在问题稳定时赢,在条款与方程还在改时输。当代星系形成的条款仍在改,专用化更适合已冻结的核,例如固定开角的 TreePM 力,而不是整座联邦。
移植清单:从热核识别到不许改脏的分辨率
一次诚实的 GPU 移植可以按清单走:剖析找出热核;判断齐步与数据局部性;改数据结构减少搬运;用同一开角同一软化对照 CPU 的力向量与能量抖动;最后才报加速比。清单上任何一步把开角加大或把辐射方向减少,加速比必须改名叫做“更脏的力的加速比”。审稿人若只看到倍数,应追问清单。
混合精度是新的诱惑。力的累加若用更低精度,近距对可能损失。宇宙学长程网格有时能容忍,星团正则化通常不能。精度也是分辨率声明的一部分。把混合精度写成纯工程,隐瞒了它对近距物理的判决。GRAPE 时代已经用定点数算过力,教训并不新:管道的位宽,就是你肯卖掉的精度。
问题:报一个很大的 GPU 加速比,是否等于科学进步?
只有在开角、软化、辐射方向数、混合精度与 CPU 对照都不变时,加速比才是工程进步。任一项变脏,倍数应改名为更脏的力的加速比。数据结构若不改,搬运可以吃掉加速。个别时间步与深 AMR 对 GPU 不友好,算法被逼改齐步时,要审计物理是否被一起改掉。机时计量还会惩罚参数扫描、奖励单次大运行,从而改写开题单。把加速比当科学,是把票价当定律。
混合精度与专用位宽是被忘记的分辨率声明。GRAPE 用定点数算过力,近距对会先受伤。宇宙学长程网格有时能忍,星团正则化通常不能。移植清单应把精度与开角、软化并列。能效叙事会逼算法改齐步,符合机房不等于符合近距物理。把位宽写进方法节,才不会把管道的舍入卖成科学加速。
排队策略惩罚短而多次的扫描,奖励一次大运行,于是单点著名模拟比套件更好申请。仿真器与半解析部分是对这种计量的反抗。读题目分布能看见计量,而不只看见物理。加密一档若只让细丝更好看,电费买的是审美不是提问权。
专用芯片在方程还在改时容易输,更适合已冻结的核,例如固定开角的长程力,而不是整座星系联邦。
票价改了,提问单才改,复杂度阶梯从未取消。
硬件从不取消阶梯,只改变某一级台阶的票价。
开题报告里的尺度承诺,往往先通过了机时委员会,才通过物理审查。
预因子可以被赦免,平方符号不能。向量机、专用力管道、集群、异构加速器,四代改的都是哪一类核突然便宜,而不是把 N 平方变成 N。读加速比,先看开角、软化、方向数有没有一起被卖掉。票价改提问单:齐步核变便宜,个别时间步与深分支就要另付痛;数据结构不改,加速比只是把旧债换了货币。
本章回顾
- 硬件改的是票价:复杂度阶梯还在
- 向量抬网格,GRAPE 抬直接力,集群抬盒子,GPU 抬齐步核
- GRAPE 赦免预因子,不赦免平方
- GPU 会逼算法改齐步:个别时间步与深 AMR 要付痛
- 数据结构不改,加速比是假的
- 加速比必须和分辨率声明一起读
下一节进入并行方言与代码谱系:领域分解如何与个别时间步打架,Gadget 与 RAMSES 为何会成为共同体坐标。