5.2 机器学习改写流水线
5.2 机器学习如何改写模拟流水线
本节摘要:机器学习进入计算天体物理,不是因为方程突然失效,而是因为第 4 章的票价和第 5.1 节的条款空间让“再跑一遍”成为奢侈。合法岗位包括:用仿真器模仿昂贵前向模型以扫描参数;用分类与分割加速晕、形态、瞬变识别;用降阶模型给初值或闭合;偶尔用网络去逼一个热核。非法岗位是:用拟合图代替守恒与收敛,或把训练集的宇宙学锁死却声称发现了新宇宙。
读前必看(上)
阅读完本节,你应当能够:
- 说出仿真器在 CAMELS 一类项目里实际替代的是哪一步
- 区分仿真器、找器、加速核、物理知情模型四种岗位
- 解释训练集的宇宙学与配方如何变成仿真器的暗宪法
- 说明守恒与外推:网格可以在训练盒外的参数上体面地失败
- 拒绝把神经网络的一次拟合成功写成数值模拟被取代
再跑一遍太贵,模仿才进场
流体宇宙加条款扫描,维度包括宇宙学参数与反馈参数。每一组要跑完哈勃时间,队列不允许网格状穷举。半解析曾经承担过这个角色。场层次的仿真器走得更远:学习从初值或低成本输入到统计量甚至三维场的映射。CAMELS 一类项目明确把许多小盒子当成训练与测试,用来看条款如何改观测。岗位是代理,不是新的引力定律。代理若只在训练分布里准,拿到训练没见过的反馈强度就会自信地胡说。这与高阶多项式外推是同一类病,只是更会画。
找器岗位更老也更稳。晕寻找、强透镜弧、瞬变分类、形态标签,本就是算法产品。卷积网络把人设计的特征换成数据驱动的特征,速度和一致性往往上升。风险是标签本身来自某一种旧找器或某一种观测选择,网络学会的是旧宪法的口音。把网络标签当成更接近自然的“真晕”,是循环论证。
岗位 替代什么 不能替代什么 仿真器 昂贵前向的重复扫描 训练分布外的物理 找器 人工特征与缓慢目录 标签定义的审计 加速核 局部热循环的近似 全局守恒的自动成立 物理知情网络 在损失里加方程残差 数据覆盖不足时的唯一性
💡 关键直觉:机器学习是流水线上的工位名。工位写清楚,它是工具;工位写成“智能宇宙”,它是修辞。
四种岗位的纪律
仿真器纪律:训练/验证/测试按盒子或按参数划分,避免把同一随机初值漏进三份。报告时同时给插值误差与轻微外推误差。最好能对功率谱一类可与线性理论对照的量先过关,再谈形态。找器纪律:标签来源公开,与旧找器的混淆矩阵要有。加速核纪律:热核的近似必须有守恒诊断,不能只报均方误差。物理知情纪律:把方程残差放进损失,能改善内插,不保证外推;约束不足时,网络可以学会一种看起来像方程的假解。
生成模型还能做“从观测到场”的反演或补全。这把噪声与先验搅在一起。能用的场合是:先验来自同一套前向模拟,噪声模型诚实,结果当条件样本而不是当照片。不能用的场合是:把生成的细丝当成未观测到的真实结构去发表发现。
| 岗位 | 训练数据典型来源 | 主要暗宪法 | 审计问题 |
|---|---|---|---|
| 场仿真器 | 小盒子流体宇宙 | 条款与宇宙学网格 | 盒子外还能不能用 |
| 统计仿真器 | 半解析或大盒子摘要 | 半解析自己的条款 | 是否只是模仿模仿 |
| 形态找器 | 人工或旧算法标签 | 选择效应 | 口音来自谁 |
| 辐射或化学加速 | 网格点上的ODE解 | 覆盖的密度温度范围 | 守恒与刚度 |
图:机器学习在流水线中的位置
它夹在昂贵前向与观测推断之间。跳过前向直接从数据生成宇宙,先验会冒充发现。
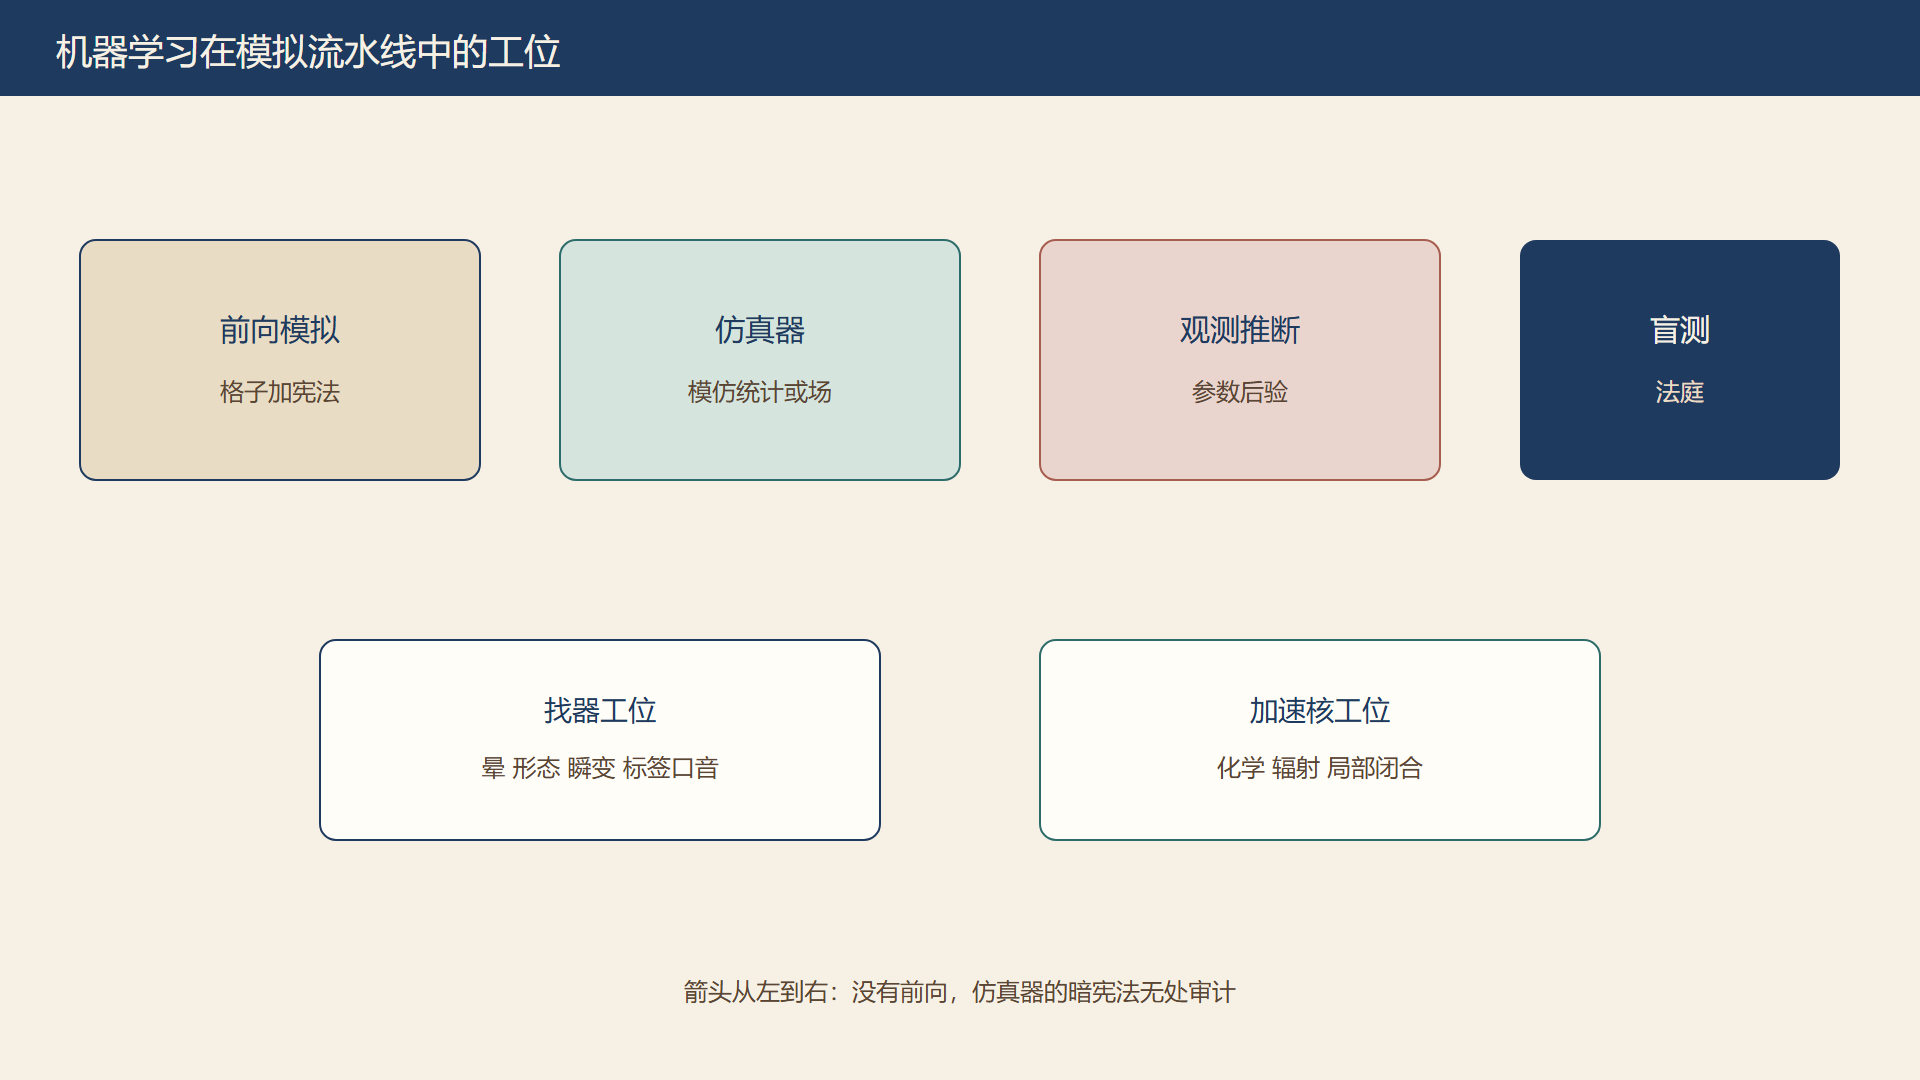
与传统求解器的关系:替换、旁路,还是新的接口误差
有人希望网络直接进化流体,绕过黎曼求解器。在低维测试题上可以漂亮。到宇宙学联邦,约束、个别时间步、域分解、条款源项缠在一起,端到端替换仍然昂贵且难审计。更现实的插入点是接口:化学网、不透明度、闭合因子、亚网格湍流。这些本来就是降阶。网络把降阶做得更灵活,也把接口误差变得更不透明。第 2.5 节的教训再次适用——箭头方向要画出来。
训练集的产生本身消耗第 4 章的市场。小盒子不能代表大盒子的方差,高红移不能代表今天的选择效应。仿真器论文必须报告训练体积与目标体积的差。不报这个差,等于用模具压出来的齿轮去冒充另一座钟。
⚠️ 常见坑:在训练参数范围内把仿真器误差画得很小,然后用它去排除训练从未见过的反馈模型。那是用口音去审判一种没听过的语言。
概念账本:
先写清工位:仿真器 / 找器 / 加速核 划定训练分布:宇宙学、条款、盒子、红移 保留前向抽检:分布边缘必须退回全模拟 损失里若加方程:仍要外推测试 发布:钉死训练种子与网络版本,如同钉死演化码
机器学习把扫描变便宜。下一节把便宜的扫描与昂贵的前向一起拖到观测法庭:分辨率、精度、合成观测与盲测如何构成闭环。
推断、仿真器误差棒,以及人还在哪
把仿真器接进贝叶斯推断或模拟推断,后验宽度必须包含仿真器误差。只含宇宙方差和仪器噪声,会得到过窄的宇宙学参数。误差模型本身需要在测试盒上校准,并允许相关:功率谱相邻 k 的误差通常相关。把仿真器当成无噪声理论,是用新工具重复旧的过度自信。
人还在流水线里。标签、条款选择、训练盒设计、何时退回前向,都是人的判断。自动化找器减少的是重复劳动,不是责任。论文应写明:哪些失败案例会强制人工复核,哪些参数区域禁止仿真器发言。禁止区与第 5.3 节的盲测名单一样,属于方法而不是附录。
还有一种诱惑:用可解释性工具给网络画特征图,并写成新物理。特征图可以启发,不能代替受控实验。启发之后,仍要回到格子上关掉或打开某一项条款,看统计量是否按特征图暗示的方式移动。否则计算天体物理会从第三范式退回读图术。
数据泄漏、盒子宇宙学与仿真器的诚实失败模式
同一并合树的不同红移切片被同时送进训练与测试,泄漏会发生。按盒子划分比按快照划分更安全。小盒子缺大尺度模态,仿真器学会的功率谱在低 k 会偏。目标若是巡天尺度,训练体积必须被讨论,否则是用模具压齿轮去配另一座钟的齿数。
诚实失败模式应当被展示:参数走到训练盒角落时,功率谱误差如何涨;条款组合从未见过时,形态如何崩。崩塌比光滑的错误更有价值,因为它告诉推断管道该停。把失败区涂成与成功区一样的置信度,是当代最危险的可视化之一。第 5.3 节的盲测,有一部分就是在抓这种涂法。
问题:仿真器误差很小,能否用来排除训练未见过的反馈模型?
不能。那是用口音审判没听过的语言。训练分布是暗宪法,外推可以体面地失败。后验宽度必须包含仿真器误差,且允许 k 之间相关。按盒子划分训练与测试,避免同一并合树泄漏。失败区应被展示,不应涂成与成功区一样的置信度。端到端替换流体仍难审计;更现实的是接口插入。工位写不清,机器学习就只是修辞。拟合图不能代替收敛测试。
人仍在流水线里:标签、训练盒、禁止区都是判断。自动化减少重复劳动,不减少责任。可解释性特征图可以启发,随后仍要在格子上开关条款做受控实验,否则第三范式会退回读图术。训练体积与目标体积的差必须报告。小盒子缺大模态,仿真器在低 k 会偏。把失败区涂成高置信,是最危险的当代可视化之一。
生成模型做场补全时,噪声与先验搅在一起。结果应视为条件样本而不是照片。禁止区与盲测名单一样属于方法:哪些参数区域不许仿真器发言,必须写明。否则自动化只是把越界说得更流畅。
接口插入比端到端替换更现实:化学、不透明度、闭合因子本就是降阶,网络把降阶做灵活,也把接口误差做不透明,箭头仍要画出来。
工位写清则是工具,写成智能宇宙则是修辞。
训练集的宇宙学与配方会变成仿真器的暗宪法。
岗位是代理不是新引力定律,离开训练分布必须退回前向或承认失败。
泄漏按盒子划分来防,比按快照划分更安全。
损失里加方程残差能改善内插,不保证外推时的唯一性。
按盒子划分训练与测试,避免把同一随机初值漏进三份数据。
仿真器是条款空间上的路,不是新的引力定律。训练分布写进暗宪法:宇宙学参数、反馈强度、盒子边长,外推时必须能体面地失败并退回前向。找器网络会遗传标签口音,加速核必须对照同一组激波管,物理知情损失能改善内插、不保证外推唯一。工位写清是工具,写成智能宇宙是修辞。
一节小结
- 进场原因是票价与条款空间:不是方程破产
- 工位必须写清:仿真器、找器、加速核、物理知情
- 训练分布是暗宪法:外推可以体面地失败
- 标签口音会遗传:找器不是更接近自然的真值
- 端到端替换流体仍难审计:接口插入更现实
- 拟合成功不等于取代收敛测试
下一节关闭全书:分辨率与精度如何被诚实声明,模拟产品如何经合成观测进入与数据的对质。