4.1 误差来源与误差预算实例
4.1 误差来源与误差预算实例
本节摘要:不带不确定度的测量值在天体测量学里没有地位,而给不确定度定量的方法就是误差预算。本节先分清随机误差与系统误差——前者按平方根随观测次数收敛、后者趴在地板上不动;然后合成一份完整的地面视差程序预算(30 次曝光后总误差约 7.5 毫角秒的计算全程),对照一份空间任务的预算;最后复盘昴星团距离之争,看系统误差如何让一台毫角秒精度的卫星交出偏了百分十的距离。关键词:误差预算、随机误差、系统误差、平方根收敛。
学习目标
- 区分精密度与准确度、随机误差与系统误差;
- 用平方和开根的法则合成独立误差,算出总不确定度;
- 编制并解读一份分层的误差预算表;
- 说出至少三种对付系统误差的策略,以及各自的代价。
一份让人睡不着觉的星表
1997 年 Hipparcos 星表发表,一切看起来很好:亮端位置与视差精度约 1 毫角秒,距离阶梯的地基层焕然一新。但有一个数字不对劲:昴星团的距离测出来约 133 秒差距,而主序拟合等其他独立方法一致给 120 秒差距附近,差距超过 10%,远大于双方标称的误差棒。此后二十年,天文学家反复检验:是星团物理异常?还是 Hipparcos 的系统误差?2018 年 Gaia 第二批数据落锤:120.2 秒差距——Hipparcos 的昴星团视差带上了约 1 毫角秒的相关系统误差,集中体现在这个方向的天区。1 毫角秒,恰好是它标称精度的量级。
这个故事是本章的开幕理由:**标称的随机误差再小,也担保不了准确度;系统误差必须用另一套方法管理。**管理的工具就是误差预算——在观测之前把所有误差源列成清单,标注性质与量级,算出合成结果,标出主导项,然后决定把资源花在哪里。
随机与系统:一条铁律
随机误差是"每次测量都在变"的误差:光子噪声、视宁度抖动、读出噪声。它的核心性质是可收敛——单次标准差 13 毫角秒的随机项,30 次平均后变成 13 除以根号 30,约 2.4 毫角秒;300 次后 0.75 毫角秒。观测次数每翻四倍,随机误差减半,这条平方根定律是观测策略的定价表。
系统误差是"每次都往同一个方向偏"的误差:色散改正不干净、仪器弯沉的重复分量、参考星表的位置偏移。它不收敛——偏 6 毫角秒就是偏 6 毫角秒,重复一万次还是偏 6 毫角秒。堆曝光次数对它完全无效,这是初学者最常见的策略错误。
由此还有一对必须分清的词:精密度说的是重复测量的散布宽度(随机误差的水平),准确度说的是与真值的偏离(随机加系统的水平)。Hipparcos 对昴星团测得精密(毫角秒级的散布)而不准确(系统偏差 1 毫角秒),两者不能互相担保。
独立误差的合成法则只有一条:方差相加再开根(平方和开根)。互相独立的误差源各自贡献方差,总标准差是各方和的平方根。相关误差不能这样合——相关项会互相放大或抵消,这正是昴星团案例的隐蔽之处:单个星的误差棒没毛病,团内各星的误差高度相关,平均不掉。
一份完整的地面预算
回到 3.1 节的算例:视宁度 1.5 角秒、信噪比 50,单次质心精度 13 毫角秒。设一个 1 米望远镜的近星视差程序,规划 30 次曝光。预算表逐项列:
| 误差源 | 性质 | 单次量级 | 30 次后 | 备注 |
|---|---|---|---|---|
| 质心光子与视宁度噪声 | 随机 | 13 毫角秒 | 2.4 毫角秒 | 除以根号 30 |
| 折射改正残余(差分后) | 系统 | 3 毫角秒 | 3 毫角秒 | 随天顶距与颜色偏 |
| 色散与色差项 | 系统 | 4 毫角秒 | 4 毫角秒 | 蓝红星质心定义不一致 |
| 参考星表位置误差 | 系统 | 4 毫角秒 | 4 毫角秒 | 对目标星表现为共同偏移 |
| 仪器弯沉残余 | 系统 | 3 毫角秒 | 3 毫角秒 | 差分消一阶后的剩余 |
| 合成总误差 | — | — | 7.5 毫角秒 | 平方和开根 |
合成过程值得一步步看:随机项先收敛到 2.4;然后把收敛后的随机项与四个系统项各自平方相加——2.4 的平方 5.8,加 3 的平方 9,加 4 的平方 16,再加 16 与 9,总和 55.8,开根得 7.5 毫角秒。看这个结构:单次 13 毫角秒的程序,30 次曝光后总误差 7.5 毫角秒,其中随机项只占三分之一的方差,系统项占了大头。把曝光次数加到 300 次,随机项降到 0.75,总误差变为 6.6 毫角秒——从 7.5 到 6.6,十倍的曝光量只买到 12% 的改进。预算表在观测前就告诉你:这个程序再堆时间不划算,要突破就得对付系统项。
对照一份空间任务的预算骨架(Gaia 类):单次过境随机项 0.2 毫角秒,70 次过境收敛到 24 微角秒;系统项包括基本角改正残余(几十微角秒量级,随天区有空间模式)、电荷转移效率退化(随星等偏移)、拥挤视场污染、视差零点(EDR3 平均约负 17 微角秒,需按发表方法改正)。合成后亮端视差精度约 20 到 30 微角秒——结构上与地面预算一模一样:随机一项在前,系统一串在后,最终精度卡在系统项的和上。两份表并排放着,第 3 章说过的结论在这里定量重生:地面姓大气,空间姓仪器。
误差预算的瀑布图:随机收敛 系统趴底
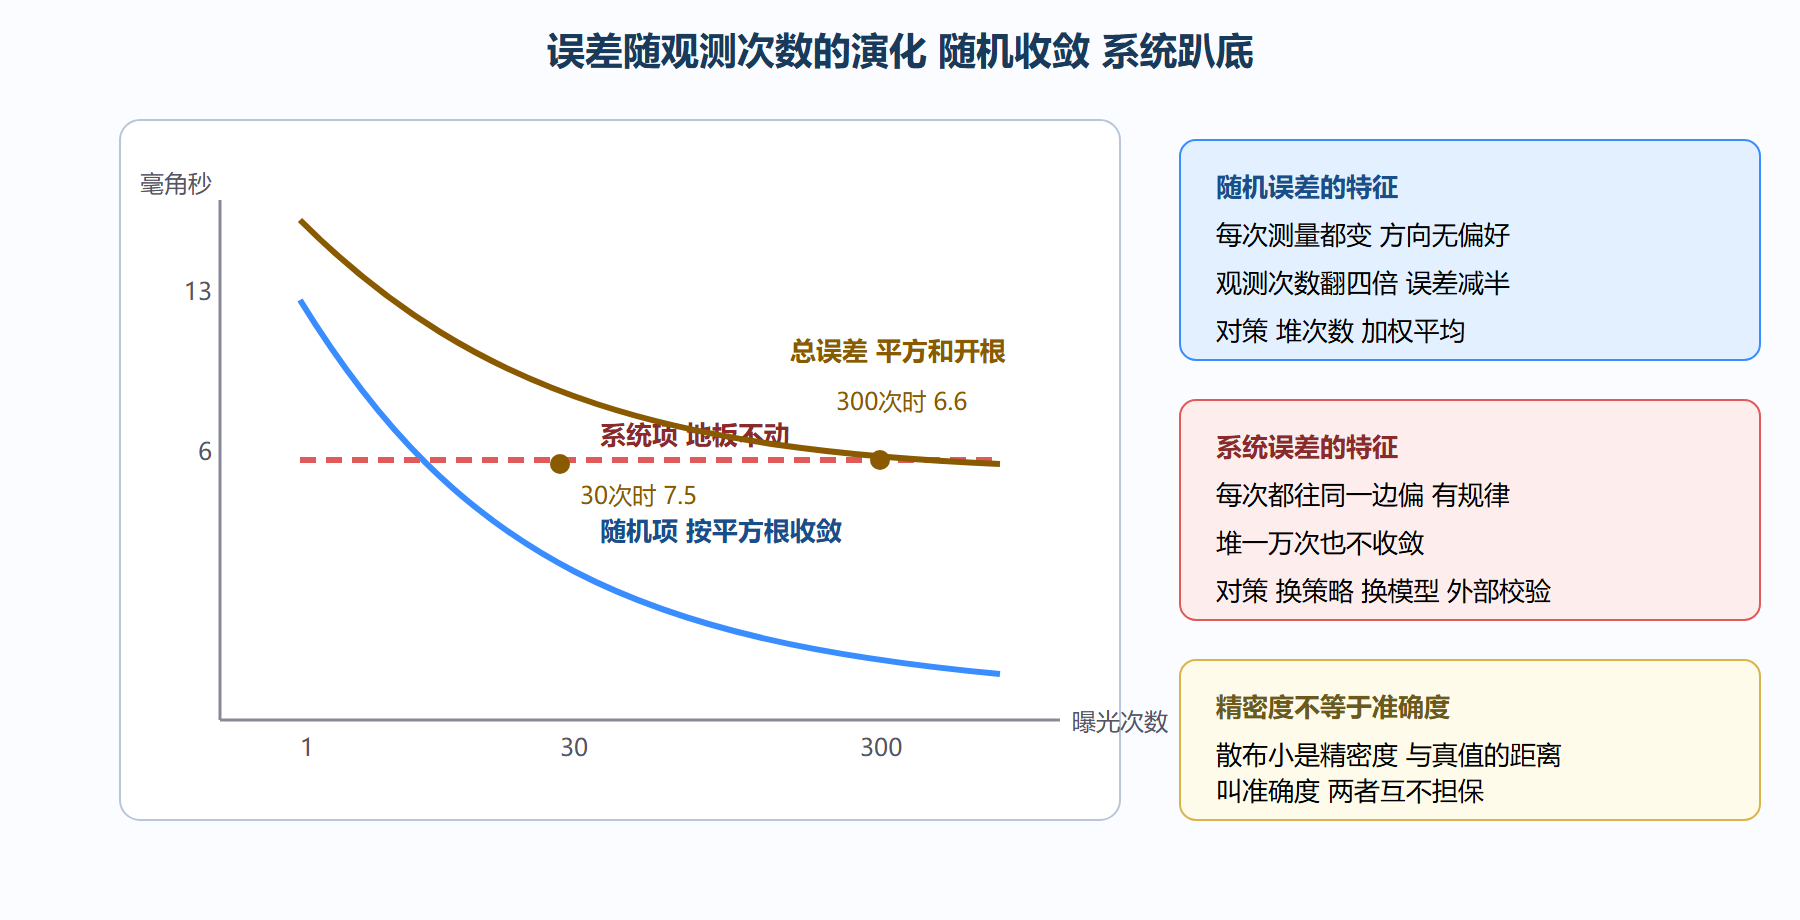
看左图三条线的走势对比:蓝线(随机)快速下坠,红线(系统)水平不动,棕线(总误差)跟着蓝线下坠一段后贴上红线——这就是"地板"一词的来历。30 次到 300 次之间,总误差几乎躺平,右下角黄框的警句就是昴星团故事的浓缩:散布再小,也担保不了与真值的距离。
把"堆次数不划算"再算细一点,体会收益递减的陡峭。从 30 次加到 120 次(四倍曝光量):随机项从 2.4 降到 1.2,总误差从平方和 1.44 加 55(系统项平方和,单位略)中的随机份额变小,开根后约 7.44——从 7.5 到 7.44,四倍投入换百分之一的改进。从 120 次加到 480 次,总误差 7.41。这条曲线就是"预算表指挥资源分配"的全部依据:预算里随机项占大头的程序,堆次数有效;系统项占大头的程序,每一小时曝光都该拿去换策略——换时角分布、换滤光片、换参考星表。反过来,若观测已经做完,预算表还有用:它告诉你结果的系统不确定度该报多大,而不是只报统计涨落。
再补一句"相关"在预算表里的处理。表中各项默认互相独立,方差直接相加;若两项同源(比如色散与折射都随天顶距增长),它们正相关,合成方差要加上协方差项——简单相加会低估总误差。星团内各星误差高度相关的昴星团案例,本质就是协方差项主导了团平均的误差。写预算表时给每一项标注"相关对象"这一列,是专业与业余的分界线之一。
对付系统误差的四种武器
既然堆次数无效,系统误差要用别的武器。第一种,改变观测条件让系统项随机化:把曝光分布到不同时角、不同天顶距、不同方位,让色散与弯沉的偏差方向在数据里不再整齐划一,部分转化为随机项再平均掉。第二种,建模改正:给弯沉建立随姿态变化的模型、给色散建立随颜色与天顶距的模型,从观测方程里显式扣掉;基本角监测装置就是这一策略的空间版。第三种,差分设计:参考星网格吸收共同误差(3.1 节),但要注意参考星自身的系统会遗传。第四种,也是最硬的一种,外部校验:找一个"答案已知"的对象做空白对照。视差研究的完美空白对照是类星体——它们远到真实视差严格为零,任何测出的视差都是系统误差本身。Gaia 用百万量级类星体标定视差零点,昴星团之争的仲裁者也是"用独立方法测过距离"的星团。空白对照的价值可以量化感受:EDR3 视差零点约负 0.017 毫角秒,若不改正,一颗真实视差 1 毫角秒(一千秒差距)的星,观测视差 0.983,取倒数得 1017 秒差距——距离被拉近 1.7%;对 100 秒差距的近星只偏 0.17%。同一个零点,远星受害十倍,这就是为什么远距离样本用视差前必须先做零点改正;改正表按星等与颜色分档发布,使用者要按自己样本的分布取对应档位,而不是全体套一个平均数。
做预算时永远要问一句:我的系统项有没有被某种空白对照约束过?
常见困惑解答
误差棒里的正负号是标准差还是别的
视差表里的正负号通常是标准差(一倍标准差),真值有约三分之二概率落在区间内。它描述随机误差的水平;系统偏移不在这个数里,要用零点改正、外部对照另行管理。使用别人的星表时,先查它有没有发表系统误差的改正方案,比查误差棒数值更重要。
为什么昴星团的误差会相关
同一片天区的星共享同一批观测几何、同一份仪器状态、同一片参考星,单个星的误差看起来独立,团尺度上却同步起伏——相关系数接近一的结构性偏差。平均一百颗星不会把它缩小,因为它不是噪声是偏移。这就是"团是天体测量学的试金石"的原因:团把系统误差放大成可见的距离差。
预算表做完就一劳永逸吗
不是。预算是观测前的预言,观测后的残差分析是复核:残差的均方根与预算对不对得上、残差随天顶距或颜色有没有趋势。对上了预算闭环;对不上说明清单漏了项或量级估错,回头改。4.3 节的最小二乘解算会把这套复核流程完整走一遍。
要点速记
- 一条铁律:随机误差按平方根收敛、系统误差趴在地板不动,堆次数只买前者的改进;
- 一条法则:独立误差平方和开根合成,30 次曝光的算例从 13 毫角秒合到 7.5 毫角秒;
- 精密度不等于准确度:Hipparcos 昴星团 133 对 120 秒差距之争是系统误差的经典案例,Gaia 落锤在 120 秒差距;
- 四种武器:条件随机化、建模改正、差分设计、外部校验;类星体是视差的完美空白对照;
- 预算表是循环而非表格:观测前预言,观测后用残差复核,对不上就改清单。
下一节走归算链条:从像素坐标经改正项与底片模型到天球坐标序列——那是 4.3 节最小二乘的输入。