6.1 从采样到可靠数据:样品采集前处理与质量控制
6.1 从采样到可靠数据:样品采集前处理与质量控制
本节摘要:环境分析最深的陷阱,往往不在仪器贵不贵,而在“样品是否代表真实环境”。本节先把“从现场到报告”的全链条摆开:怎么设计代表性采样(网格、分层、随机),怎么保存不造假(冷藏、酸化、避光),怎么前处理浓缩净化(SPE、液液萃取、微波消解);再讲质量保证(QA/QC)如何用空白、平行、加标回收与标准曲线,给每一个读数上保险。读完你能一眼看出某份报告的数据是否“经得起再审”。
本节应掌握
阅读完本节,你应当能够:
- 设计一份能代表真实环境的水、土、气采样方案。
- 说明不同前处理方法的适用对象与作用。
- 解释空白、平行、加标的作用与判据。
- 用线性标准曲线从响应值反算浓度。
- 判断一份分析数据是否可信、能否作决策依据。
一、采样:所有结论的笑点与死穴
一个只测到某处下午一点的水样,无法代表整条河;一块胡乱取的土壤样品,可能既不代表表层也不代表深层。采样的三原则是代表性、随机性与足够的样本量。水体要按断面与深度分层采集,土壤要按网格或判断选点,气体要考虑时间与气象——每一个看似繁琐的动作,都是在给“反推”贡献唯一真实的输入。
二、前处理:把目标物从噪声里“捞出来”
环境样品里的目标物往往浓度极低,且被大量基质包裹。前处理的使命,就是把它分离、富集、净化到仪器能测的量级。固相萃取(SPE)利用吸附剂选择性留住目标物再用少量溶剂洗脱;液液萃取按两相分配把目标物转到另一相;微波消解用高温强酸把重金属从固体彻底溶出。选哪一步,取决于目标物是挥发性、极性还是金属态。
三、质量保证:让每一个数都诚实
数据可信与否,不是看仪器漂不漂,而是看 QA/QC 有没有做足。四项基本功是:空白(没样品,检验是否沾污)、平行(同一样品做几份,看重复性)、加标回收(加入已知量再测,看准不准)、标准曲线(由已知浓度建立响应关系,反推未知浓度)。
# 标准曲线最小二乘拟合+未知样反算浓度 conc = [0, 1.0, 2.5, 5.0, 8.0] # 标准浓度 resp = [0.0, 0.12, 0.30, 0.62, 1.01] # 响应值 import numpy as np slope, intercept = np.polyfit(conc, resp, 1) unk = 0.48 # 未知样响应 c_unk = (unk - intercept) / slope print(f"标准曲线 响应= {slope:.3f}*浓度 + {intercept:.3f}") print(f"未知样响应 {unk} → 浓度 {c_unk:.2f} 单位") # 加标回收率检查 spiked_theoretical = c_unk + 2.0 # 加标2.0单位 spiked_measured = 2.10 recovery = (spiked_measured - c_unk) / 2.0 * 100 print(f"加标回收率 ≈ {recovery:.0f}%(80-120% 视为可接受)")
回收率跌出 80 到 120% 的范围,预示着要么前处理有损失、要么基质有干扰,这时候再好的仪器也救不回这组数据的可信度。所以环境分析圈有一句糙话:数据要么可信到能作执法,要么就别拿出来。
四、一张“样品到报告”的可信管线
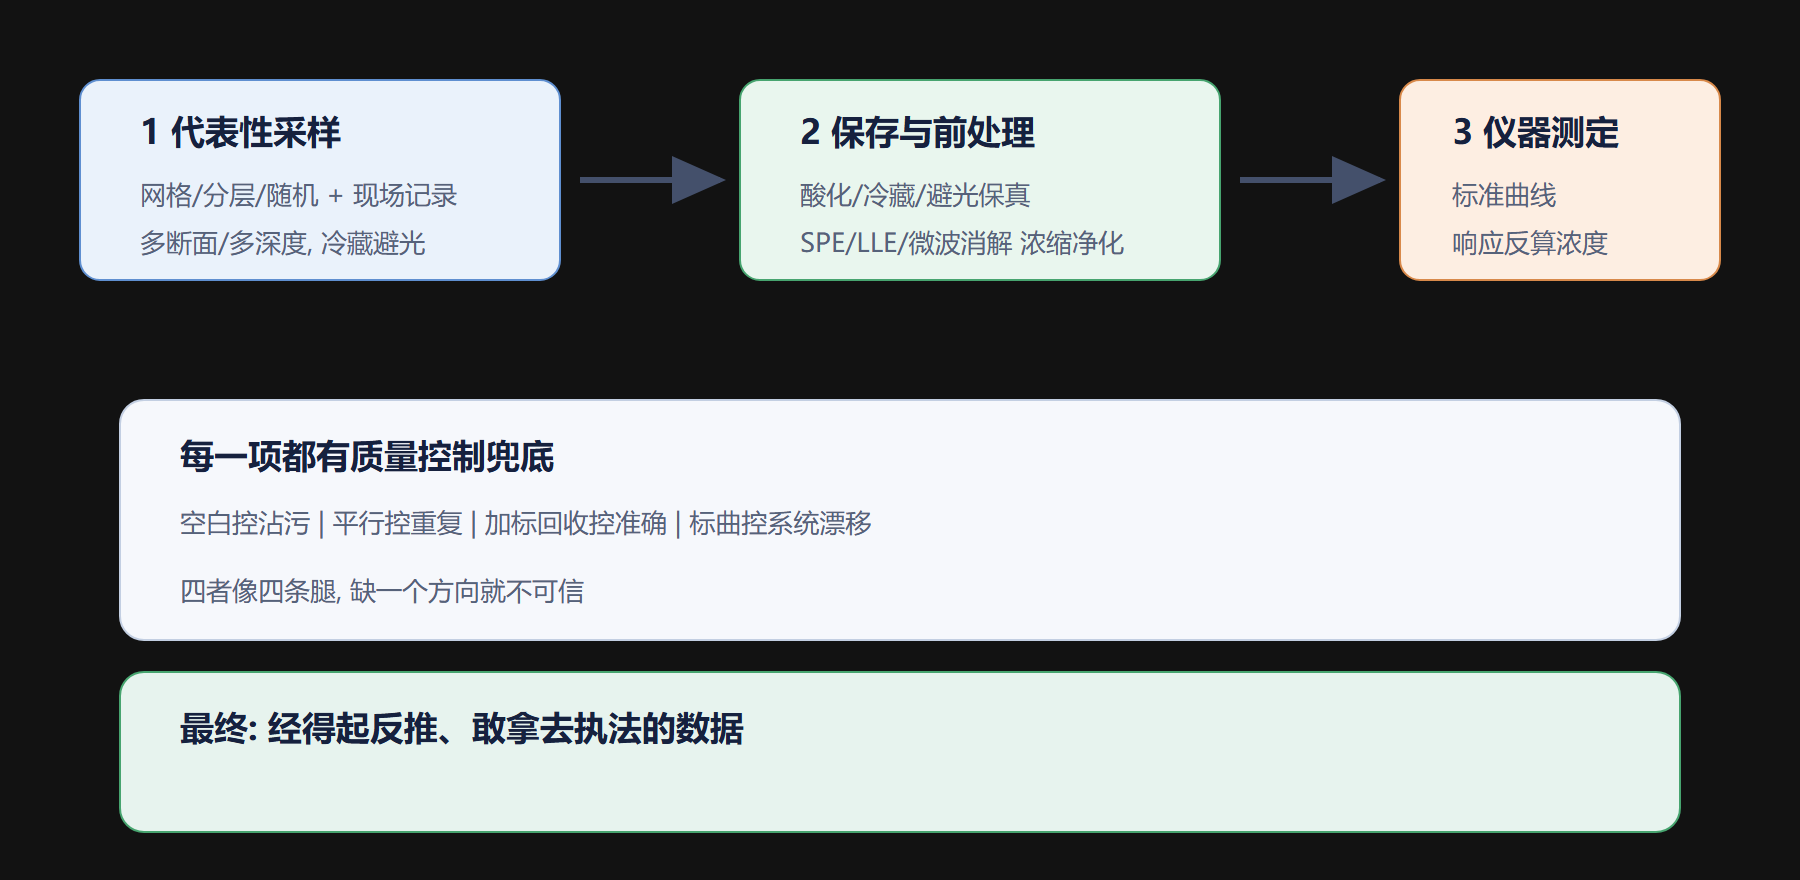
图:从样品到报告的 QA/QC 可信管线
采样、前处理、测定三环有四大质控兜底,才成可信数据。
五、真实案例:一次“达标”却不可信的水质报告
某跨流域水量评估曾因采样不规范(只在晴天白天取样、且未做空白与加标)被质疑,复核时发现加标回收严重离群、平行样波动大,整组“达标数据”被推翻重做。事件说明:一份漂亮的报告单若没有质量控制背书,反而是最危险的假象。真正的环境分析,是把质量保证写进每一个样品的“籍贯”,而不是只追求“测出数字”。
务必记住,分析方法的“受理上限”取决于从现场到仪器的整套流程,而不只是最贵的那台仪器。现实里不少争议都出在“测得很准、取得很差”:样品放错了容器、漏加了固定剂、保存超了时限,都会让后续诺贝尔级手段也白费。建立并遵守一份写进作业指导书的标准操作,比偶发的灵感可靠得多——这正是环境分析区别于一般化学实验的纪律所在。
本节要点回顾
- 采样三原则:代表性、随机性、样本量,直接决定结论可信。
- 前处理:SPE、LLE、微波消解分别应对有机/分配/无机样品。
- QA/QC 四腿:空白、平行、加标回收、标准曲线缺一不可。
- 标曲反算:实测响应经线拟合反求未知浓度。
- 回收判据:80 到 120% 之外慎下结论,先查前处理或干扰。
- 案例:无质控背书的“达标”数据,复核后被全盘推翻。