6.1 DNA 的复制
6.1 DNA 的复制
本节摘要:DNA 复制按"每条旧链作模板、合成新互补链"的半保留方式进行。本节讲解旋、引物、聚合酶按 5'→3' 合成、以及前导/后随链的分开处理,并重点算两笔账:复制错误率到底多低、人类基因组复制一遍要多长时间。由此理解"DNA 既稳又可突变"的双重性,并把端粒损耗、校对失调与衰老和癌连起来。
学习目标
阅读完本节,你应当能够:
- 复述半保留复制与"新链靠旧链配对"的原则
- 描述 DNA 聚合酶只按 5'→3' 延长的机制后果(后随链有冈崎片段)
- 说明校对机制(聚合酶 3'→5' 纠错 + 碱基选择)如何压低错误率
- 用算例估算复制错误率与每代突变数
- 指出端粒为何在真核线性染色体末端"越抄越短"
一、半保留:旧链当模板
复制开始于起点双链解旋。解旋酶把两条链分开,单链结合蛋白稳住,引物酶放短路引物,然后 DNA 聚合酶沿模板合成互补的新链。因为化学上聚合物只能从一个方向加长,所以两条链里一条能顺着解旋方向连着写(前导链),另一条要逆着方向、分批写再连起来(后随链的冈崎片段)。最终每个子代双链都是"一条旧+一条新",即半保留复制。
# 复制错误率叠加:碱基选择 3'→5' 校对再降一个量级 base_select = 1e-5 # 碱基选择本身出错率 proofread = 1e-2 # 校对再兜住99% error_rate = base_select * proofread print(f"复制最终错误率数量级: {error_rate:.0e} /碱基") genome_bp = 3.1e9 mutations_per_gen = error_rate * genome_bp * 2 print("每人每代引入的新突变约:", f"{mutations_per_gen:.0f} 个")
这段算式把"低错误率"拉到肉眼可见:约十的负七次方到负八次方。两个量级相乘非常关键——单独靠碱基选择是 1e-5,不够;加上校对压到 1e-7~1e-8,遗传才能稳定得下来,同时仍给进化留一点点突变口。这正回答了"稳定与可变如何兼得"。
二、复制一趟要多久:一个数量级直觉
知道"有多准"还不够,还要知道"有多快"。人类基因组约三十亿碱基,真核复制靠多个复制起点并行开叉。我们算一算若只靠单起点要多久、并行要多久。
def replication_time(bp, fork_speed, origins): # 每叉向两侧延伸 各 fork_speed bp/s;并行 origins 个起点 per_fork = bp / (origins * 2) seconds = per_fork / fork_speed return seconds, seconds/3600 for origins in [1, 1000, 30000]: sec, hr = replication_time(3.1e9, 50, origins) print(f"起点数约 {origins:>7,} → 单叉均摊复制需 {sec/60:,.0f} 分钟")
单起点要几个月,而真核启动几千上万复制原点后,只需几小时的量级——这就是"复制"能从一套基因组小步快跑地在细胞周期内完成、又不会因太快而处乱出错的关键。它也解释了为什么复制起点缺陷或复制压力会直接拖累 DNA 保真。
三、后随链与冈崎片段:方向带来的别扭
因为只能 5'→3' 延长,后随链必须"反向分批、越打越近"地用冈崎片段拼起来,再靠 DNA 连接酶把缺口焊上。这个别扭是理解复制的必经山口:不是细胞想复杂,而是聚合物化学就只给你一个加长方向。前导链连着写、后随链分段写,孰先孰后、谁补缺口,都由同一套酶在复制叉两侧分头完成。
四、端粒:线性染色体的"越抄越短"
线性真核染色体末端无法被常规聚合酶补全(缺引物也没法在链尽头补),于是每复制一轮,端粒就更短一点。干细胞/生殖细胞用端粒酶延长回来,而体细胞大多没有,压到某个长度就进入衰老/停止分裂。
def telomere_shrink(start_len, bp_off_per_division, divisions): return max(0, start_len - bp_off_per_division*divisions) for div in [0, 30, 60, 90]: print(f"分裂 {div:>2} 次后端粒长度 {telomere_shrink(15000, 100, div)} bp (示意)")
数十轮分裂后端粒从一万五掉到几千 bp,这个"倒计时"是细胞复制上限(海佛烈克极限)的分子体现。癌变细胞常"重启"端粒酶而永生——把"复制机制"与"寿命、衰老、癌"直接焊在一起,也是为什么许多抗衰老与抗癌研究都盯着端粒酶这一根"续命酶"。
图 6-1 DNA 复制叉
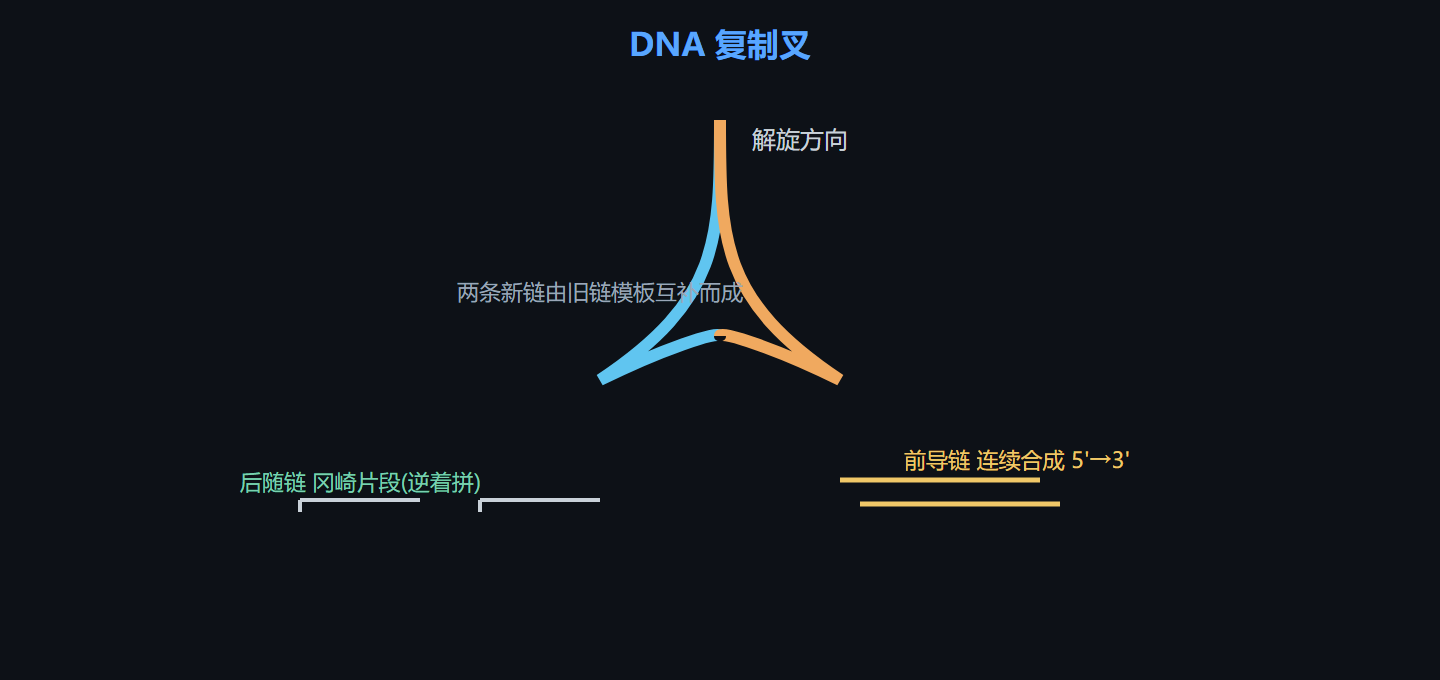
图中区分出前导链连续、后随链分段的复制叉,再叠加线性末端端粒损耗的影响,就是真核复制的全貌。
五、临床落点:校对缺了会走向癌
复制相关蛋白(如聚合酶校对相关基因)缺陷会抬高出错率,直接与部分早发肿瘤相关——"抄错被癌症逮住"正是这种机制的放大版。理解复制保真的量级,就能明白为什么化疗的烧 DNA 药与遗传性肿瘤综合征都能在这条线上对上号。癌细胞往往需要压掉修复机制才能积累足够突变,这让"DNA 修复/复制"同时成了癌症发生与药物靶向的关键闸门。
本节要点回顾
- 半保留复制:旧链做模板,新链互补配出,子代含一旧一新。
- 方向限制:只 5'→3',后随链靠冈崎片段反补,连接酶收口。
- 错误率可算:选择+校对把错误压到约 10 的负7次方/碱基。
- 速度可算:真核靠数千复制原点并行,几小时内复制完整个基因组。
- 端粒倒计时:线性末端越抄越短,与衰老、癌细胞端粒酶重启挂钩。
- 临床:校对失调→突变累积→部分早发肿瘤。