8.1 生物大分子的分离与光谱技术
8.1 生物大分子的分离与光谱技术
本节摘要:研究蛋白/核酸,第一步常是"把它从混汤里挑出来、再确认是不是它"。本节先讲电泳、层析、超离心的原理与选择,再讲紫外吸收、荧光、质谱、NMR 各"看"什么。算例给出多段脚本:如何用 A280/比尔-朗伯定律估蛋白浓度、如何用 SDS-PAGE 双 marker 估分子量、如何用 A260 估核酸纯度、如何用标准曲线把荧光信号换成数量——把"测浓度、验纯度"变成可复现的算术。
学习目标
阅读完本节,你应当能够:
- 依据分子大小/电荷/亲和选电泳或层析
- 说明离心和凝胶层析按分子量分离的原理
- 用比尔-朗伯定律与消光系数算蛋白浓度
- 区分紫外、荧光、质谱、NMR 各自的信息类型
- 选出"定量"与"鉴定"该用哪种手段
一、先分开:电泳、层析与离心
按分子量干活用凝胶电泳(SDS-PAGE 让蛋白变性挂排成一排按大小走)、凝胶过滤层析(大分子先冲出)。按电荷可用等电点聚焦或离子交换;按特异性结合用亲和层析(抗体抓抗原、镍柱抓 His 标签);密度梯度离心则把颗粒按密度分层。
import math def estimate_mw(distance, markers): (d1,m1),(d2,m2) = markers logmw = math.log(m1)+(math.log(m2)-math.log(m1))*(distance-d1)/(d2-d1) return math.exp(logmw) # 双 marker 线性拟合估未知条带分子量 print("SDS-PAGE: 双 marker 对数拟合可估未知带分子量 Da):", round(estimate_mw(45, [(52,66000),(22,14000)])))
这套"对数分子量–迁移距离近线性"是 SDS-PAGE 估带分子量的依据:因为 SDS 让蛋白都带相同电荷密度、按分子筛效应顺大小走。真实里能否分辨,还取决于胶浓度、电压与蛋白状态,但"带位→分子量"这条换算链是关键。
二、测浓度:比尔-朗伯定律
多数蛋白在 280 纳米处因芳香族氨基酸(色/酪)吸收紫外,吸光度与浓度成正比:A = ε·l·c。知道了消光系数(或按残基估算),A280 就能直接换出浓度。
def conc_from_A280(A280, epsilon_M, l=1.0): return A280 / (epsilon_M * l) # M def mg_per_ml(c_M, molwt): return c_M * molwt / 1000 A280 = 0.5 eps = 25000 # M^-1 cm^-1,常见量级 c = conc_from_A280(A280, eps) print(f"A280={A280:.2f} → 浓度约 {c*1e6:.1f} 微摩尔/升") print("若分子量 50 kDa,对应质量浓度 ≈", f"{mg_per_ml(c, 50000):.2f} mg/mL")
这个"一测吸光度就算浓度"的路子贯穿整个蛋白纯化和质检。若蛋白没芳香残基(少见),才考虑测 A205 或染料法。核酸侧,A260 同理可算浓度,而 A260/A280 比值则是常用的纯度/质量指示——DNA 约 1.8、RNA 约 2.0 这组标尺你要记牢。
def dna_conc_nanodrop(A260, f=50): # 双链 DNA 常用 50 µg/mL per A260,单链/RNA 另有系数 return A260 * f A260 = 1.2 print(f"A260={A260} → 双链DNA浓度 {dna_conc_nanodrop(A260):.0f} µg/mL")
三、鉴定:从"是多少"到"是谁"
要判"是不是这个蛋白"、结构如何,常用:
- 荧光/标记:灵敏度高,用于定位与活体成像。
- 质谱(MS/蛋白组学):打碎成肽段按质荷比识别序列——这是蛋白鉴定的主力。
- NMR/晶体学/冷冻电镜:拿原子级结构。NMR 可在水溶液看动态,晶体与电镜拿到高分辨率三维图。
def ms_peptide(mz, charge, addon=1.007): # 质子加合 return (mz - addon) * charge # 由质荷比还原出中性肽段质量 mz, charge = 850.4, 2 print(f"质谱峰 m/z={mz}, 电荷={charge} → 中性肽段质量约", f"{ms_peptide(mz,charge):.1f} Da")
质谱是把一个"看不太清的蛋白"变成一串可查库的肽段质量:打碎→测质荷比→反推残基序列→比对数据库,从而"显得是谁"。这是现代蛋白鉴定与蛋白组学的底层逻辑。
图 8-1 分离到鉴定的流程
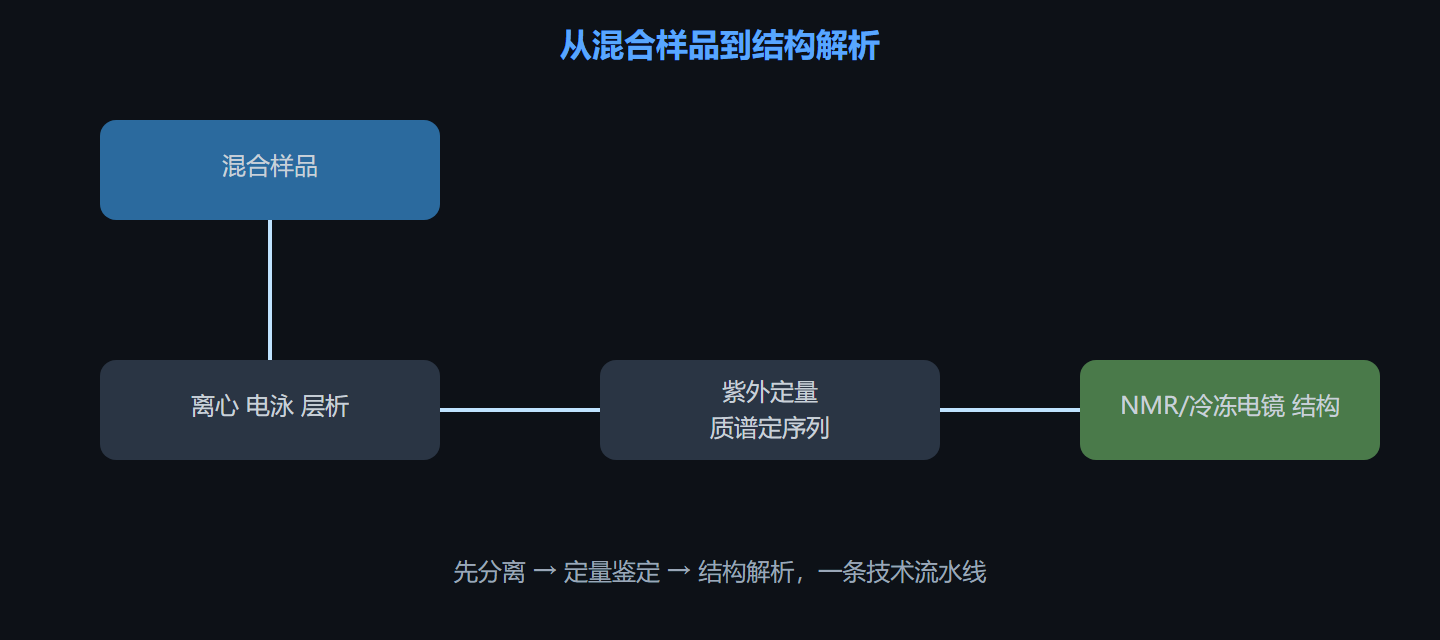
这张流程把"拿到纯分子"和"确认是谁/长什么样"串成一条生产线,生化实验室的大部分日常都在这条线里。
四、定量要靠标准曲线:从比值到回归
光测绝对吸收还不够,很多实验是用已知浓度的标准品作图,把未知样品的读数插进去换数值,荧光、ELISA、Bradford 蛋白测定全都是这个套路。标准曲线的核心是一个假设:读数与数量近似线性,且工作范围内误差小。
def std_curve(reading, slope, intercept, noise=0): amount = (reading - intercept) / slope if noise and amount < 0: return 0.0 return amount # 以 A595 读数换蛋白质量(Bradford 法示例) for a595 in [0.2, 0.5, 0.9]: print(f"A595={a595} → 蛋白量约 {std_curve(a595, 0.8, 0.02):.2f} µg")
标准曲线的适用范围有边界:浓度太低会落在灵敏度之下(噪声主导),太高会偏离线性(比尔-朗伯失效或信号饱和)。所以真正做定量的人总在"线性范围"里取点,而不是无脑外推。理解这一条,你就懂了为什么 ELISA 报告中要标出"检测限"和"定量限"——它们是这一段线性区域的边界刻度。
五、临床/实验落点:从化验单到蛋白组
临床上很多生化指标(血清酶、蛋白、PCR 产物浓度)都靠这套"分离+定量"实现。而把成百上千蛋白一口气都测一遍,就是第 8.2 的蛋白质组学。所以本节是"单分子怎么看",下一节是"全谱怎么打"。
本节要点回顾
- 方法按性质选:大小用电泳/凝胶过滤,电荷用离子交换,特异性用亲和层析。
- A280 可算浓度:比尔-朗伯 A=εlc,消光系数已知即可;A260/A280 验核酸纯度。
- 质谱可算:由质荷比+电荷还原肽段质量,是蛋白鉴定的主力。
- 定量靠标准曲线:未知读数经回归换成数量,只在线性范围内有据。
- 鉴定看结构谱:质谱定序列、NMR/晶体/冷冻电镜拿结构。
- 临床接口:许多化验本质是这里的定量/分离。