6.1 系综理论与配分函数
6.1 系综理论与配分函数
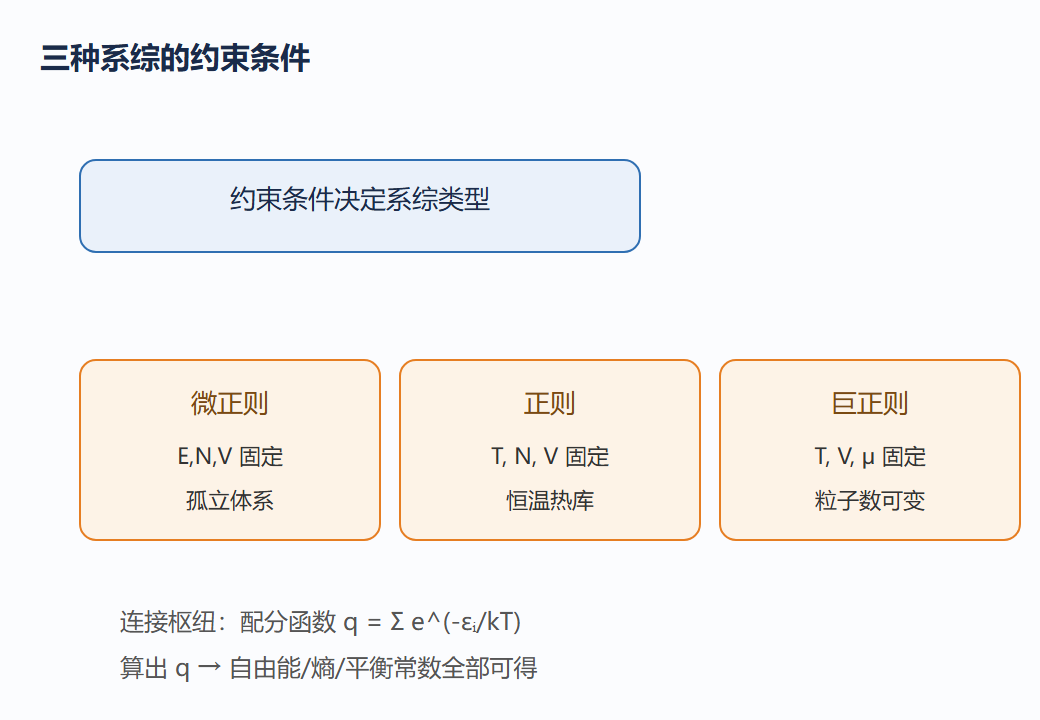
本节摘要:统计热力学的目标是把宏观热力学量从微观粒子行为"算出来"。它把思路反过来——先假设大量等同体系的集合(系综),再统计微观状态按能量的分布,得到玻尔兹曼分布。配分函数 q = Σ e^(-εᵢ/kT) 是这个学科的心脏:只要算出配分函数,几乎能推出所有宏观量。系综分微正则系综(孤立体系)、正则系综(恒温热库)、巨正则系综(恒温恒化学势)。本节从"为什么需要统计"出发,聚焦配分函数如何搭建微观到宏观的桥梁。
学习目标
阅读完本节,你应当能够:
- 解释为什么宏观量无法从单个微观态直接推出,而要靠统计
- 写出玻尔兹曼分布并说明各个量含义
- 定义配分函数并说出它连接了哪些热力学量
- 区分三种系综的适用条件(孤立/恒温/恒温恒化学势)
一、从一粒分子到一摩尔粒子
1 摩尔气体含约 6×10²³ 个分子。哪怕只有一个反应,也涉及天文数字的微观状态。你无法像解两体问题那样逐个跟踪,必须借助统计——用"最概然分布"来描述宏观上会呈现的状态。关键是意识到:宏观可观测的性质,其实是对海量微观状态的平均。
这片"平均"的数学工具就是系综。所谓系综,不是真实存在的分子,而是"与所研究体系条件相同的大量假想复制品"组成的一个集合。物理量等于对系综平均,处理方式完全转化为概率论问题。
二、微观与微正则:先看孤立体系
最简单的情形是微正则系综:体系孤立、能量 E 固定、粒子数 N 固定、体积 V 固定。宏观条件确定后,微观状态数 Ω(E,V,N) 就定了。玻尔兹曼在墓碑上留下的那个公式 S = k ln Ω 正是从这里来——熵是微观状态数的自然对数。孤立体系趋向平衡,就是在微观状态数最大的分布处达到最大熵。
三、正则系综与玻尔兹曼分布
现实里很少完全孤立,体系通常贴着常温热库。正则系综就是恒温(T)恒粒子数描述的集合。推导后可得到玻尔兹曼分布:在温度 T 的平衡态,处于能量 εᵢ 微观状态的概率正比于 e^(-εᵢ/kT)。这个指数吃透它,统计热力学就成功了一半。
配分函数把"概率的归一化"写成 q = Σᵢ e^(-εᵢ/kT)。用配分函数算玻尔兹曼分布更方便:pᵢ = e^(-εᵢ/kT)/q。且配分函数几乎通向一切宏观量:自由能 A = -kT ln q、熵 S = k(∂T ln q/∂T) 等。可以说"算配分函数"= "做统计热力学"。我们写代码,对一盒能在几个能级上分配的粒子直接求出分布与配分函数,体会"温度越高、高能级占比越大"这个核心直觉。
import math def boltzmann_dist(T, eps, k=1.0): """给能级列表 eps 和温度,返回玻尔兹曼分布""" w = [math.exp(-e/(k*T)) for e in eps] q = sum(w) return [x/q for x in w], q eps = [0.0, 1.0, 2.0, 3.0] # 简化能级, k=1 for T in [0.5, 1.0, 5.0]: p, q = boltzmann_dist(T, eps) print(f"T={T:4.1f} q={q:6.3f} 分布=" + " ".join(f"{x:.3f}" for x in p))
低温时几乎全铺在基态(0 能级概率接近 1),随温度升高高能级占比逐步上升,配分函数 q 也在变大。这个"温度拉升高能级占比"的直觉,正是热容、化学平衡标么系数的一切来源。
四、巨正则系综:粒子数也在变
想把开放体系(粒子数可流进流出)也覆盖,就用到巨正则系综:外加温度和化学势两个"荷"。它丢进一个化学势因子 e^(μN/kT),得到的巨配分函数能处理化学势参与的过程——这在相变、吸附、电子气的处理中非常关键。三种系综在热力学极限(粒子数趋于无穷)下给出一致的宏观量,不必纠结哪个更"正确",按方便选即可。
6.1 图:三种系综按约束条件划分
五、与其他章节的关联
统计的热力学量推导(第6.2 节)和理想气体/晶体的具体计算(第6.3 节)都以本节配分函数为出发。而与第2 章宏观热力学严格对应的,正是"配分函数算出的量与热力学表"吻合这一事实——它证明了统计与热力学互为印证。化学平衡常数、相变临界现象也有统计根源。
本节要点回顾
- 统计的意义:宏观量是海量微观态的统计平均,靠系综求平均
- 微正则系综:E,N,V 固定,S = k ln Ω,孤立体系平衡对应最大微状态数
- 玻尔兹曼分布:pᵢ ∝ e^(-εᵢ/kT),温度越高高能级占比越大
- 配分函数:q = Σ e^(-εᵢ/kT),一通百通,几乎所有宏观量都从它导出
- 巨正则系综:T,V,μ 固定,处理粒子数可变体系,三种系综在热力学极限一致