2.1三阶段工作流总览
2.1 三阶段工作流总览
为什么需要三个阶段
Prettier 的核心流程由三个阶段组成:解析(Parsing)、构建中间表示(IR 构建)、布局打印(Printing)。理解为什么是"三个"而不是"一个"或"两个",是理解整个架构的关键。
如果只有一步——直接在源代码文本上做字符串替换——你会遇到的问题前面说过:字符串操作不理解代码结构,处理不了嵌套、条件、递归等复杂模式。这是早期格式化工具的做法。
如果只有两步——解析成 AST 后直接打印——你确实能获得结构化的理解,但"打印"这件事本身比看起来复杂。一个简单的变量声明 const x = 1; 打印很简单,但一个多层嵌套的函数调用 foo(bar(baz(qux(1, 2), 3), 4), 5),要决定在哪里换行、缩进多少、要不要在行尾加逗号,这就不是一个简单的"遍历 AST 节点"能解决的任务了。
Prettier 的解决方案是在 AST 和最终输出之间插入一个中间层——Doc IR。这个中间层把"代码长什么样"的问题和"代码逻辑是什么"的问题彻底分离开来。AST 只关心逻辑结构,Doc 只关心排版布局,最终输出只关心字符串拼接。
这种分离类似于编译原理中的经典设计:词法分析、语法分析、语义分析、代码生成,每个阶段各管一摊。在 Prettier 的场景里,三个阶段各司其职:
解析阶段回答"这段代码的语法结构是什么?"它把字符串变成一棵树。
Doc 构建阶段回答"这棵树对应的排版意图是什么?"它把树变成一个由排版指令组成的文档。
打印阶段回答"在给定的行宽约束下,这个文档的最优布局是什么?"它把排版意图变成具体的字符串。
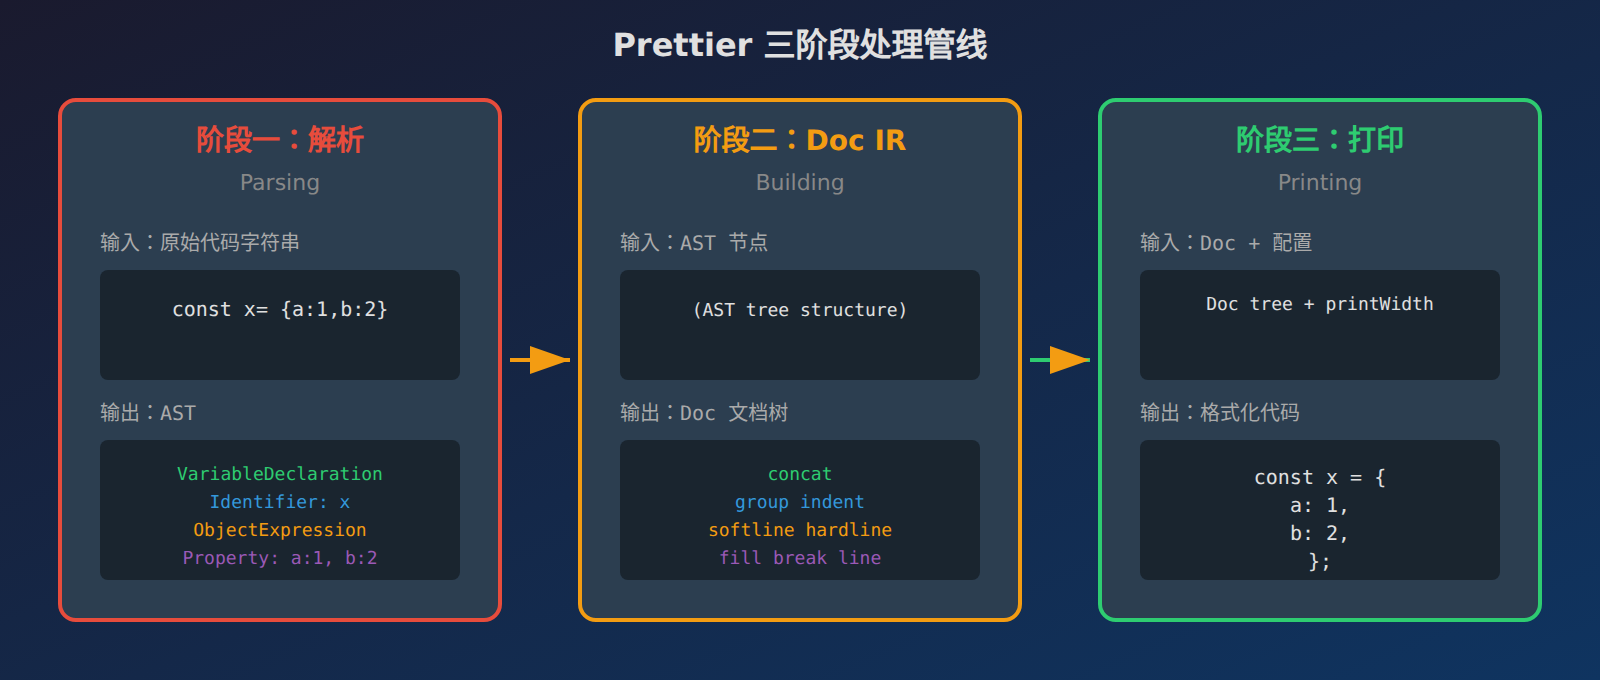
图 2-1:Prettier 三阶段处理管线详解
一个完整的示例追踪
让我们追踪一段具体代码的完整处理过程,看看每个阶段做了什么。
输入代码:
const result = calculate(totalPrice, discountRate, taxRate, shippingFee)
第一阶段输出:AST
解析器(Babel)把这段字符串转换成 AST。简化后的结构:
VariableDeclaration - kind: "const" - declarations: VariableDeclarator - id: Identifier { name: "result" } - init: CallExpression - callee: Identifier { name: "calculate" } - arguments: Identifier { name: "totalPrice" } Identifier { name: "discountRate" } Identifier { name: "taxRate" } Identifier { name: "shippingFee" }
注意 AST 中的信息只有结构——变量声明、标识符名称、函数调用的参数列表。没有空格、没有换行、没有分号。const result 和 const result 产生完全相同的 AST。
第二阶段输出:Doc IR
Prettier 的 AST-to-Doc 转换器遍历这个 AST 节点,生成排版指令。简化后的 Doc 结构:
concat([ "const ", "result", " = ", group([ "calculate(", indent([ softline, join([", ", line], [ "totalPrice", "discountRate", "taxRate", "shippingFee" ]) ]), softline, ")" ]) ])
这段 Doc 指令的含义是:打印 const result = ,然后是一个 group("如果空间够就放一行,不够就换行展开"),组内是 calculate(,缩进一级后输出各参数(用逗号分隔,各参数间允许换行),关闭缩进,输出 )。
关键是 softline 和 group 的组合:softline 是"有机会换行"的意思——如果 group 里的内容在一行内放得下(不超过 printWidth),softline 就变成空字符串(不换行);如果放不下,softline 就变成真实的换行。
第三阶段输出:格式化字符串
打印算法拿到 Doc IR,结合 printWidth: 80 的配置,尝试两种布局:
紧凑布局(如果所有内容在一行内):
const result = calculate(totalPrice, discountRate, taxRate, shippingFee);
检查行宽:这行共 75 个字符,不超过 80。紧凑布局可行,采用这个输出。
如果把 printWidth 改成 60,同一行放不下了,算法会选择换行布局:
const result = calculate( totalPrice, discountRate, taxRate, shippingFee );
这就是同一个 Doc IR 在不同配置下产生不同输出的过程。Doc 本身不变,变的只是布局算法的决策。
三阶段设计的核心优势
这种三阶段设计有几个关键的技术优势:
语言无关性。解析器和打印机是分离的。只要有一个解析器能把某种语言的代码变成 AST,Prettier 就能格式化它——因为 Doc IR 和打印算法是通用的。这就是为什么 Prettier 能支持 JavaScript、TypeScript、CSS、HTML、JSON、Markdown、GraphQL 等这么多语言,每种语言只需要一个解析器插件。
确定性。给定相同的 AST 和相同的配置,打印算法永远输出相同的结果。没有随机因素,没有启发式判断,只有纯粹的算法决策。
可测试性。每个阶段可以独立测试。你可以写测试用例验证解析器的 AST 输出、Doc 转换器的 IR 输出、打印器的字符串输出,问题定位非常精确。
配置的影响范围有限。用户的配置(如 printWidth、tabWidth)只影响第三阶段的布局算法,不影响解析和 Doc 构建。这意味着格式化的"意图"(哪里可以换行、哪里应该缩进)是固定的,只有最终的布局参数是可调的。
理解了这个架构,你就理解了为什么 Prettier 的行为总是可预测的,以及为什么它的大部分选项不可配置——那些选项不是布局参数,而是结构意图,它们应该由 Doc 构建逻辑固定下来。