5.1大规模仓库性能优化
5.1 大规模仓库性能优化
Monorepo 的规模挑战
当代码库的规模增长到几十万甚至上百万行时,Prettier 的性能会成为一个实际问题。Monorepo(单体仓库)的流行——Google、Meta、Microsoft 都在使用超大型 Monorepo——放大了这个挑战。
Prettier 处理一个文件的流程是:启动 Node.js 进程 → 加载配置和解析器 → 解析文件 → 构建 Doc → 打印输出。当文件数量从几百增长到几万时,这个过程的总时间会线性增长,可能从几秒变成几分钟。
几秒的格式化时间在日常开发中可以接受,但几分钟就不可接受了——每次提交前跑 Prettier 都要等好几分钟,开发者会本能地想用 --no-verify 跳过,格式化的保障就失效了。
缓存策略
最直接的优化是缓存——只格式化自上次运行以来修改过的文件。Prettier 本身没有内置缓存,但可以通过外部工具实现。
.prettiercache。通过记录每个文件的最后修改时间和内容哈希,下次运行时跳过未修改的文件:
# 用 find + md5sum 实现简单的缓存检查 find src -name "*.js" -newer .prettier-cache | xargs npx prettier --write touch .prettier-cache
更健壮的实现可以用专门的工具如 pretty-quick:
npx pretty-quick --staged
pretty-quick 会检查 git 的变更记录,只对修改过的文件运行 Prettier。它比 lint-staged 更轻量——不需要安装额外依赖,直接在 pre-commit 中使用:
{ "husky": { "hooks": { "pre-commit": "pretty-quick --staged" } } }
增量检查
在 CI 中,增量检查的策略是:只检查本次 MR/PR 中涉及的文件,而不是全量检查。
- name: Get changed files id: changed run: | CHANGED=$(git diff --name-only origin/main...HEAD | grep -E '\.(js|ts|css|json|md)$') echo "files=$CHANGED" >> $GITHUB_OUTPUT - name: Format check if: steps.changed.outputs.files != '' run: npx prettier --check ${{ steps.changed.outputs.files }}
这种方式在 MR/PR 场景中效果很好,但对于直接推到 main 分支的场景(比如 release 分支合并),仍然需要全量检查——因为无法确定 main 分支上的代码是否全部格式化过。
Rust 重写的替代方案
Prettier 的性能瓶颈根本上是 Node.js 的性能瓶颈。Node.js 是单线程的 V8 运行时,虽然有 JIT 编译,但对于密集的字符串操作和树遍历,跟原生编译语言相比有数量级的性能差距。
dprint 是一个用 Rust 编写的代码格式化工具,它的架构借鉴了 Prettier(解析-转换-打印三阶段),但性能快 10-30 倍。对于一个 5 万文件的仓库,Prettier 可能需要 30 秒,dprint 只需要 1-2 秒。
dprint 的配置跟 Prettier 不兼容——它有自己的配置格式和规则集。但它支持通过插件扩展语言,并且提供了一个兼容 Prettier 部分配置的迁移工具。
dprint 目前在社区中仍处于小众地位——它的生态不如 Prettier 成熟,编辑器集成也不如 Prettier 完善。但随着 Monorepo 的普及,对高性能格式化工具的需求在增长,dprint 的采用率在逐步提升。
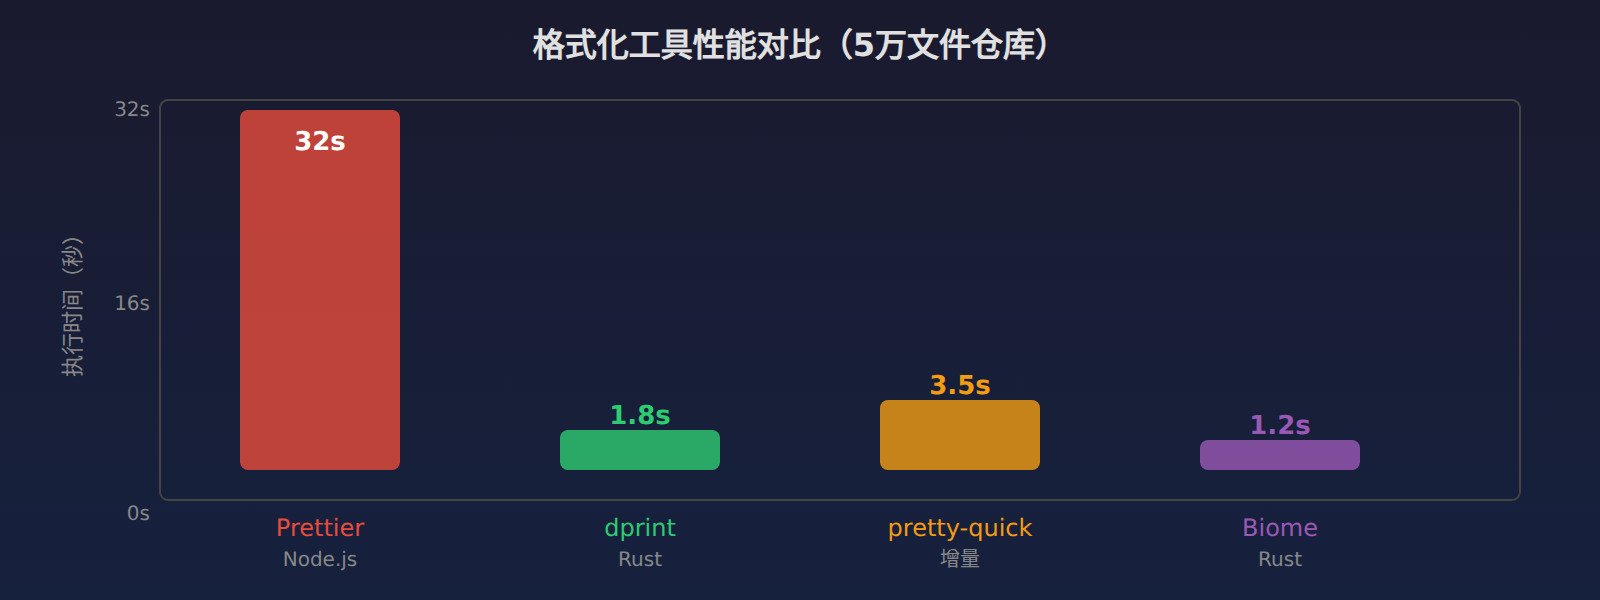
图 5-1:格式化工具性能对比
Biome:新一代工具链
Biome(前身 Rome)是另一个值得关注的方向。它用 Rust 编写,将 Linter 和 Formatter 合二为一。Biome 的目标是提供一个集成的、高性能的开发工具链,取代 ESLint + Prettier 的组合。
Biome 的格式化能力目前覆盖 JavaScript、TypeScript、JSON、CSS,性能远超 Prettier(因为它用 Rust 编写)。但 Biome 的格式化规则跟 Prettier 不完全兼容——在某些边缘情况下的输出会有差异。
Biome 的优势在于"一个工具搞定格式化和 lint",减少了配置和维护的复杂度。劣势在于生态不如 ESLint + Prettier 成熟——规则覆盖面不够全、社区插件不够多、编辑器集成还在完善中。
对于一个新项目,如果团队对性能有较高要求且不需要 ESLint 的高级规则,Biome 是值得考虑的选择。但对于已有大量 ESLint 自定义规则的成熟项目,迁移到 Biome 的成本可能比较高。
并行化与预热
Node.js 单进程处理大量文件时,可以按目录或按文件类型拆分,用多个进程并行跑,把多核 CPU 利用起来。xargs -P 是 shell 里最简单的并行方案:
# 用 8 个进程并行格式化 find src -name "*.js" -print0 | xargs -0 -P 8 -n 50 npx prettier --write
每个进程都启动一次 Node.js 运行时,所以 -n 50(每批 50 个文件)可以减少进程启动次数,比一次一个文件快得多。
另一个思路是预热:在 CI 或本地开发机启动时,预先跑一次全量格式化,之后所有增量操作都只碰变更文件。配合编辑器保存时格式化,真正需要"全量跑"的场景会越来越少。
测量格式化耗时
优化之前先测量。用时间命令包住一次全量运行:
time npx prettier --write .
time 输出的 real 时间就是总耗时。想细化到单文件,可以开启 debug 日志:
npx prettier --write . --loglevel debug 2>&1 | tail -20
把耗时数据记下来,和优化后的数据对比,才能判断缓存、并行、增量策略是否真的有效。一个常见的误区是:为了优化"全量格式化耗时"花了大量精力配置,但实际项目里全量格式化很少发生——日常都是编辑器保存时格式化单个文件。此时更该关注单文件格式化延迟(几百毫秒量级),而不是全量耗时。
缓存失效的边界
基于时间的缓存(find -newer 方案)有天然缺陷:如果文件内容变了但修改时间没变(比如 git checkout 恢复文件),缓存会漏掉它。基于内容哈希的缓存更可靠,但需要额外的文件状态存储。pretty-quick 按 git 状态判断,不受修改时间欺骗,但只适用于已纳入 git 管理的文件。
结论:缓存的目的是"日常开发快",不是"绝对正确"。格式化的正确性最终由 CI 全量检查兜底——缓存只是减少日常等待,不能替代检查。
实际建议
对于大多数项目(文件数在 1 万以内),Prettier 的性能足够好,不需要特殊优化。只有当格式化时间明显影响开发体验(每次提交前等超过 5 秒)时,才需要考虑缓存或增量策略。
对于超大型 Monorepo(文件数超过 5 万),建议评估 dprint 或 Biome 作为替代方案。这两个工具在性能上有数量级的优势,如果你的团队已经开始感受到 Prettier 的性能瓶颈,值得花时间做一个对比评估。