1.1 Qdrant 是什么
1.1 Qdrant 是什么
本节摘要:Qdrant 是一个开源的向量相似度搜索引擎,它以生产就绪的服务形态,通过简洁的接口存储、索引和检索带有效载荷的高维向量。它解决的是关系型数据库和全文检索都搞不定的一件事——按"语义相似"而不是"字面相同"来找数据。本节先讲清它为什么存在,再讲它到底怎么工作。读完本节,你能说清向量、嵌入、相似度搜索这几个核心词,并理解 Qdrant 在 AI 技术栈里扮演的角色。先立住这个定义,后面才能谈技术栈和特性。
学习目标
阅读完本节,你应当能够:
- 用一个身边的例子解释"语义相似"和"字面匹配"的区别
- 说清向量、嵌入、相似度搜索三者的关系
- 复述 Qdrant 的定位,并区分它和普通向量索引库
- 判断一个需求是不是该交给向量数据库来解决
一、问题与直觉
先从一个真实的小场景说起。你在一个知识库里搜"怎么延长手机电池寿命",传统的关键词检索会怎么做?它去文档里找同时出现"延长""电池""寿命"这些词的句子。写得好的文档里如果只出现了"省电技巧""功耗优化"这类说法,就搜不到,哪怕内容完全对口。
这不是检索系统偷懒,而是它的底层假设就错了。关系型数据库按字段精确匹配,全文检索按词形匹配,两者都只在"字面"层面工作。可人真正想问的,常常是"意思相近"。
问题来了:机器怎么理解"意思"?答案是把文字变成一串数字。一个嵌入模型读进一句话,吐出一个几百维的向量,比如 768 个浮点数。语义相近的句子,向量在空间里挨得近;语义无关的句子,向量离得远。于是"找相似"这个模糊的人类需求,被翻译成了一个数学问题:给定一个查询向量,在存量向量里找距离最近的那批。
接下来的问题就变成工程问题了:这些向量存哪、怎么建索引、怎么在几千万甚至几亿条里毫秒级地找到近邻。关系型数据库的 B 树索引是为"等于""范围"设计的,拿来查高维向量基本没法用。于是就有了专门干这事的数据库——向量数据库,Qdrant 是其中一个。
所以,Qdrant 并不是又一个什么都能存的通用数据库。它是那种只做好一件事的工具:把向量存进去,把"相似"的查出来,而且查得够快、够稳、够好接。理解了这个定位,后面讲它的技术栈和特性,就都有了一个参照系。
二、核心原理
理解 Qdrant,得先把三个词分清:向量、嵌入、相似度搜索。它们是一条流水线上的三个工位。
向量是一串有序的浮点数,是数据的数学化形态。一段文字、一张图、一段音频,都可以被压缩成这样的数字串。嵌入则是指"把原始数据变成向量"这个动作,通常由预训练的深度模型完成。而相似度搜索,就是在这堆向量里,按某种"距离"定义找出离查询向量最近的那一批。
Qdrant 站在这条流水线的后半段:它不负责生成向量,只负责高效地存和查。这个分工很关键,也经常被误解。有人以为向量数据库能自己"理解"文本,其实不能,理解是嵌入模型干的,Qdrant 只是那个把结果管理得井井有条的仓库管理员。
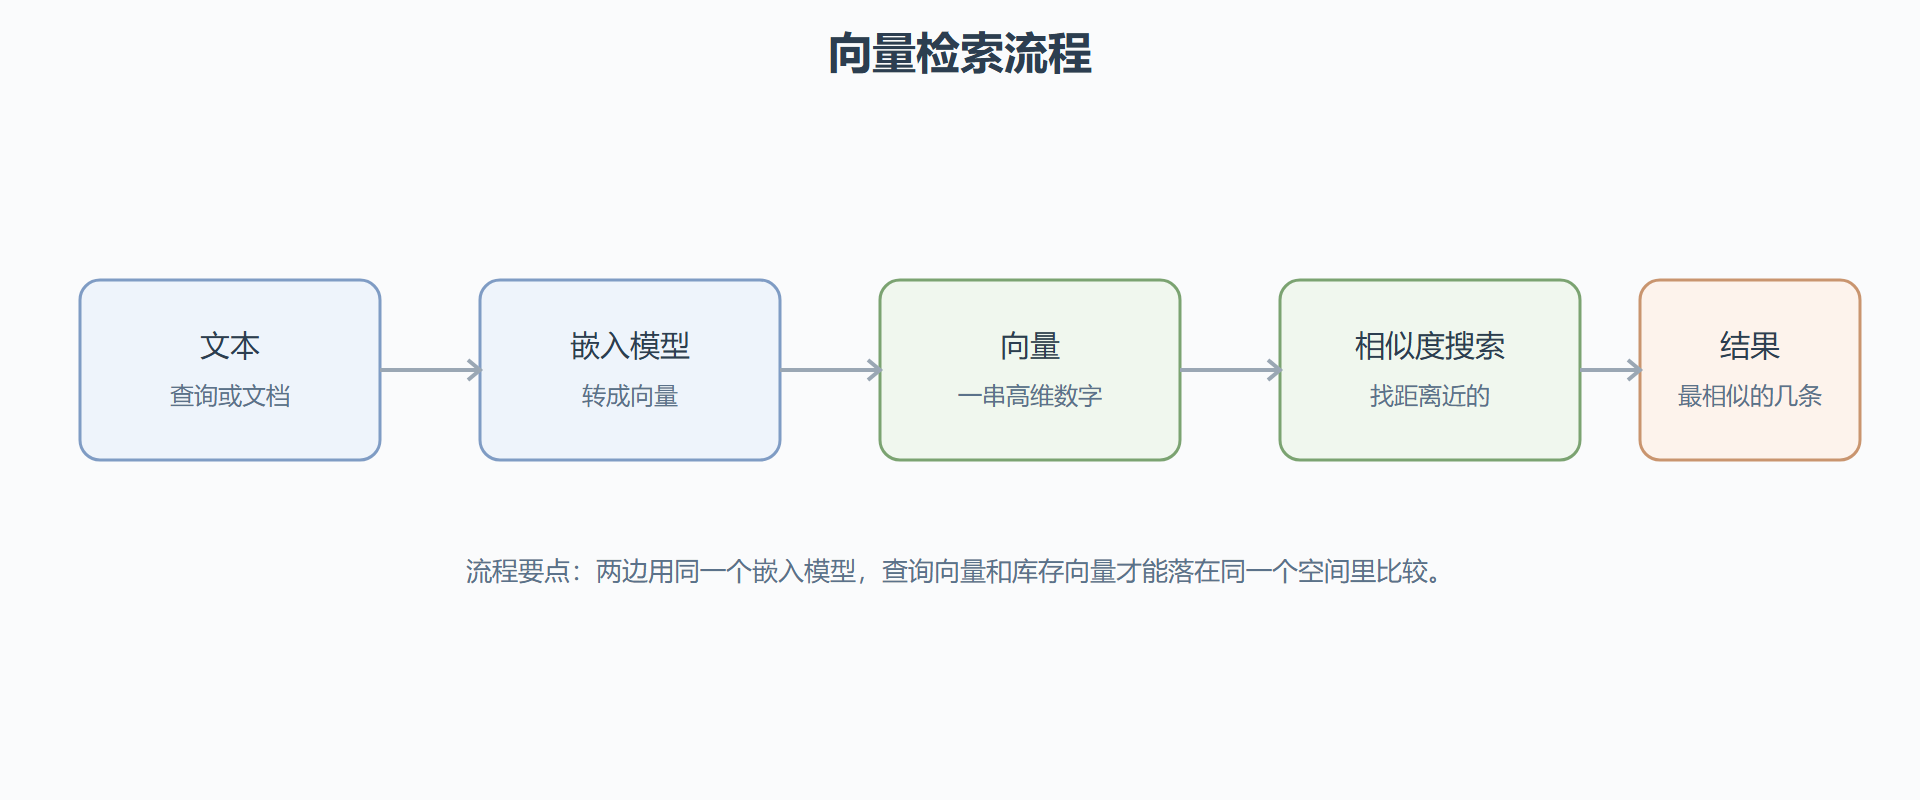
下面这张图把整条流程串了起来:文本先进嵌入模型变成向量,向量入库,查询时同样变成向量,再和库里的向量做相似度比对,最后返回最接近的几条。
图 向量检索流程:从文本到相似结果
再看这两种检索的分工,差别就很直观:关键词检索沿着字面找,语义检索沿着意思找。
"相似"怎么量化?靠距离度量。Qdrant 支持几种常见的度量,各有各的适用场景。余弦相似度看的是方向,不看长度,适合文本语义;欧氏距离看的是空间里的直线距离,适合那些绝对值本身有意义的特征;点积则在一些直接优化内积的模型里用得多。下表把它们放在一起对比。
| 距离度量 | 衡量什么 | 对什么敏感 | 典型用途 |
|---|---|---|---|
| 余弦相似度 | 两个向量的方向夹角 | 只认方向,忽略长度 | 文本语义、段落匹配 |
| 欧氏距离 | 空间里的直线距离 | 绝对数值的差异 | 图像特征、物理量 |
| 点积 | 投影与方向综合 | 长度与方向都认 | 部分推荐模型的打分 |
还有一个绕不开的难题,叫维度灾难。向量的维度动辄几百上千,在这么高维的空间里,几乎任何两个点之间的距离都会趋向"差不多远",传统基于树或哈希的索引会迅速失效。这也是为什么向量数据库要用 HNSW 这类专门为高维设计的索引结构,而不是复用关系库的 B 树。可以把它理解成:高维空间里"近邻"这个概念本身变模糊了,需要专门的导航方式才找得回来。
到这里,可以给 Qdrant 一个更精确的定位了。它是一个向量相似度搜索引擎,而不是一个单纯的向量索引库。区别在于"生产就绪"这四个字:它有持久化、有接口、有对附加信息的过滤,能直接嵌进一个正在跑的业务系统里。你可以把它想象成一座专门的图书馆,书是向量化的,管理员不认书名,只认"内容近不近",还能在找相似的同时按标签、价格、时间这些字段再筛一道。
下面这段概念代码,展示的是从建库到查询的完整骨架,重点是看每一步在做什么,而不是背语法。
from qdrant_client import QdrantClient from qdrant_client.models import Distance, VectorParams, PointStruct # 建一个集合:向量 384 维,用余弦相似度 client = QdrantClient(host="localhost", port=6333) client.create_collection( collection_name="docs", vectors_config=VectorParams(size=384, distance=Distance.COSINE), ) # 假设 embed 是外部的嵌入模型,把文本变成 384 维向量 vec = embed("向量数据库是干嘛的") # 插一条记录:向量之外还挂了一个原文作为有效载荷 client.upsert( collection_name="docs", points=[PointStruct(id=1, vector=vec, payload={"text": "向量数据库是干嘛的"})], ) # 查询:把问题转成向量,找语义最近的几条 qvec = embed("什么是向量检索") hits = client.search(collection_name="docs", query_vector=qvec, limit=3)
代码里有两个细节值得注意。一是向量维度和距离度量在创建集合时就固定了,之后改起来麻烦,所以一开始要选对。二是每条记录除了向量还能挂一个有效载荷,也就是上面那个 text 字段,查询命中了能直接把它带回来,省得再去别的库查一次原文。
三、工程实践要点
第一个要拿捏的,是什么时候该用 Qdrant,什么时候不该用。它擅长的是"相似性",不擅长"精确性"。如果你的查询是"订单号等于多少""金额在某个区间内",关系型数据库更快、更简单,别硬上向量库。只有当需求里出现了"相近""相似""推荐""理解意图"这类词时,向量库才真正派上用场。
第二个是嵌入模型的选择往往比数据库本身更影响效果。向量是嵌入模型产出的,模型选错了,Qdrant 再快也救不回来。做中文文本检索就选对中文友好的模型,做多模态就用能同时编码图和文的模型。这件事很容易被忽略,因为大家总盯着数据库的性能看。
第三个是维度与距离度量要配套。嵌入模型输出多少维,建集合时就要写多少维,对不上会报错。距离度量也要跟着模型的训练方式走:模型是按余弦优化出来的,就用余弦相似度,别随手选欧氏距离。
第四个是上线前先做一轮小规模评估。别一上来就灌全量数据,先取一个代表性子集,看看召回和延迟是否符合预期,再决定参数和容量。向量检索的效果是"数据、模型、参数"三者共同作用的结果,光看数据库指标不够。
| 决策点 | 建议做法 | 代价提醒 |
|---|---|---|
| 是否用向量库 | 有"相似"诉求再用 | 精确查询交给关系库 |
| 嵌入模型 | 按语言和模态选 | 换模型通常要重建向量 |
| 距离度量 | 跟随模型训练方式 | 选错会明显拉低召回 |
⚠️ 常见坑:很多人把向量数据库当成"万能搜索",指望它同时解决精确匹配和模糊语义。结果两边都不讨好。正确姿势是让关系库管精确、向量库管语义,两者各司其职,必要时再拼起来。
💡 关键直觉:向量数据库本身不"理解"任何东西,它只是高效地比较数字。真正赋予语义的是嵌入模型。想调效果,先看模型,再看索引。
常见问题
Qdrant 能自己把文字变成向量吗? 不能。向量由嵌入模型生成,Qdrant 负责存和查。当然它的客户端可以帮你调用嵌入模型、把这步封装起来,但理解语义的始终是模型。
向量数据库和关系数据库能互相替代吗? 不能,也无需替代。关系库擅长精确匹配和事务,向量库擅长相似检索,两者常在同一套系统里各管一段。
向量维度越高越好吗? 不一定。维度高,表达力可能更强,但存储和计算开销也更大,还会加剧维度灾难。维度要跟着嵌入模型走,而不是盲目求大。
没有 GPU 能跑向量检索吗? 可以。生成向量可能用到 GPU,但检索向量这件事,Qdrant 用 CPU 就能做,这是它作为独立服务的一个优势。
它和普通的向量索引库差别在哪? 索引库通常只管内存里的近邻查询,Qdrant 多了持久化、接口、载荷过滤和分布式能力,能作为独立服务长期运行。
向量检索能完全离线跑吗? 可以。生成向量可能在线上模型服务里做,但检索这一层可以用 Qdrant 独立承载,部署在内部网络、不连外网也没问题。
入门先学哪个接口? 建议从 Python 客户端起步,概念最直观、示例最多。等熟悉了数据模型,再按需了解 gRPC 和 REST 的细节。
要点速记
- 语义相似:核心诉求是找"意思近",而非"字面同",这是它和关系库、全文检索的根本分界。
- 三个词一条线:嵌入把原始数据变成向量,向量是数字形态,相似度搜索在向量上找近邻。
- Qdrant 的定位:开源、生产就绪的向量相似度搜索引擎,不是单纯的索引库。
- 分工边界:Qdrant 只管存和查向量,语义理解由嵌入模型完成。
- 有效载荷:每条向量可挂结构化附加信息,查询时能直接带回,省二次查询。
- 距离度量:余弦、欧氏、点积各有适用场景,建集合时就要定好,且要跟着模型走。
- 选型原则:精确查交给关系库,相似查交给向量库,别混为一谈。
下一节我们换个角度,看 Qdrant 是怎么从"向量搜索没有好用的库"这个痛点里长出来的,它选了 Rust、HNSW、gRPC 这些技术,每一项都对应一个具体问题。