1.4 典型应用场景
1.4 典型应用场景
本节摘要:Qdrant 的核心能力——按语义找相似、按条件做过滤——在四类场景里最常落地:语义搜索、推荐引擎、检索增强生成(RAG)和多模态检索。它们共同点是把"理解相似性"从模型能力变成可查询的服务。本节逐一拆开这些场景,读完你能说清每一类里 Qdrant 承担的是哪一环、关键成功因素是什么,以及哪些需求虽然沾边、却不该硬套向量库。把四类场景看全,才能判断自己该从哪里入手,避免一上来就选错方向。
阅读收获
阅读完本节,你应当能够:
- 区分语义搜索和关键词搜索在处理"同义表达"上的差异
- 说出推荐引擎里向量检索解决的具体问题,以及它的局限
- 讲清检索增强生成中 Qdrant 作为外部知识库的工作流程
- 举例说明多模态检索中"以文搜图""以图搜图"是怎么实现的
- 判断一个业务需求属于哪类场景、该不该引入 Qdrant
一、问题与直觉
前面几节都在讲 Qdrant 是什么、凭什么快、好在哪。这一节把它放回真实业务,看它到底替哪些问题兜底。
你会发现,这四类场景看起来风马牛不相及——一个管搜索、一个管推荐、一个喂大模型、一个跨模态——但它们背后是同一个诉求:让机器理解"相似",并且把这种理解变成一个能实时查询的服务。关键词搜索理解不了"同义不同词",协同过滤推荐在冷启动时抓瞎,大模型会一本正经地编造没有的事,多模态则卡在"图和文怎么对上"。
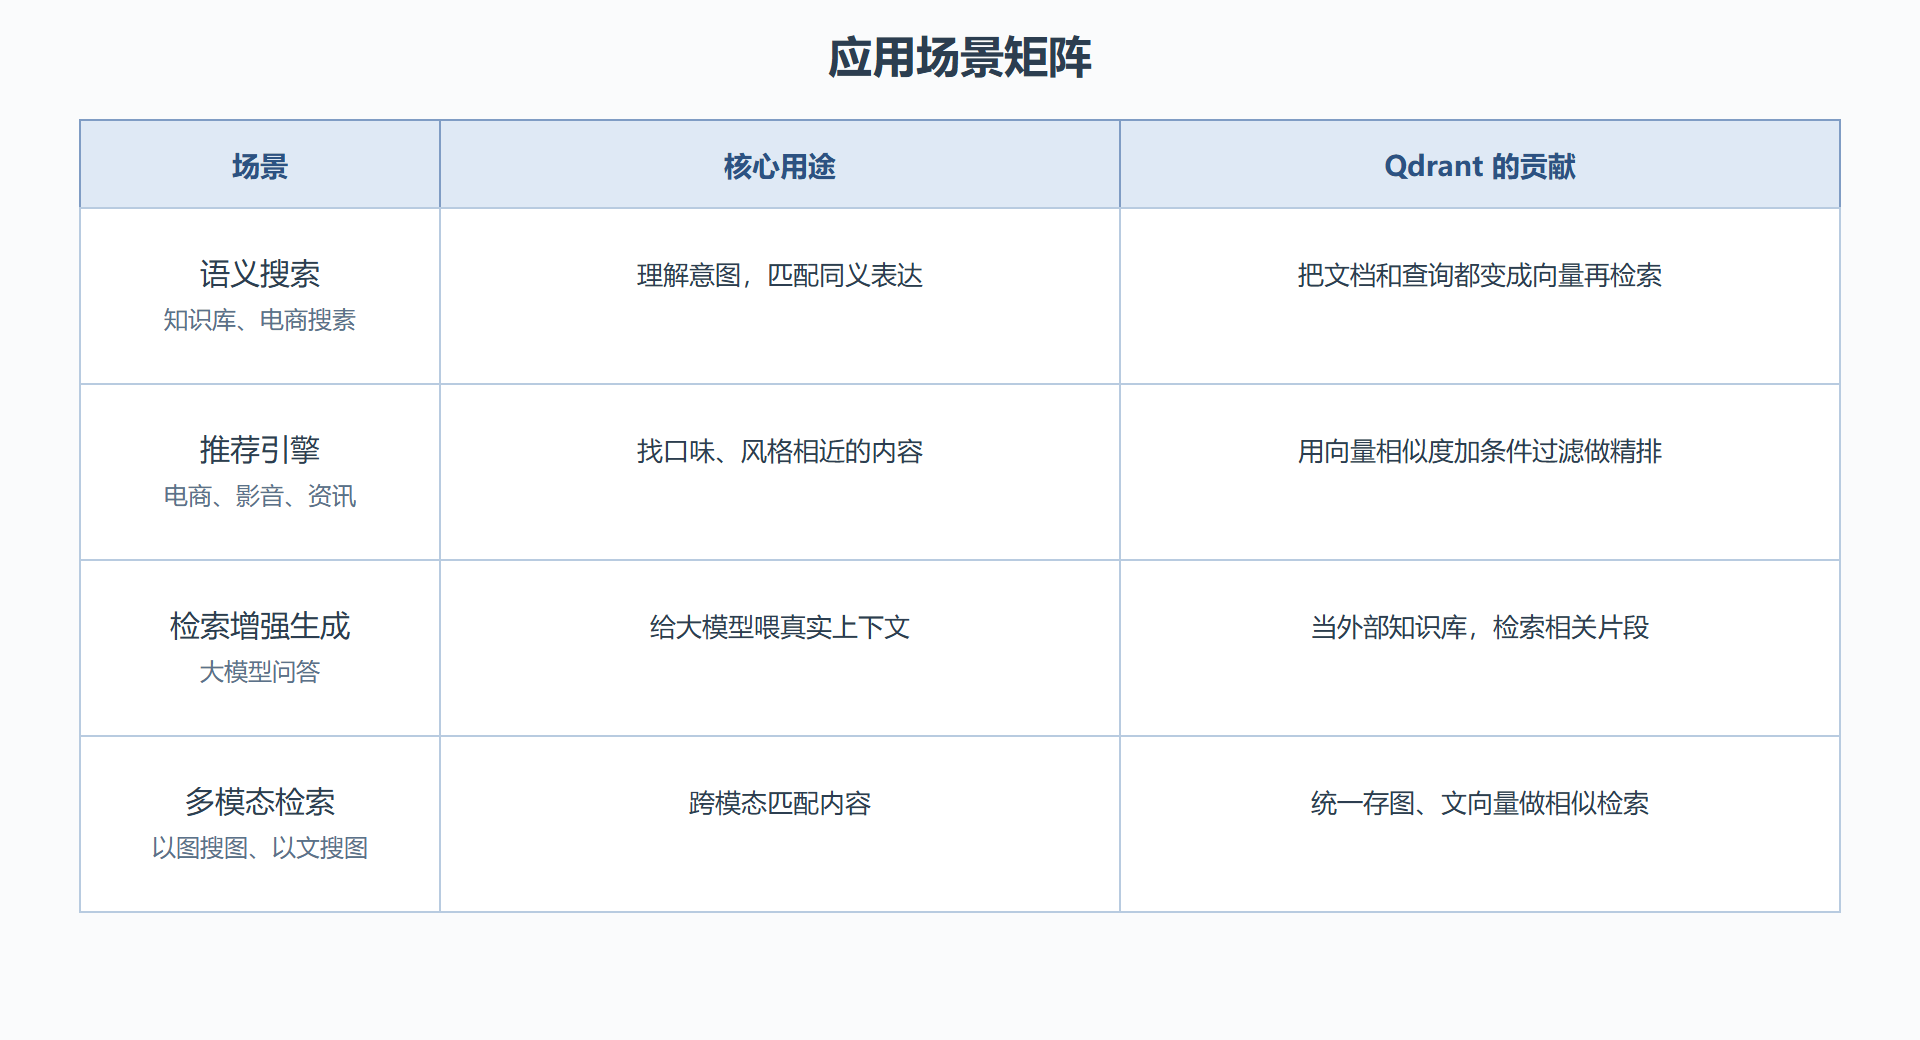
Qdrant 干的活,本质上是给这些场景补上"语义匹配"这一环。它不替你做推荐算法,不替你训练模型,但它把"找相似"这件事做成了基础设施,让你能在它之上快速搭出各种智能应用。下面这张矩阵,把四类场景、它们的核心用途和 Qdrant 的贡献摆在一起。
图 应用场景矩阵:场景与用途对照
二、核心原理
四类场景可以看成"相似性"在不同业务里的四种长相。它们共享同一条数据链路——把对象变成向量、存进 Qdrant、按相似度查出来——差别只在对象是什么、相似怎么定义。下面逐个拆开看。
第一个场景是语义搜索。传统关键词搜索只看词形,文档里没出现查询里的词,就检索不到,哪怕意思完全一样。语义搜索的思路是把文档和查询都交给嵌入模型,变成向量,再比较向量之间的相似度。于是"怎么延长手机电池寿命"和"省电技巧"这样的表达,就能对上。Qdrant 在这里做的是后半段——存文档向量、建索引、按查询向量找最近邻。它不负责生成向量,但它是让"语义"能被查出来的那台机器。
落地时最常见的问题是"查不到"——不是数据没有,而是向量没建好或模型不对。排查时先看文档有没有真的被切分、向量化、入库,再看查询向量和文档向量是不是同一个模型产出的。
第二个场景是推荐引擎。推荐里有一类经典做法叫基于内容的推荐,核心是"你喜欢的和哪些东西最像"。把用户历史行为和候选物品都向量化之后,"找像"就变成了"找近邻"。Qdrant 能快速给出与某个物品向量最接近的一批候选,再配合载荷过滤做精细筛选,比如"风格相似、评分四星以上、有库存"。要注意的是,向量检索只是推荐系统里的一环,协同过滤、排序模型这些仍然重要,Qdrant 不替代它们,只是把"相似召回"这一步做得又快又省。
拿短视频举例:平台每天新增海量内容,先把每条内容压成向量,用户刷到一条,系统就用这条的向量去 Qdrant 里找最像的一批,再交给排序模型决定先后。这个"召回"环节最看重吞吐,正是向量库的主场。
第三个场景是检索增强生成,简称 RAG。大模型的知识是训练时冻结的,会过时,也会一本正经地编造不存在的事实。RAG 的思路是:用户提问后,先从外部知识库里检索出最相关的几个片段,把这些片段连同问题一起塞给大模型,让它"照着材料回答"。Qdrant 在这个链路里就是那个外部知识库——它把文档切成片段、向量化、存起来,查询时快速检索出最相关的片段。这里的"切片段"很关键:文档不能整篇存,得切成几百字的小块,查询时命中块而不是整篇。块太大,检索到的上下文就稀释了;块太小,语义又不完整。这个粒度得按内容类型调。这个流程可以用下面这张图概括。
第四个场景是多模态检索。图像、音频这些非文本内容,同样能被专用模型编码成向量。于是"以图搜图"就是拿一张图的向量去找相似的图向量,"以文搜图"则是拿文字向量去和图向量比。Qdrant 对向量的来源不做区分,图向量、文向量、音频向量都只是向量,统一存、统一查。这给了跨模态应用一个共同的底座。
版权保护是个典型例子:上传一张图片,用同一个多模态模型把它和图库里的图都转成向量,就能快速找出最相似的几张,判断是否侵权或重复。这种"以图搜图"过去要做复杂的图像哈希,现在统一成向量检索一条路。
三、工程实践要点
四类场景看似通用,实际落地时有各自的坑。
语义搜索最容易踩的坑,是忽略了嵌入模型和语料的匹配。用英文模型查中文文档,或用通用模型查专业术语密集的语料,效果都会打折扣。数据库再好,也补不上模型选错的窟窿。
推荐引擎要注意的是,向量相似召回不等于推荐的全部。它擅长"内容像不像",但不擅长"你还会不会喜欢"这种包含行为反馈的判断。别指望一个向量库就能撑起完整推荐系统,它更适合做召回层的一环。
检索增强生成里,切片策略和检索质量直接决定答案好坏。片段切得太碎,上下文不完整;切得太长,检索相关性下降。这是 RAG 里最花心思的地方,Qdrant 只负责检索,切片得你自己设计。
多模态检索则要留意不同模态向量是否落在同一个语义空间。只有用联合训练的多模态模型,图和文向量才有可比性;各用各的单模态模型,向量维度、含义都对不上,跨模态检索就是空中楼阁。
落地顺序也有讲究。别一上来就铺满四个场景,挑一个最痛的、最能看到效果的先做通——通常是语义搜索或检索增强生成——跑顺了再把经验复制到别的场景。向量检索的很多坑是场景共通的,第一遍踩完,后面就顺了。等第一个场景稳定后,把它的嵌入管线、切片策略、查询模板沉淀成可复用的组件,第二个场景就能直接套用,省一大半功夫。这也是为什么很多团队先从知识库问答切入——它链路最清晰,容易出结果。
这四类场景还有一个共性:它们都在和"嵌入"打交道,而嵌入质量是上游决定的事。所以接入 Qdrant 之前,先花时间把嵌入这一环做对——选对模型、统一维度、设计好切片。地基是歪的,上面的检索再怎么快也白搭。这一点怎么强调都不为过,很多项目的翻车点都出在嵌入这一环。
| 场景 | 关键成功因素 | 常见误区 |
|---|---|---|
| 语义搜索 | 嵌入模型匹配语料 | 只优化数据库,忽略模型 |
| 推荐引擎 | 相似召回加精排 | 把召回当完整推荐 |
| 检索增强生成 | 切片与检索质量 | 忽视切片,只堆文档 |
| 多模态检索 | 统一语义空间 | 各模态各用各的模型 |
⚠️ 常见坑:看到"向量数据库能做语义搜索",就把所有搜索需求都塞进去,连精确的订单号查询也走向量。结果精确查询变慢还变贵。精确查交给关系库,语义查才给向量库。
💡 关键直觉:Qdrant 在这四类场景里都是"管道",不是"大脑"。它把"找相似"这件事标准化、服务化,但语义从哪来、切片怎么切、模型怎么选,这些决定效果的关键,仍然要靠应用侧的设计。
常见问题
语义搜索能完全替代关键词搜索吗? 不能。语义搜索擅长理解意图,但对精确的实体、编号、专有名词,关键词匹配往往更直接可靠。成熟的系统常把两者结合,语义兜底、关键词保精确。
推荐系统一定要用向量数据库吗? 不一定。小规模、冷启动不严重的场景,协同过滤就够。向量库的价值在内容规模和实时性上来之后才更明显。
检索增强生成里,Qdrant 和普通全文检索有什么区别? 全文检索靠词命中,语义相近但措辞不同的内容会漏;Qdrant 靠向量相似,能把"意思对得上"的片段捞回来,更贴合大模型需要的上下文。
多模态检索需要几张图做种子? 不一定需要。以文搜图时,一张图都不需要,只要一段描述文字转成向量即可;以图搜图则只需一张查询图。
这四类场景能叠加吗? 能,而且常常叠加。比如一个电商应用,可能同时用语义搜索找商品、用推荐引擎做猜你喜欢、再用检索增强生成回答客服咨询。它们共用同一套向量基础设施。
从哪个场景入手最划算? 如果团队已经有文档知识库,从检索增强生成切入见效最快;如果有商品或内容库,语义搜索是自然的第一步。
本节速览
- 四类场景同一内核:语义搜索、推荐、检索增强生成、多模态检索,都靠"相似性"串起来。
- 语义搜索:解决同义不同词的匹配,Qdrant 管存和查,模型管语义。
- 推荐引擎:向量检索做"相似召回"这一环,不替代排序模型。
- 检索增强生成:Qdrant 当外部知识库,检索相关片段喂给大模型,抑制编造。
- 多模态检索:图、文、音频统一成向量,跨模态匹配有了共同底座。
- 效果看上游:模型选型、切片策略,比数据库本身更影响最终结果。
- 边界要清醒:精确查询走关系库,别什么都往向量库里塞。
到这里,第 1 章收尾了。我们讲清了 Qdrant 是什么、靠什么、好在哪、用在哪。从第 2 章开始,我们钻进它的内部,先看整体架构和数据模型,再讲向量索引与相似度搜索到底是怎么实现的。