第3章 Qdrant 客户端与开发实践
第3章 · Qdrant 客户端与开发实践
章节摘要:前两章把 Qdrant 是什么、内部怎么建索引讲清楚了,但那些都停在服务端一侧。真正要命的问题是:服务端跑起来了,你的应用代码怎么"够到"它?数据怎么喂进去、怎么查出来?这一章就回答这条落地链路。我们从客户端连接讲起,再到数据的增删改查、带过滤的高级查询、与嵌入模型的配合,最后落到本地、容器、云三种部署怎么选。读完这一章,你应当能从零搭起一条"原始文本进、相似结果出"的可运行链路,并知道每一步该用什么工具、踩什么坑。
先说结论
阅读完本章,你应当能够:
- 说出 Qdrant 客户端支持哪几种连接形态(内存、本地、远程、云),并判断一个项目该用哪一种。
- 独立完成一个集合的创建,以及点数据的插入、精确读取、更新和删除,讲清
upsert的幂等含义。 - 写出带过滤条件的向量查询,解释"向量相似度"和"标量过滤"是怎么在查询里合在一起的。
- 把嵌入模型接进数据管线,区分离线批量生成和在线实时生成各自适合什么场景。
- 在本地单机、容器、托管云三种部署之间做出有依据的取舍,说出各自的高可用和成本代价。
核心概念速览
客户端不是 Qdrant 的附属品,它是开发者与向量库之间的"接口层"。你可以把它想成一间仓库的柜台:仓库里货架再多、分拣再快,柜台上递单、扫码、取货的手续办不利索,货就出不来。客户端干的就是这层手续——把"我要建个集合""我要插一批点""我要查最像的 10 条"这些意图,翻译成服务端听得懂的协议请求,再把返回的字节翻译回你代码里的对象。
金句:客户端要解决的不是"有没有 API",而是"让写业务的人少跟协议和序列化打交道,把精力放回业务本身"。
换句话说,这一章的主线,是把"服务端能力"翻译成"开发者手里能直接调用的东西"。你不需要知道每个字段在二进制里占几个字节,但需要知道什么时候该走 gRPC、什么时候该用 upsert、什么时候该加过滤。
图:本章开发全流程
下面这张图把本章五节串成一条完整的开发流水线,从左边连上服务,到右边把服务交出去,中间每走一步都在往前推进数据的生命周期。
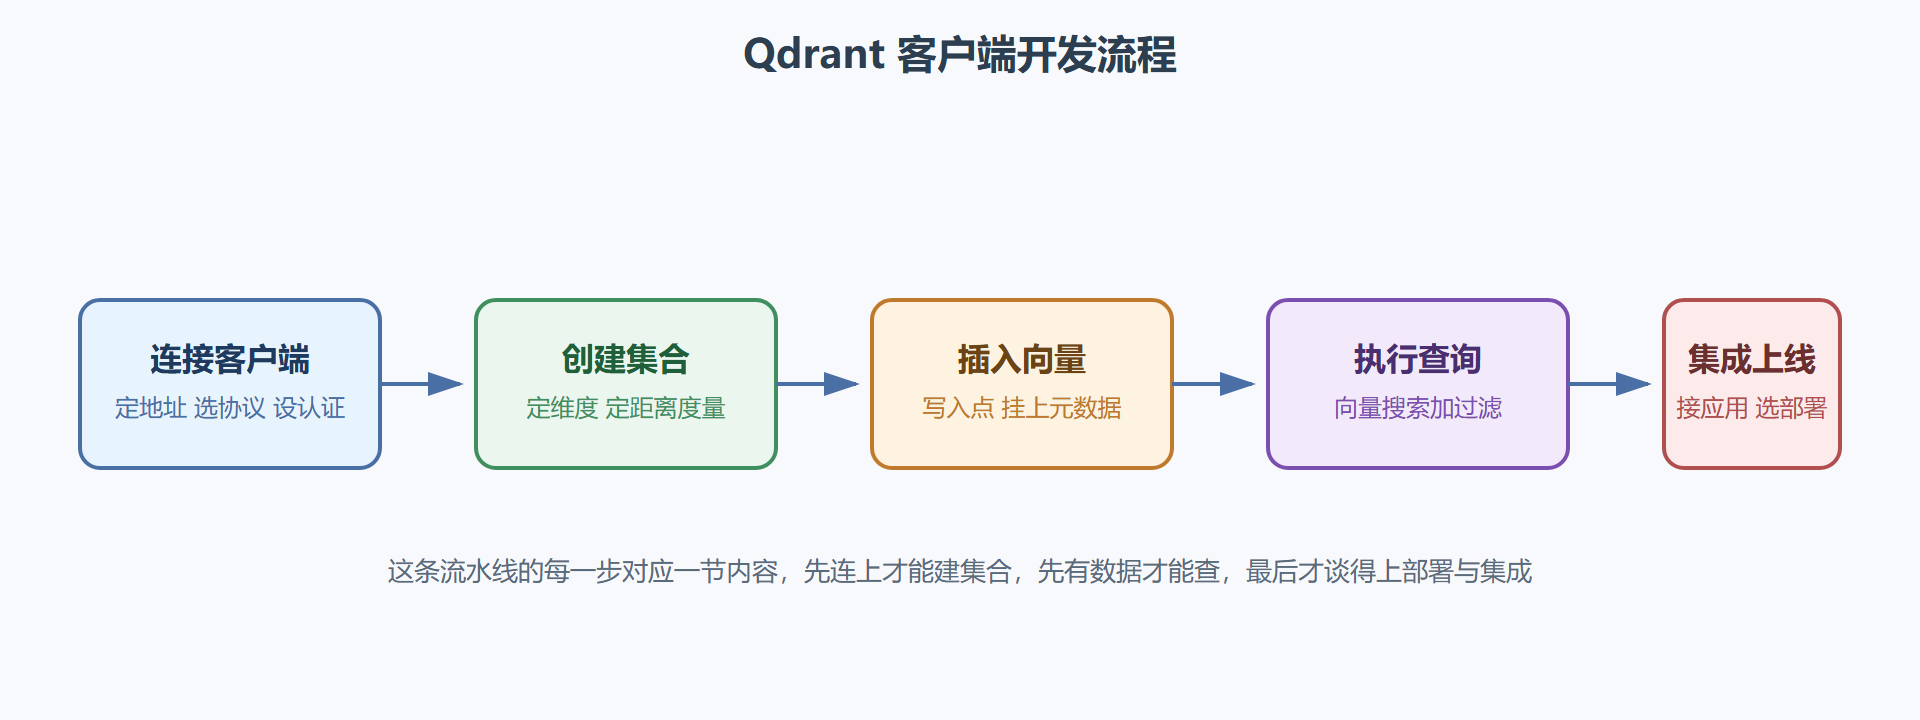
五节之间的分工,用一张表看最清楚:
| 节 | 核心问题 | 读完你手里多了一件什么事 |
|---|---|---|
| 3.1 客户端安装与连接 | 代码怎么找到并连上服务端 | 一个能用的客户端对象,以及选协议、设认证的判断力 |
| 3.2 数据操作:CRUD | 数据怎么进、怎么改、怎么删 | 集合与点的完整生命周期操作 |
| 3.3 高级查询接口详解 | 怎么把语义搜索和字段过滤合在一起 | 能写出带业务约束的精确检索 |
| 3.4 嵌入生成与外部集成 | 原始文本怎么变成向量、怎么接进管线 | 一条嵌入生成到入库的链路 |
| 3.5 部署模式与选择 | 本地、容器、云到底选哪个 | 一张按成本与可用性权衡的决策依据 |
子章节导航
3.1 客户端安装与连接
这一节只讲一件事:应用代码和服务端之间的那根"线"怎么接上。我们不纠结安装命令,而是讲清连接背后的协议选择、地址与认证参数、以及内存、本地、远程三种连接形态各自适合什么场合。
3.2 数据操作:CRUD
向量数据也有生老病死。这一节拆开增、读、改、删四件事,重点讲 upsert 的"有则更新、无则插入"为什么能省掉大量重复判断,以及读操作里"精确取点"和"相似搜索"是两条不同的路。
3.3 高级查询接口详解
光会搜"最像的 K 条"远远不够。这一节讲过滤条件怎么和向量搜索叠加,recommend、discover 这类接口解决什么问题,以及分页、分组、阈值这些参数在工程里怎么用。
3.4 嵌入生成与外部集成
向量不会从天上掉下来。这一节讲文本、图片是怎么变成向量的,开源模型、商业接口、自训练模型三者怎么选,以及嵌入生成如何和 Qdrant 入库流程拼成一条自动化管线。
3.5 部署模式与选择
最后一步是把服务交出去。这一节对比本地单机、容器、托管云三种部署的可用性、成本和运维负担,给出一个从"数据量、并发、团队运维能力"三个维度出发的选型思路。
子章节之间的逻辑关系
这五节不是并列的知识点,而是一条按"数据从哪来、到哪去"展开的流水线:先连上服务端,再往里写数据,再把数据查出来查准,再解决"向量从哪来"的源头问题,最后才轮到"这套东西放哪跑"。前一步是后一步的前提,缺了前面,后面就是空谈。
3.1 连接客户端 ──► 3.2 数据 CRUD ──► 3.3 高级查询 ──► 3.4 嵌入生成 ──► 3.5 部署选择 │ │ │ │ │ 先能连上 再能写进去 再能查得准 再解决向量来源 最后才谈怎么跑
⚠️ 一个常见的跳步错误:还没搞清 3.2 的
upsert和 3.3 的过滤机制,就直接跳到 3.4 上框架集成。结果数据模型设计错了,后面改集合、重建索引的成本很高。按顺序来,反而快。
💡 把这一章当成一条"数据流水线"而不是五篇独立文章。你心里始终有一个问题在牵引:这一坨原始数据,最终怎么变成用户搜到的那条结果。
前置知识与后续延伸
- 前置:建议先读过第 1 章(Qdrant 是什么、核心概念)和第 2 章(架构与索引原理)。尤其"集合、点、向量、有效载荷、距离度量"这几个词,本章会反复用到,先有印象读起来才不卡。
- 为第 4 章铺垫:本章末尾的部署选择,正好接上第 4 章的"高可用与可扩展性"和"监控与故障排查"——你在这里选了集群部署,下一章就讲怎么把集群调优、盯住它别出事。
- 为第 5 章铺垫:3.4 里碰到的 LangChain、LlamaIndex 这类外部集成,在第 5 章"与 AI/ML 生态的融合"里会展开成完整的生态视角。