4.1 性能调优策略
4.1 性能调优策略
本节摘要:Qdrant 的性能调优本质上是在召回率、查询延迟、吞吐量、资源消耗四个量之间做取舍,而不是把某个参数拉满。这四个量此消彼长,任何一次优化都是在它们之间重新分配筹码。本节从 HNSW 索引的 M、ef_construct、ef 三个旋钮讲起,讲清每个参数影响什么、代价是什么,再落到批量写入、Payload 索引、段合并、量化与硬件选型,逐一给出收益边界,最终帮你建立「先测量、再调优、再验证」的工程习惯,让单机性能的提升有数据可依。
核心问题
阅读完本节,你应当能够:
- 解释召回率与查询延迟为什么此消彼长
- 依据场景设置 HNSW 的 M、ef_construct、ef 三个参数
- 用批量写入和批量查询降低单条请求的固定开销
- 为高频过滤字段建立 Payload 索引并判断是否必要
- 根据存储和内存压力在 SQ、PQ 之间做出选择
- 从 CPU、内存、磁盘、网络四类资源定位瓶颈
一、问题与直觉:为什么「能跑」不等于「跑得好」
我见过的最典型的一次翻车,是这样发生的:团队用默认参数起了个 Qdrant,塞进一百万个向量,压测时 P99 延迟稳定在十几毫秒,大家都觉得这库挺能打。三个月后数据涨到八千万,同样的查询开始出现五六百毫秒的长尾,用户投诉接踵而至。查了一圈,代码没改,机器没换,只有数据量变了。
问题出在哪?出在「默认参数」是为通用场景准备的,而通用场景恰好最不关心你那八千万条数据的分布。向量数据库的检索是近似搜索,它用一个叫 HNSW 的图结构在「快」和「准」之间走钢丝。数据量小时,这根钢丝很宽,怎么走都稳;数据量一大,钢丝变窄,默认参数就开始往下掉——要么召回不够,要么延迟爆表。
所以调优的第一课是放下「找一组万能参数」的念头。Qdrant 的每一个性能旋钮,本质都在四个量之间重新分配筹码:召回率(找到的最近邻有多准)、查询延迟(一次搜索多久返回)、吞吐量(一秒能扛多少请求)、资源消耗(占多少内存、磁盘和 CPU)。四个量不能同时变好,你只能按业务排序,把最重要的那个保住,其余的适当让步。
这就像调校一辆车:悬挂调硬了过弯稳,但过减速带颠;省油模式下加速肉,但续航长。没有一个设定是「最好的」,只有「最适合这条路的」。性能调优同理——先问清楚这条路是高速公路还是山道,再决定把哪个参数往哪个方向拧。
二、核心原理:延迟、吞吐、召回的三难
在动手之前,得先看清三个量之间的机械关系,否则调参就是碰运气。
召回与延迟是最直接的一对矛盾。Qdrant 默认用 HNSW 做近似最近邻搜索,查询时从一个入口节点出发,沿着图上的边一层层跳到离目标更近的区域。跳的步数越多、考察的候选越多,找到的结果越接近精确解,召回率越高,但耗时也线性往上走。想快,就少考察几个候选;想准,就多考察几个。没有中间地带可以两全。
吞吐与延迟在单机上是另一对。吞吐高不等于延迟低:如果一台机器用满所有 CPU 核并行处理,单条请求的延迟可能因为排队和缓存争抢而略微上升。反过来,把并发压得很低,单条延迟好看了,吞吐又上不去。真正决定吞吐上限的,是「一台机器有多少可以并行计算的核心」和「每个请求占多少 CPU」。
资源消耗是前面两者的隐形地板。HNSW 图要常驻内存,向量本身要落盘,索引越大内存吃得越狠。内存不够时,操作系统开始把页面换进换出,延迟会突然恶化一个数量级——这不是参数问题,是物理瓶颈。所以调优从来不是只在索引参数上做文章,还得盯着内存和磁盘够不够用。
这张图把三难画成一条因果链:查询时考察的候选越多,召回越准,但延迟越高,吞吐随之下降;而索引本身的内存占用若超出物理内存,又会从另一个方向把吞吐拖垮。理解了这条链,你就知道调参其实是在这条链上「选一个业务能接受的工作点」,而不是追求某个单项指标的极值。
三、索引参数:HNSW 的三个旋钮
HNSW 有三个参数值得重点调,它们在创建集合时确定两个、查询时确定一个。
**M(max_connections)**决定图中每个节点最多连多少邻居。M 越大,图越「密」,从一个节点到另一个节点的跳数越少,搜索路径越短,召回越高;代价是索引体积和内存占用随之上涨,构建索引也更慢。默认值 16 是个折中,内存充裕、追求高召回时可以拉到 32 甚至 64;内存紧张、数据量巨大时反而要往小压。
**ef_construct(构建时的搜索范围)**决定建索引时为一个新节点考察多少个候选邻居。它越大,图的质量越好,查询阶段的召回越有保障,但建索引的 CPU 和时间开销也越大。它必须大于 M,常见取 100 到 400。写入频繁的场景里,这个值开太大,建索引会变成写路径上的瓶颈。
**ef(查询时的搜索范围)**是查询阶段唯一能改的参数,控制一次搜索考察的候选数量。它直接决定「召回换延迟」的比例:ef 从几十调到几百,召回一路往上,延迟也一路往上。它不用改索引就能生效,所以是我们最常用来做「快/准」权衡的开关。起步值通常取 M 的两到四倍,再按压测结果迭代。
| 参数 | 作用阶段 | 调大后的收益 | 调大后的代价 | 常见起步值 |
|---|---|---|---|---|
| M | 建索引 | 图更密、召回更高 | 内存和体积上涨、构建变慢 | 16 |
| ef_construct | 建索引 | 图质量更好 | 建索引 CPU 和时间开销变大 | 100 |
| ef | 查询 | 召回更高 | 延迟更高、吞吐下降 | M 的两到四倍 |
⚠️ 常见坑:只看召回不看内存。把 M 和 ef_construct 双双拉满,召回确实漂亮,但索引体积可能膨胀到物理内存装不下,上线后反而因为换页让延迟崩掉。调这两个值之前,先确认机器内存能容纳「索引体积 + 热点向量 + 系统开销」三部分的总和。
💡 关键直觉:ef 是唯一「零成本改、随时可回滚」的旋钮。建索引阶段的两个参数动了要重建索引,代价高;ef 每次查询都能临时指定,压测时先拿它扫出一张「召回—延迟」曲线,再决定要不要动 M 和 ef_construct。
除了 HNSW,Qdrant 还允许在小数据量集合上退化为全量扫描:向量只有几千到几万条时,暴力算一遍距离往往比维护一张图更快、召回还是百分百。数据量一上去,全量扫描的线性复杂度立刻顶不住,这时才轮到 HNSW 上场。选型的分水岭不在「谁先进」,在「数据量有没有大到值得付索引的内存成本」。
四、批量与写入:别一条一条来
很多性能问题不来自查询,来自写入方式。逐条 upsert 是新手最容易踩的坑:每写一个点,客户端和服务端都要走一次网络往返、一次序列化、一次落盘和一次索引更新,固定开销被重复了几百万次。同样的数据,改成批量写入,把几千个点打成一个请求,总耗时能降一个数量级。
批量查询同理。如果业务一次要搜几百个不同 query,逐个发请求,网络往返和连接开销是几百份;打包成批量请求一次发出去,服务端可以复用连接、并行执行,客户端也只等一次。批量不是银弹,但对「写多查多、单条很小」的场景,收益立竿见影。
写入还有一层更隐蔽的成本藏在 Segment 里。Qdrant 把集合拆成多个段,新写入会不断产生小段,后台优化器再异步把小段合并成大段。小段太多,查询要扫更多索引结构,延迟和 I/O 都吃亏;合并太激进,又会在合并时抢 CPU 和磁盘。写入密集和读取密集的取舍正好相反:前者倾向容忍更多小段、少合并,后者倾向积极合并、让查询更顺。
Payload 索引是另一个「用空间换时间」的典型。过滤查询是 Qdrant 的强项,但没有索引时,它得先捞出候选再逐条比过滤条件。给高频过滤字段(类别、价格、状态)建上索引,过滤就能在向量搜索之前把范围大幅收窄,查询快一截;代价是每个索引都占存储、都拖慢写入。所以我们只给「确实经常被过滤」的字段建索引,建一个就多问一句「这个字段值不值得」。
# 批量写入示例:把散点聚成一批再 upsert client.upsert( collection_name="goods", points=[ {"id": i, "vector": vec, "payload": {"category": "electronics"}} for i, vec in enumerate(batch_vectors) ], )
五、存储与内存:量化的取舍
向量是浮点数组,一个 1024 维的 float32 向量就要 4KB。一亿条就是 400GB,还没算 HNSW 图的开销。这个量级下,「存不存得下」本身就是个问题,于是有了量化。
**标量量化(SQ)**把每个维度的浮点数压成 int8,存储直接砍到四分之一,查询时用整数运算也更快,精度损失通常可以接受,是最常用的起点。**乘积量化(PQ)**把高维向量切成若干子段分别量化,再用查表逼近距离,压缩比高得多,适合超大数据集,但召回损失更大、实现也更复杂。**二值量化(BQ)**干脆把每个维度压成 0 或 1,用汉明距离算相似度,最快最省,但精度损失最狠,只适合对精度要求不高的场景。
| 量化方式 | 压缩思路 | 空间收益 | 精度损失 | 适用场景 |
|---|---|---|---|---|
| 标量量化 SQ | 浮点压成 int8 | 约四分之一 | 小 | 多数场景的首选起点 |
| 乘积量化 PQ | 分段量化加查表 | 高 | 中到大 | 超大向量集、内存吃紧 |
| 二值量化 BQ | 每维压成一位 | 最高 | 大 | 精度不敏感、追求极致速度 |
💡 关键直觉:量化的顺序是「先用 SQ 试,不够再上 PQ,BQ 最后考虑」。因为精度损失是不可逆的决策成本——一旦为了省内存牺牲了召回,用户搜出来的东西变差,这个代价比多买几块盘更难弥补。先确认量化后召回掉多少,再决定值不值。
量化之外,内存管理本身也值得盯。Qdrant 用内存映射访问磁盘上的数据,操作系统会把热点文件页缓存在内存里。物理内存充足时,页面都在缓存里,读盘几乎为零;内存一紧张,页面被换出,查询突然要等磁盘,延迟就崩。所以「内存配够」不是一句空话——它直接决定你的索引是常驻内存还是被操作系统来回搬运。
六、资源与硬件:瓶颈到底在哪
调了半天参数,如果瓶颈根本不在 Qdrant,而在机器本身,那所有索引参数都白调。所以动手前先分清楚:是 CPU 打满了,还是内存换页了,还是磁盘在拖,还是网络在限速。
CPU 密集来自索引构建和查询计算,核越多、主频越高,吞吐上限越高。内存前面说过,要装得下索引和工作集。磁盘这块,机械硬盘的随机读写根本喂不饱向量库,NVMe SSD 是底线。网络在分布式部署里决定节点间同步和结果聚合的快慢,低延迟高带宽的内网是基本盘。
这几类资源对应的系统级参数也有一组老生常谈但确实有效的调法:调高文件句柄上限,避免 Qdrant 因打开太多段和索引文件而报错;把 swap 倾向调低,减少内存页被换到磁盘的概率;必要时开大页内存,降低内存访问的 TLB 未命中。这些动作单看都很小,叠加起来就是把「偶发抖动」从系统里挤出去。
图 4.1 调优维度与权衡
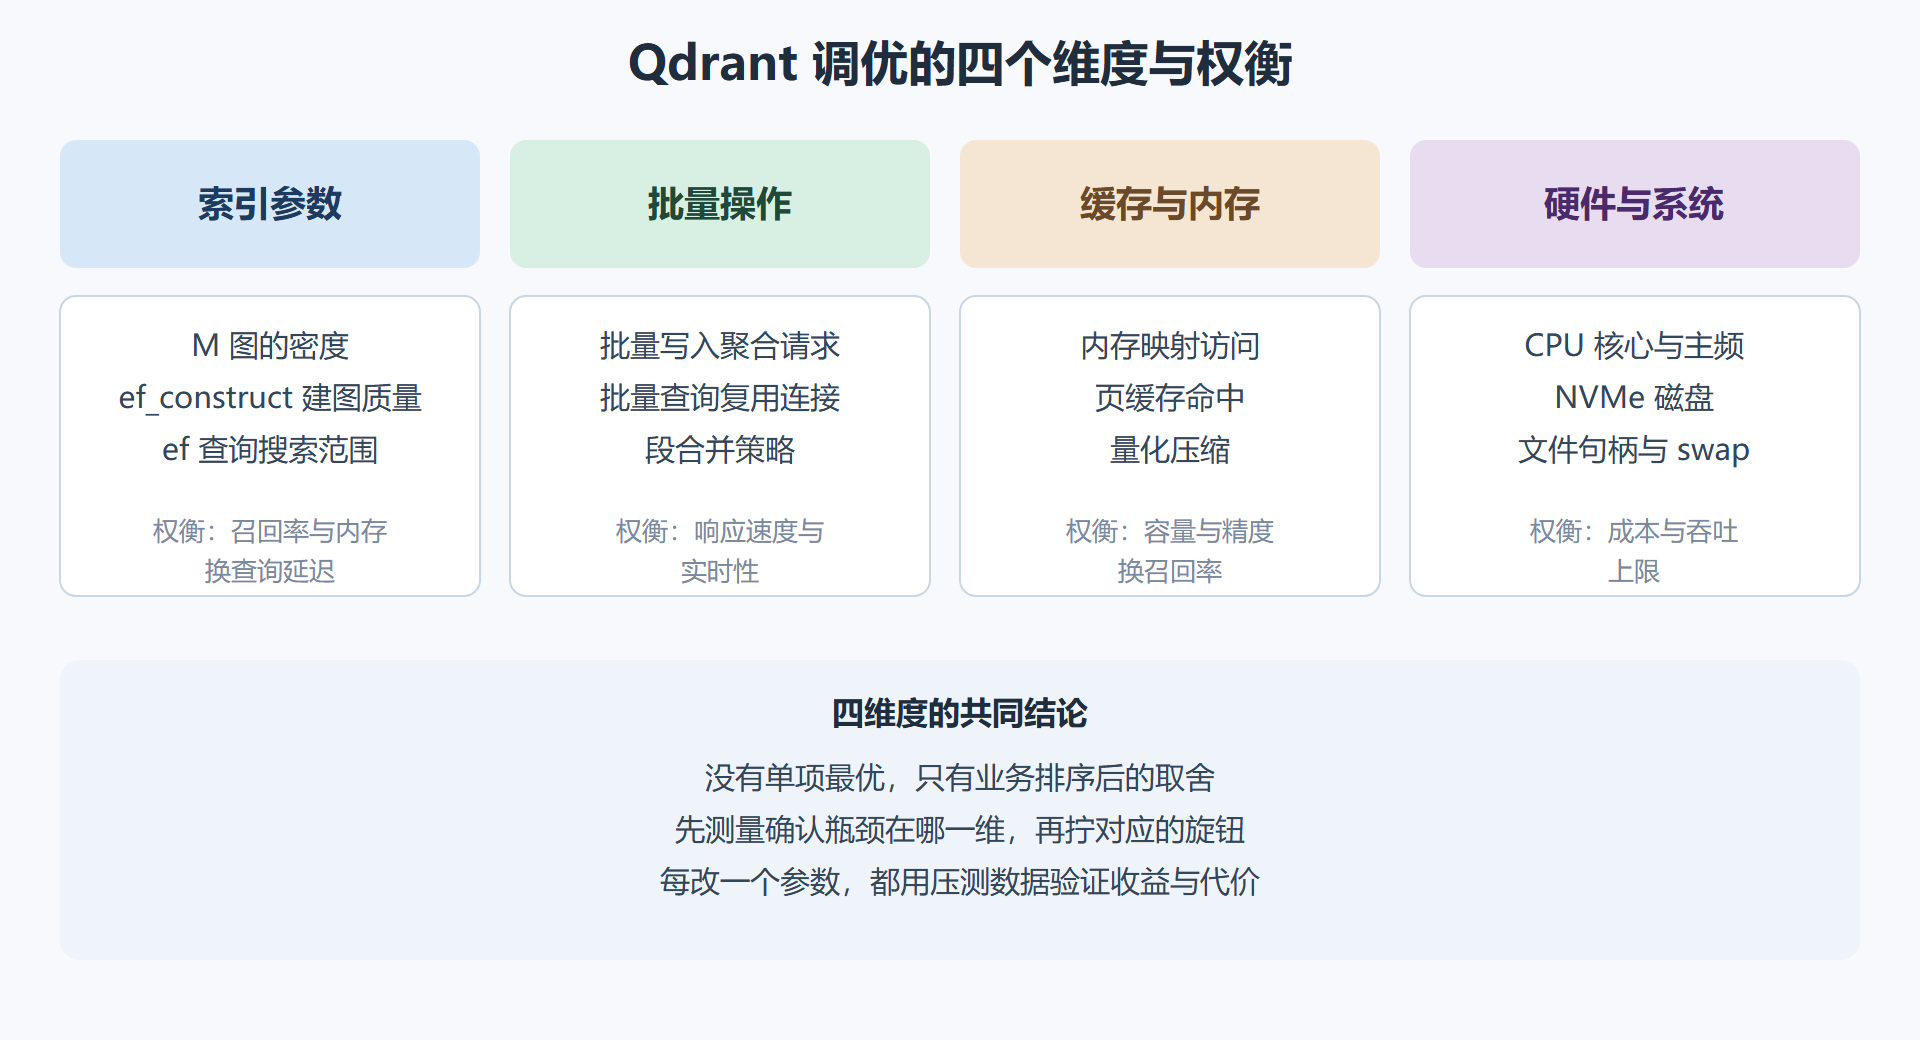
这张图把本节散落的调优手段归成四列:索引参数管「图怎么建、怎么搜」,批量操作管「请求怎么聚合」,缓存与内存管「数据怎么放、怎么省」,硬件与系统管「底子够不够」。四列的底部各标了一句权衡,提醒你每一维都不是免费午餐。动手调优时先在这张图上定位问题属于哪一维,再进那一维找具体参数,比上来就乱拧高效得多。
要点速记
- 调优本质:在召回率、延迟、吞吐、资源消耗四个量之间做业务排序后的取舍
- HNSW 三旋钮:M 管图密度,ef_construct 管建图质量,ef 管查询搜索范围
- ef 最灵活:零成本改、随时回滚,是压测「召回—延迟」曲线的首选开关
- 批量优先:逐条写入和查询的固定开销会被重复几百万次,批量能省一个数量级
- 段合并有取舍:写入密集容忍小段、读取密集积极合并
- Payload 索引按需建:只给高频过滤字段建,避免拖慢写入
- 量化从 SQ 起步:先用 SQ 验证精度损失,不够再上 PQ,BQ 最后考虑
- 先定位瓶颈再动手:CPU、内存、磁盘、网络四类资源,哪一类到顶就治哪一类
下一节我们看分片与副本——单机参数调到极限之后,真正把系统推向「扛得住」的,是在多台机器之间摊数据、补冗余、做故障转移。