1.3 适用场景与应用领域
1.3 适用场景与应用领域
在体系中的位置:前面两节解决了"是什么"和"有什么"。这一节落地到"用在哪、不用在哪"。它是第一章的收口,也是你合上第一章前必须做的一次自我审查。
我见过太多项目,多智能体上线后才发现:单智能体加几个工具就能搞定,多智能体纯属给自己加戏。所以这一节我先讲不适用,再讲适用。知道边界,比知道能力更重要。
先划禁区:什么情况别用
三类情况,我建议直接放弃多智能体。
单次问答型。 用户问一句、答一句,没有中间角色分工。比如"这句话翻译成英文"。这用一个模型调用加翻译工具足矣,上 AgentScope 是杀鸡用牛刀,还多一层消息序列化延迟。
强一致事务型。 比如银行转账,要求"要么全成、要么全不成",且每一步都锁数据。多智能体天然异步、各持状态,强一致反而是它的弱项。这类该用数据库事务,不是多智能体。
延迟极度敏感型。 比如高频交易的下单路径,多一层消息路由就可能多几十毫秒。AgentScope 不为此类场景设计。
# 错误示范——为了"多智能体"而多智能体 from agentscope.agents import DialogAgent from agentscope.msghub import MsgHub # 两个智能体干一件事:翻译一句话 a = DialogAgent(name="拆词", sys_prompt="把句子拆成词。", model=model) b = DialogAgent(name="翻译", sys_prompt="把词翻译。", model=model) # 且 b 必须等 a,根本没有并行收益,还多一次消息往返
解读:上面这种拆法,b 完全依赖 a 的结果且无可并行,等价于单智能体顺序执行,却凭空多了消息开销。1.1 说的临界点没到,硬上就是负担。
适用区:角色纪律需要被隔离时
反过来,下面几类场景,AgentScope 的价值能直接兑现。
研究/分析流水线。 调研、批判、综合由不同角色做,彼此要看到对方结论但保持各自标准。典型如"文献综述生成":检索员广撒网、评审员挑毛病、写作者整合。三者知识结构与判断标准不同,隔离后质量明显提升。
带规则的协作游戏/模拟。 多智能体在共享环境里按规则互动,比如供需市场模拟、辩论赛。环境承载规则,智能体承载策略,这正是 AgentScope 环境中介的本职。
长流程业务编排。 客服、报销、招聘这类"多步、可失败、需人工兜底"的流程。每一步失败都要被表达成消息、能被相邻环节协商,而不是整条链崩溃。
人机协同审核。 智能体产出初稿,人类在 MsgHub 里作为特殊"智能体"介入修改,系统再继续。AgentScope 2.0 对实时介入的支持让这类场景很顺。
把"研究/分析流水线"这条适用区跑成代码,你能直接看到为什么"角色纪律隔离"在这里产生收益——检索、评审、写作各是一个智能体,通过 MsgHub 串成链。
# 研究流水线:检索员 → 评审员 → 写作者,靠消息解耦 from agentscope.agents import ReActAgent, DialogAgent from agentscope.msghub import MsgHub from agentscope.models import OpenAIChatModel from agentscope.message import Msg model = OpenAIChatModel(model_name="gpt-4o-mini", api_key="环境变量占位") searcher = ReActAgent(name="检索员", sys_prompt="只做广泛检索,列出来源清单。", model=model) reviewer = DialogAgent(name="评审员", sys_prompt="挑出检索结果里矛盾或不可靠的点。", model=model) writer = DialogAgent(name="写作者", sys_prompt="综合检索与评审,输出综述。", model=model) async def pipeline(topic): async with MsgHub([searcher, reviewer, writer]) as hub: await hub.broadcast(Msg("user", f"研究主题:{topic}", "user")) await searcher() # 产出检索清单并广播 await reviewer() # 看到检索清单后给出质疑,广播 await writer() # 综合前两者输出综述 # asyncio.run(pipeline("多智能体框架的容错模式"))
运行输出(典型):检索员先广播一份来源清单;评审员针对清单指出"来源 X 与来源 Y 结论冲突";写作者拿到两份消息后产出综述,并在文内标注"该结论存在争议"。三个角色各自维持纪律,没有谁被谁的上下文稀释——这正是 1.1 临界点的正向兑现。
案例:招聘初筛系统的边界判断
背景:HR 想自动化"筛简历 → 约面试 → 发拒信"。起初团队想用一个超级智能体全包。
操作(单智能体尝试):一个 ReActAgent 接"读简历、写评价、发邮件"三个工具。跑了一周,问题来了——写评价需要严格客观,发邮件需要礼貌且合规,两者混在同一上下文,模型偶尔把"拒信语气"带进"评价草稿",内部互相污染。
结果(改用多智能体):拆成筛选员(只输出结构化评分)、沟通员(只负责邮件措辞,订阅筛选员的评分消息)、以及作为人类 HR 的介入节点。筛选员严格客观,沟通员严格礼貌,两者通过消息解耦。
解读:这里临界点到来的信号是"角色纪律冲突"——客观和礼貌不能共存于同一注意力里。这正是 1.1 讲的那个临界点,也是 AgentScope 的甜区。
变式:如果简历量很小(每天几份),人工更快更准,上多智能体纯粹增加维护成本。所以"适用"还绑定规模——量级越小,单智能体越划算;量级越大、角色越多,多智能体的隔离收益越压倒开销。
领域速览:哪些行业已经在用
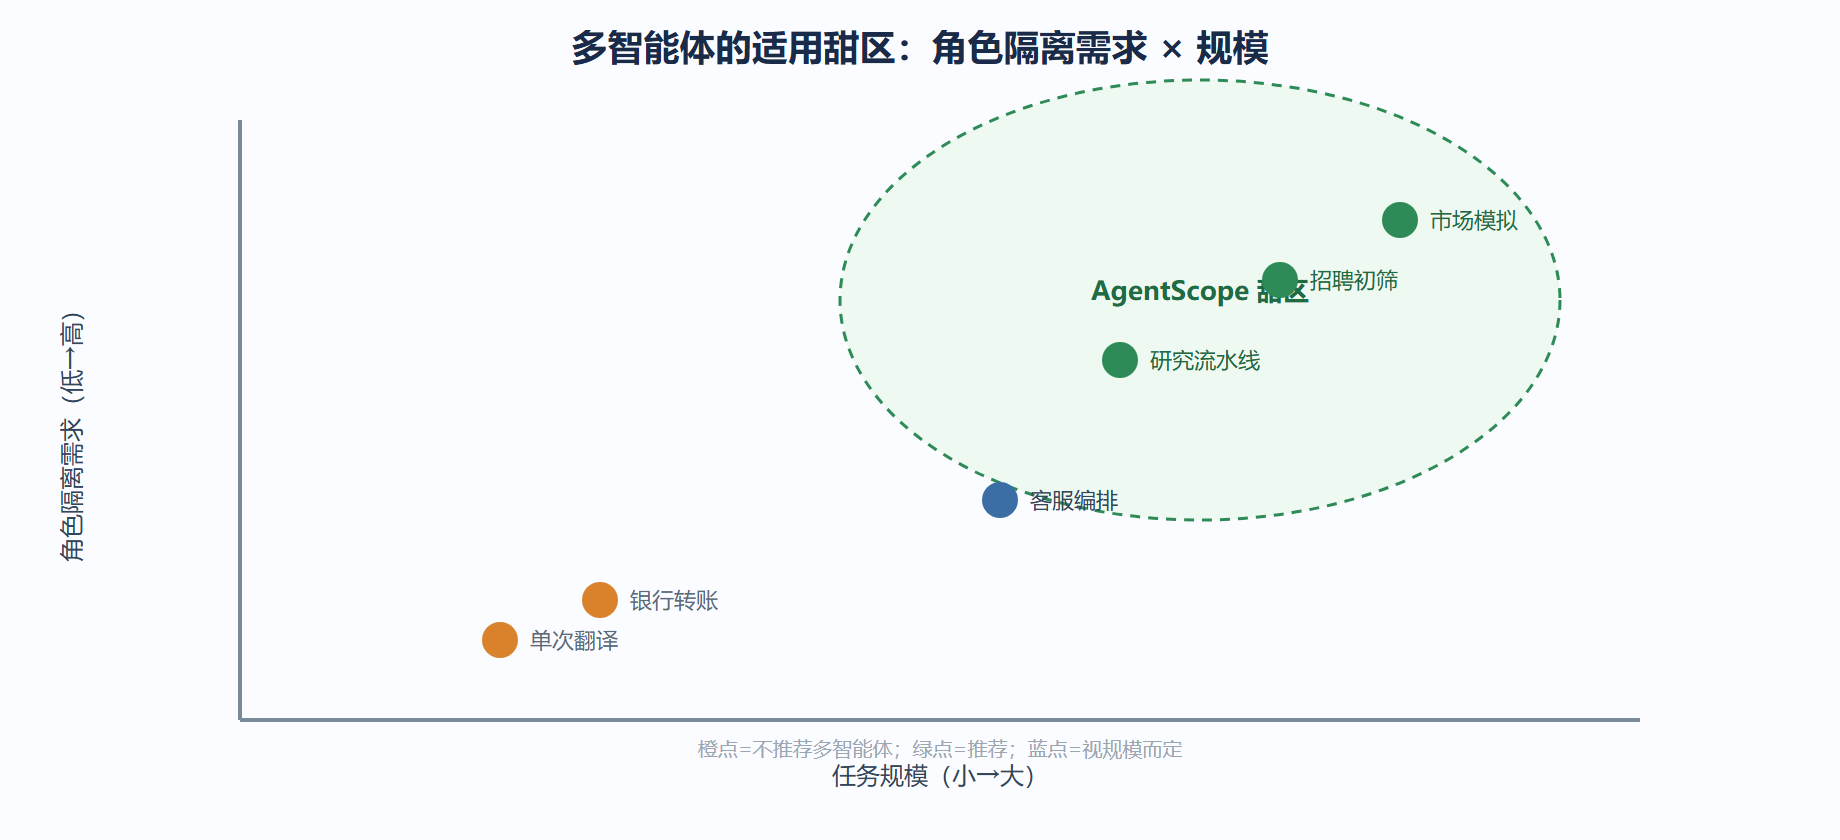
下面这张图把常见领域按"角色隔离需求"和"规模"两个轴摆开,你能直观看到 AgentScope 的甜区在哪。
动手自检清单
- 三类禁用:单次问答、强一致事务、极端低延迟。误用只会增加消息开销。
- 甜区信号:角色纪律需要被隔离、任务可失败需协商、有人机协同。本质是 1.1 临界点的具体化身。
- 适用性绑定规模:量级越小,单智能体越划算;越大越多角色,多智能体隔离收益越明显。
- 领域不是非黑即白,"客服编排"这类要看规模,不能一刀切说该不该上。
⚠️ 别用多智能体做银行转账这种强一致事务。异步、各持状态的天性,和"要么全成要么全不成"是天然冲突,硬做只会在边界 case 上出血。
💡 做技术选型时,先把"任务里有没有需要隔离的角色纪律"写下来。能写出来,再考虑 AgentScope;写不出,先想单智能体加工具能不能解决。