2.2 智能体(Agent)模型
2.2 智能体(Agent)模型
在体系中的位置:2.1 给了俯视图,这一节下钻到第一个零件——智能体。它是你写代码时打交道最多的对象,理解了它的"思考-行动"循环,第三章 3.2 写智能体才会顺。
我们用一个物理类比开头:智能体像一台有"感官入口(收消息)"和"表达出口(回消息)"的机器,中间是"记忆 + 大脑(模型)+ 手脚(工具)"。它不主动找别人,只被动等消息、处理、回应。这种"被动响应"是 AgentScope 智能体和传统主动 Agent 的一个重要区别,也是松耦合的来源。
智能体是什么:数字世界的行动主体
在 AgentScope 里,智能体不是一段脚本,而是一个有边界的对象。这个边界很关键:它内部怎么想、怎么调工具、怎么记上下文,外面一概不知;外面只知道"给它消息、它回消息"。这种封装带来两个直接好处——
第一,角色纪律可隔离。规划者智能体内部只维护"拆步骤"的上下文,不会被执行者"写代码"的上下文污染(这正是 1.3 招聘案例的症结)。
第二,可替换。你想把规划者从 GPT 换成另一个模型,只要换它内部的 model 字段,其他智能体毫无感知。
AgentScope 2.0 提供两类开箱智能体:DialogAgent(对话型,适合角色扮演、讨论)和 ReActAgent(推理-行动型,适合需要调工具的任务)。两者都遵循同一个 reply 契约。
基本原理:解构"思考-行动"循环
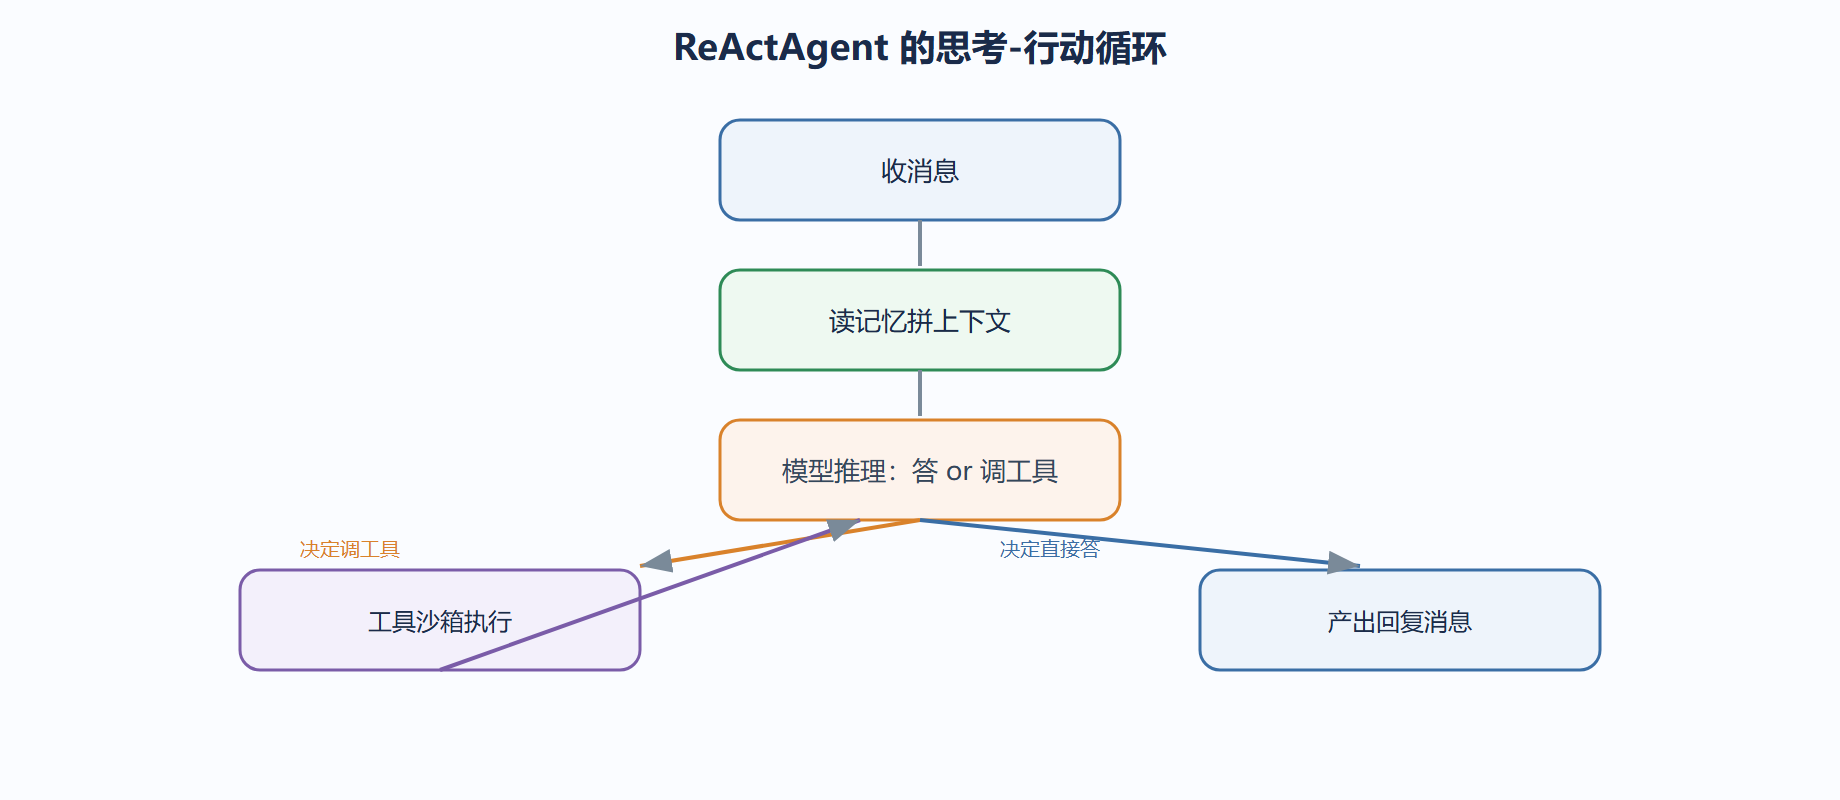
一个 ReActAgent 收到消息后,内部跑的循环可以拆成五步:
- 读记忆:把历史消息和当前消息拼成上下文。
- 想(模型推理):模型决定"下一步是直接回答,还是调某个工具"。
- 做(执行工具):若决定调工具,在沙箱里执行,拿到结果。
- 回想:把工具结果喂回模型,模型再决定下一步。
- 写记忆 + 回消息:循环结束,把结论写入记忆并产出回复消息。
这个循环里,"想"和"做"可能交替多次,直到模型认为能给出最终回答。下面用一张图把循环画清楚。
实现方法:构建一个智能体
下面用 2.0 主线 API 构建一个带工具的智能体。注意 Toolkit 把工具聚成一包,InMemoryMemory 是开箱即用的记忆后端。
from agentscope.agents import ReActAgent from agentscope.models import OpenAIChatModel from agentscope.toolkit import Toolkit from agentscope.memory import InMemoryMemory from agentscope.tools import tool # 1. 用 @tool 定义一个工具(AgentScope 兼容 1.x 装饰器写法) @tool def get_weather(city: str) -> str: """查询指定城市天气,返回温度与天气状况。""" # 真实场景这里调天气 API;演示返回固定值 return f"{city}:晴,26 摄氏度" # 2. 组装工具包 tk = Toolkit() tk.register_tool(get_weather) # 3. 构建智能体 agent = ReActAgent( name="天气助手", sys_prompt="你是天气助手,用户问天气时调用 get_weather 工具。", model=OpenAIChatModel(model_name="gpt-4o-mini", api_key="环境变量占位"), toolkit=tk, # 手脚 memory=InMemoryMemory(), # 记忆 ) # 4. 收消息、回消息(被动响应契约) reply = agent(Msg(name="user", content="北京天气如何?", role="user")) print(reply.content)
运行输出(典型):智能体先内部决定调 get_weather("北京"),拿到"晴,26 摄氏度"后,组织成自然语言回复。你看到的最终 reply.content 类似"北京今天天气晴,气温 26 摄氏度,适合出行。"字段结构由模型决定,但工具调用的触发逻辑是确定性的。
对比 1.x 写法:旧版要继承 AgentBase 并重写 reply。2.0 把这套循环内置进 ReActAgent,你只填配置。两种写法在 3.2 都会给全,这里先建立"配置即智能体"的心智。
DialogAgent 与 ReActAgent 怎么选
这是实打实的选型问题,不是文档填空。
- 选
DialogAgent:当任务以"对话、讨论、角色扮演"为主,几乎不调外部工具。比如辩论赛里的辩手、模拟面试的面试官。 - 选
ReActAgent:当任务需要"推理后行动",尤其要调工具查数据、跑代码。比如调研员、执行者。
一个常见错误是用 DialogAgent 硬接工具——它不是不能,但工具调用的稳定性不如 ReActAgent 内置的循环。能确定要调工具,就直接用 ReActAgent。
把选型落进代码:两个辩手用 DialogAgent 互辩(不调工具),第三个事实核查员用 ReActAgent 在需要时对外部数据发起检索。一个 MsgHub 让它们共享同一场对话。
# DialogAgent(对话)+ ReActAgent(可调工具)混编 from agentscope.agents import DialogAgent, ReActAgent from agentscope.msghub import MsgHub from agentscope.models import OpenAIChatModel from agentscope.message import Msg model = OpenAIChatModel(model_name="gpt-4o-mini", api_key="环境变量占位") pro = DialogAgent(name="正方", sys_prompt="你支持论点 A,用逻辑反驳对方。", model=model) con = DialogAgent(name="反方", sys_prompt="你反对论点 A,指出漏洞。", model=model) fact = ReActAgent(name="核查员", sys_prompt="当双方出现事实争议时,检索并给出依据。", model=model) async def debate(): async with MsgHub([pro, con, fact]) as hub: await hub.broadcast(Msg("user", "论点 A:远程办公提升效率。开始辩论。", "user")) await pro() await con() await fact() # 仅在出现"数据来源"类争议时,ReActAgent 才会触发工具 # asyncio.run(debate())
运行输出(典型):正方、反方各发言一轮;当反方抛出"有研究指出效率下降 15%"却无出处时,核查员触发检索工具,返回"该数据来自某 2023 调研样本量 200",并附链接占位。两类智能体的分工在代码里一目了然——DialogAgent 维持对话纪律,ReActAgent 只在确须查证时行动。
案例:双智能体协作写报告
背景:需要"先列提纲、再补内容"。两件事知识结构不同(提纲要结构、内容要细节)。
操作:规划者用 DialogAgent(只产出提纲,不调工具),写作者用 ReActAgent(可调检索工具补全内容)。两者入同一个 MsgHub,规划者发言后写作者可见。
结果:提纲和正文由各自维持纪律的智能体完成,质量比单智能体混杂高。
解读:这里收益来自 2.1 说的"边界隔离"——两个智能体各管各的上下文,不互相稀释注意力。
变式:若提纲和内容耦合很紧(比如写诗,结构即内容),拆开反而丢失连贯,此时单智能体更合适。再次印证 1.3 的临界点判断。
动手清单
- 智能体是"有边界的对象":对外只暴露收消息/回消息,内部封装模型、记忆、工具。
- 思考-行动循环五步:读记忆→推理→(调工具)→回想→写记忆+回消息,可多轮交替。
- 2.0 用
ReActAgent/DialogAgent配置即智能体;要调工具优先ReActAgent。 - 边界隔离的直接价值,是让不同角色纪律互不稀释注意力。
⚠️ 别用 DialogAgent 硬扛工具调用密集的任务。它的工具循环不如 ReActAgent 稳,遇到复杂多步调用容易中途跑偏。
💡 判断一个智能体该不该独立成类,看"它的上下文会不会被另一个角色污染"。会,就拆;不会,合并更省事。