2.5 记忆与状态持久化
2.5 记忆与状态持久化
在体系中的位置:2.2 提过智能体内部有"记忆",这一节把它讲透。记忆和状态持久化决定了系统能不能"连续"——没有它,每个智能体都是瞬时失忆,长任务直接崩。这是多智能体从 demo 走向生产的硬门槛。
先讲因果:为什么需要持久化?因为智能体的运行态(当前进度、待办、已积累经验)只活在进程内存里。进程一重启,全没了。对聊两句的 demo 无所谓,对跑几小时的多智能体流水线,重启等于从头再来——不可接受。所以"把状态存下来、能恢复"是生产必备。
它解决什么:为什么需要持久化
日常常混用,AgentScope 里要分清:
状态(State):某一时刻的完整快照——配置、当前流程节点、待办队列、记忆引用。它是瞬态、动态变化的,像电影某一帧。
记忆(Memory):积累的经验与历史总和——会话记录、工作记忆、长期知识。它是持续累积的,是形成"专长"的基础。
状态持久化 = 把快照存到非易失介质(如 JSON/YAML 文件);记忆持久化 = 把关键经验结构化存储(如 SQLite、向量库)以便检索。两者配合,重启后能恢复到断点,且带得走历史。
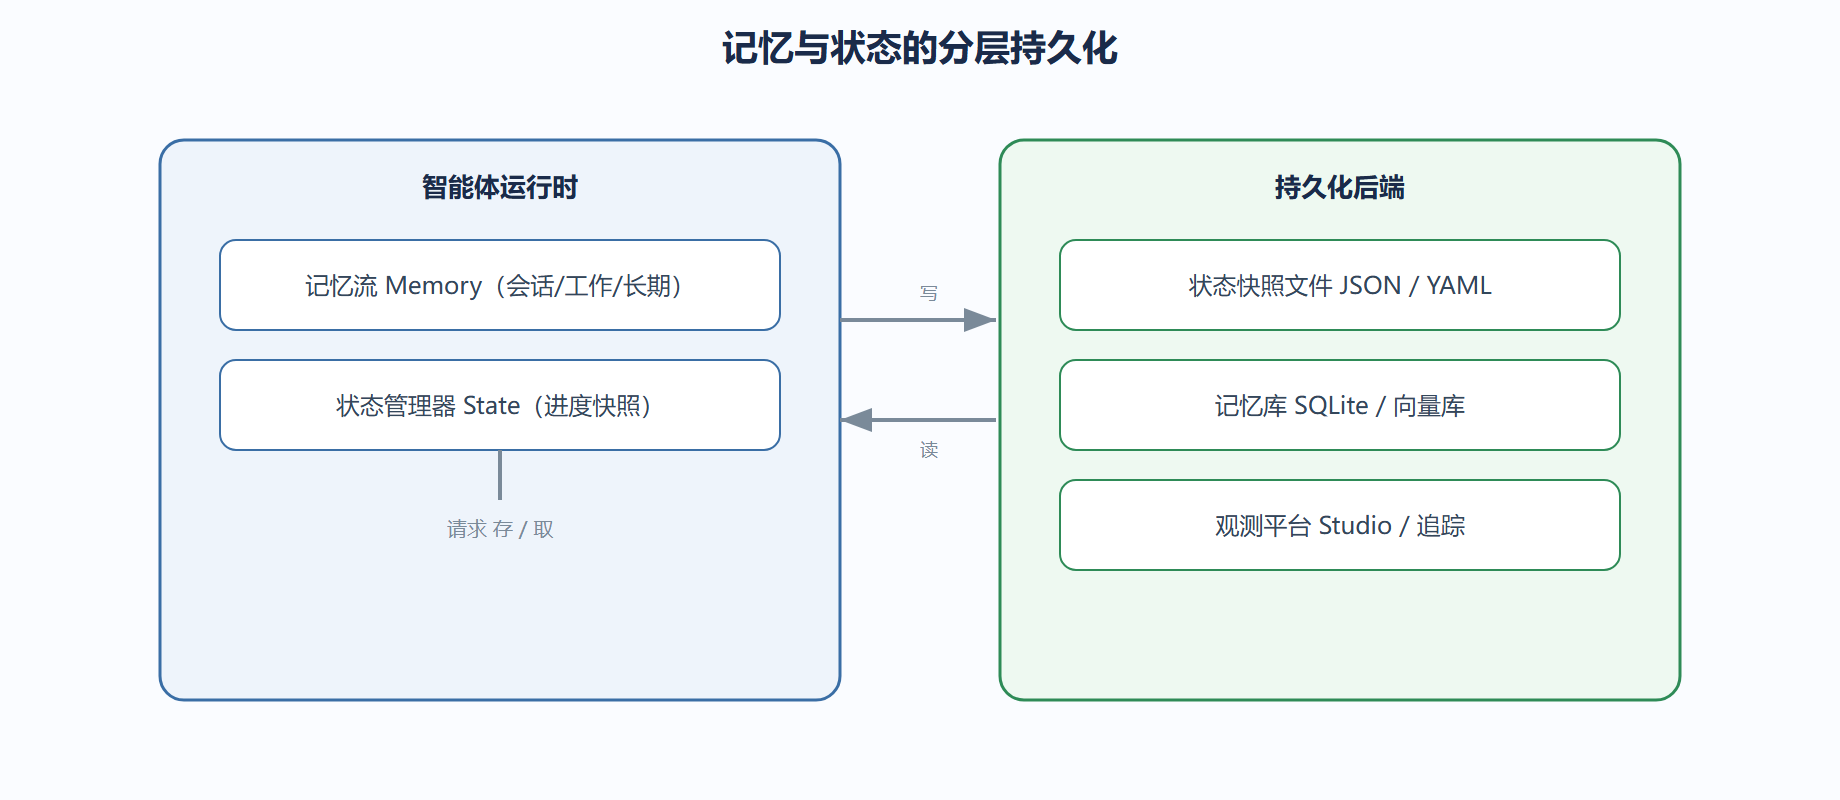
分层存储与按需检索
AgentScope 的记忆设计哲学是"分层存储、按需检索",平衡性能与成本。架构如下:
用 InMemoryMemory 与可替换后端
2.0 主线用 InMemoryMemory 开箱即用;长任务可换持久化后端。下面看基本用法与持久化开关。
from agentscope.memory import InMemoryMemory from agentscope.agents import DialogAgent from agentscope.models import OpenAIChatModel mem = InMemoryMemory() # 进程内记忆,重启即失 agent = DialogAgent( name="助理", sys_prompt="你是长期助理,需要记住用户偏好。", model=OpenAIChatModel(model_name="gpt-4o-mini", api_key="环境变量占位"), memory=mem, ) # 多轮对话,记忆自动累积 agent(Msg(name="user", content="我喜欢用暗色主题", role="user")) agent(Msg(name="user", content="推荐个配色", role="user")) # 第二轮时,mem 里已含第一轮偏好,助理能结合上下文回答 for m in mem.get_memory(): print(m.name, ":", m.get_text_content())
运行输出(典型):打印两条 user 消息及助理的回复,证明记忆跨轮保留。若换持久化后端(如写入 SQLite),进程重启后 get_memory() 仍能读回历史,实现"断点续跑"。
代价提醒:记忆无限增长会撑爆上下文、拖慢推理。3.5 性能优化会讲记忆压缩与摘要策略。这里先记住——记忆不是越多越好,是"该留的留、该压的压"。
把"状态快照"落成代码:长流程每走完一步,把"当前节点 + 各步结论"写成 JSON 文件。重启后读回快照,从断点续跑,而不是从头再来。
# 状态持久化:把流程进度写成快照文件 import json from pathlib import Path SNAP = Path("reimburse_state.json") def save_state(node: str, conclusions: dict) -> None: """每完成一步调用一次,写入当前节点与已得结论。""" snapshot = {"current_node": node, "conclusions": conclusions} SNAP.write_text(json.dumps(snapshot, ensure_ascii=False, indent=2), encoding="utf-8") def load_state() -> dict: """重启后调用,读回断点;无快照则从头开始。""" if SNAP.exists(): return json.loads(SNAP.read_text(encoding="utf-8")) return {"current_node": "start", "conclusions": {}} # 模拟:填单完成,记录进度 save_state("主管审", {"form_filled": True}) print(load_state()) # {'current_node': '主管审', 'conclusions': {'form_filled': True}}
运行输出(典型):load_state() 返回 {'current_node': '主管审', 'conclusions': {'form_filled': True}}。进程即便此刻崩溃重启,也能从"主管审"节点接着走,已填的表单结论不丢。这就是和 InMemoryMemory(重启即失)互补的状态持久化——记忆管"记得什么",状态管"现在该干哪步"。
案例:长流程报销系统的状态恢复
背景:报销流程长(填单→主管审→财务核→打款),跑两小时,中途进程可能因发布重启。
操作:每完成一步,状态管理器把"当前节点 + 各步结论"写成快照文件。重启后从快照恢复,不重跑已完成的步。
结果:一次意外重启,用户无感;系统从"财务核"接着走,而非从头填单。
解读:这里状态持久化避免了重复劳动和用户体验断裂。若只有记忆没有状态快照,重启后智能体虽记得历史,却不知道"现在该做哪步",仍会乱。
变式:若流程允许重跑(幂等),可不存细粒度状态,只存最终结果。是否持久化状态,取决于"重跑成本高不高"——成本高才值得存。
要点速记
- 状态=某刻快照(瞬态),记忆=累积经验(持续),两者抽象不同、持久化方式不同。
- 分层设计:运行时记忆/状态 → 持久化后端(文件/库/观测),平衡性能与成本。
InMemoryMemory开箱即用;长任务换持久化后端实现断点续跑。- 记忆不是越多越好,无限增长会撑爆上下文,需压缩(见 3.5)。
⚠️ 只有记忆没有状态快照,重启后智能体"记得过去却不知现在该干啥"。长流程务必存状态,否则重跑会乱套。
💡 判断要不要持久化状态,看"重跑成本高不高"。填单这类高成本必存;幂等可重跑的任务,存最终结果即可,别过度持久化。