4.2 扩展与集成
4.2 扩展与集成
在体系中的位置:4.1 看人,这一节看系统——AgentScope 不是孤岛,它要和你已有的模型、存储、业务系统咬合。集成能力决定了它能不能进你的真实技术栈,而不是只在 notebook 里跑 demo。
一个事实先摆:企业里 80% 的工作量不在"写智能体",而在"让智能体和现有系统对话"——数据库、消息队列、内部 API、前端。AgentScope 的扩展点(模型可换、工具可接、记忆后端可替)正是为这种咬合设计的。
模型集成:不止一家
2.0 主线支持多家模型,切换基本是换 model 字段。下面给一个抽象封装,让换模型不动业务。
import os from agentscope.models import OpenAIChatModel, DashScopeChatModel def build_model(provider: str = "openai"): """按配置构建模型,业务层只调 build_model(),不关心哪家。""" if provider == "openai": return OpenAIChatModel(model_name="gpt-4o-mini", api_key=os.environ["OPENAI_API_KEY"]) if provider == "dashscope": return DashScopeChatModel(model_name="qwen-max", api_key=os.environ["DASHSCOPE_API_KEY"]) raise ValueError(f"未知模型方:{provider}") # agent = ReActAgent(name="x", sys_prompt="...", model=build_model(), toolkit=tk)
运行说明:业务层只认 build_model() 返回的模型对象,换供应商改一行配置。这把 2.1 说的"灵活在配置"落到集成层——模型是可替换插槽,不是硬编码依赖。
记忆后端集成:接你的向量库
2.5 提过记忆后端可替。生产里常要接自有向量库做长期记忆检索。集成思路是:实现框架记忆接口,内部转发到你的库。
# toolkit=tk, memory=MyVectorMemory())
运行说明:自定义记忆后端实现 add/get_memory 等接口,内部对接你的向量库。智能体代码不变,记忆存储从内存换成"向量库+检索"。长期任务和"记得准"的需求靠这个集成点落地。
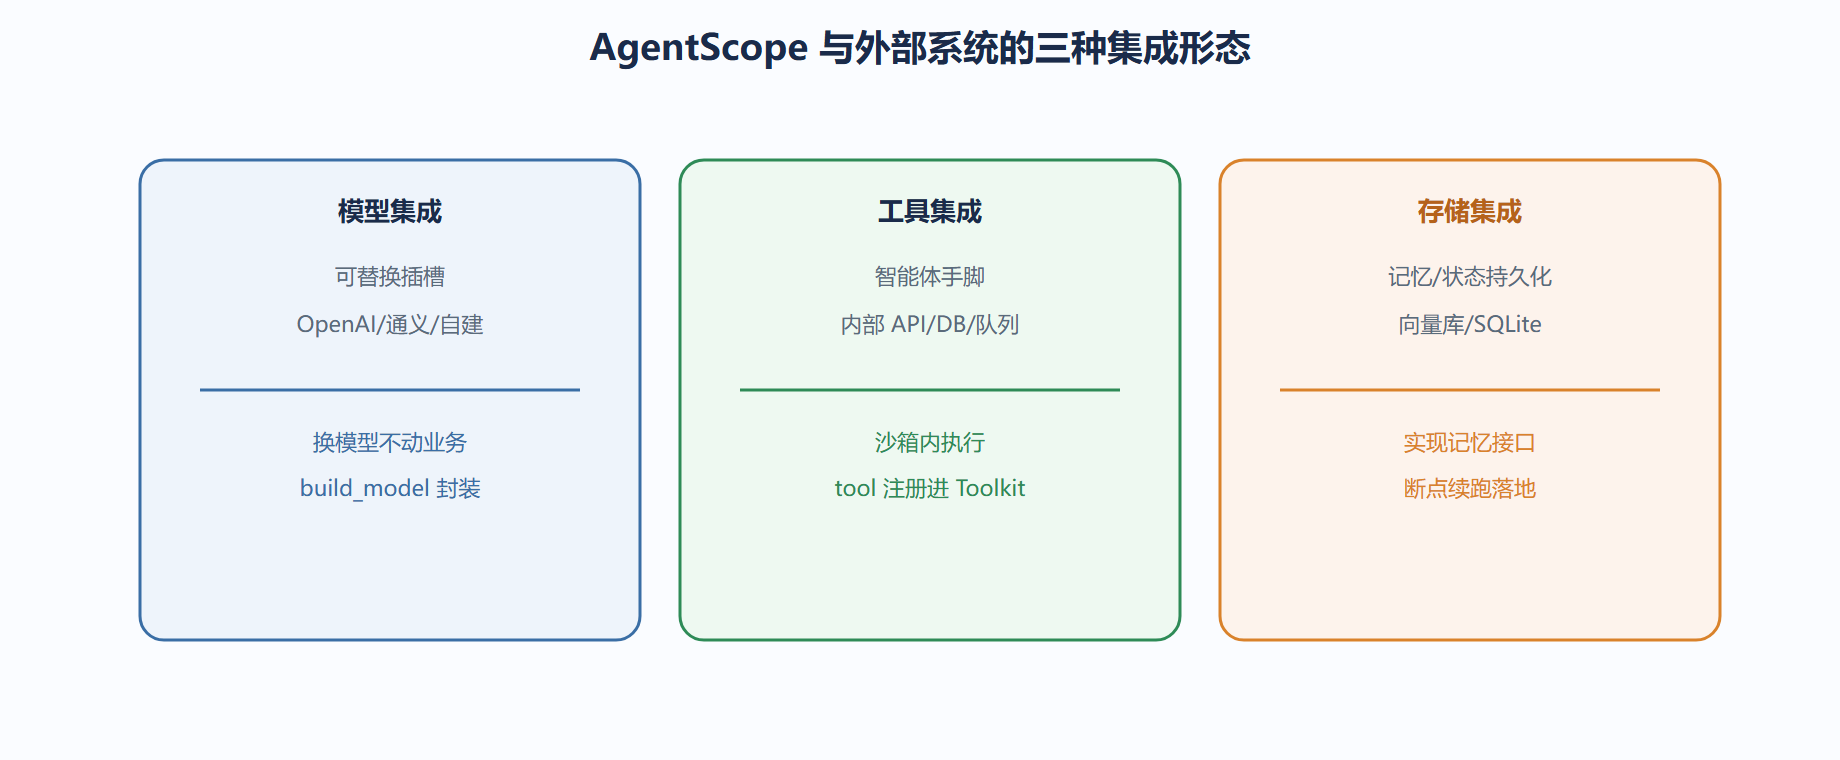
与外部系统的三种集成形态
AgentScope 和外部世界的交互,归纳成三种形态,下面一张图说清边界。
案例:把 AgentScope 接进企业工单系统
背景:公司已有工单系统(REST API),希望用多智能体自动分派和回复。
操作:①用 build_model() 接公司允许的模型;②写 @tool 把"查工单、更新状态、发回复"包成工具;③自定义记忆后端接公司向量库,记住历史工单规律;④智能体通过工具与工单 API 交互,全程在沙箱。
结果:多智能体跑通自动分派,且和现有系统通过工具 API 解耦——工单系统无感知,只当多了个调用方。
解读:这里三种集成形态全用上。关键是"通过工具 API 交互"而非"改工单系统代码",集成零侵入。这正是 AgentScope 在企业落地的典型姿势。
变式:若公司合规要求"模型不能出内网",用自建模型(如本地部署的开放权重模型)替换 build_model() 的 provider,业务与工具代码一行不动。可替换模型插槽在合规场景价值最大。
四之一、接入外部 API:适配器模式隔离第三方
接外部 API 最怕"API 一改,智能体全崩"。正确做法是用适配器(Adapter)模式把第三方包一层,智能体只认你定义的稳定接口,第三方细节锁在适配层。
from agentscope.tools import tool from typing import Dict, Any class WeatherAdapter: """把第三方天气服务适配成统一接口,第三方变动只改这里。""" def __init__(self, endpoint: str): self.endpoint = endpoint # 外部服务地址(配置注入) def fetch(self, city: str) -> Dict[str, Any]: # 实际项目里这里用 requests 发 HTTP 请求并解析 # resp = requests.get(f"{self.endpoint}/v1/weather", params={"city": city}) # return resp.json() return {"city": city, "temp": 21, "cond": "晴"} # 模拟返回 adapter = WeatherAdapter(endpoint="weather-gateway") @tool def get_weather(city: str) -> str: """查天气,智能体只看到统一接口,不关心第三方怎么实现。""" data = adapter.fetch(city) return f"{data['city']} 当前 {data['temp']}℃,{data['cond']}" # '杭州 当前 21℃,晴'
运行说明:智能体调用 get_weather("杭州") 拿到的是稳定文本,至于底层是哪家天气服务、字段怎么变,全锁在 WeatherAdapter 里。哪天换供应商,只改适配器构造函数传入的 endpoint 和 fetch 解析逻辑,工具和智能体代码零改动——这就是适配器模式在集成层的价值。
四之二、接入消息队列:让智能体异步解耦
很多生产系统用消息队列做削峰和解耦。把 AgentScope 智能体接成队列的消费者,能让"触发"和"执行"分离:上游业务只投递任务消息,智能体在队列另一端异步处理。
# task_queue = queue.Queue() # 实际可换成 Redis/RabbitMQ 等中间件 # # task_queue.task_done() # # # 智能体与上游完全解耦,靠队列缓冲流量峰值
运行说明:这里智能体不主动"拉"业务,而是被队列驱动。好处有三:上游高峰时任务在队列里堆积,智能体按自己节奏消费,不会被打爆;智能体和投递方互不感知,任一方升级不影响对方;多智能体可各自订阅不同队列做分工。代价是引入了一层中间件运维,小项目用不到。
四之三、工具集成的权限最小化
接内部系统时,工具注册最容易犯的错是"图省事把高权限接口全暴露"。正确姿势是工具层做参数白名单和副作用隔离。
from agentscope.tools import tool ALLOWED_STATUS = {"open", "pending", "closed"} # 状态白名单 @tool def update_ticket(ticket_id: str, status: str) -> str: """更新工单状态,只允许白名单内状态,拒绝越权操作。""" if status not in ALLOWED_STATUS: return f"ERROR: 非法状态 {status}" # 实际:requests.patch(endpoint, json={"status": status}) return f"OK: 工单 {ticket_id} 已置为 {status}" # 'ERROR: 非法状态 deleted'
运行说明:工具内部先校验 status 是否在白名单,越权操作直接返回 ERROR 消息而非真正下发。这与 3.6"故障即消息"呼应——连权限错误都被表达成消息,系统可据此协商而非崩溃。沙箱 + 白名单双保险,是接内部系统集成的底线。
本节要点回顾
- 模型集成:封装
build_model(),换供应商改配置不动业务,模型是可替换插槽。 - 记忆集成:实现记忆接口对接自有向量库,长期记忆与"记得准"靠此落地。
- 工具集成:把内部 API/DB 包成
@tool,沙箱内执行,与现有系统零侵入对接。 - 三种集成形态(模型/工具/存储)共同决定 AgentScope 能否进真实技术栈。
⚠️ 接内部系统的工具务必走沙箱且只暴露最小权限 API。别把"能删库"的接口直接注册成工具,沙箱不是万能,权限最小化仍是底线。
💡 集成第一原则:让 AgentScope 通过 API 调你的系统,而不是改你的系统来适配 AgentScope。零侵入集成才能在生产环境 safely 迭代。