1.4 典型应用场景与价值主张
1.4 典型应用场景与价值主张
场景代入一下:你是一个数据团队负责人,老板要你"下周一前把上季度销售数据做成可交互的分析面板"。如果交给单 Agent,它会吐一段代码让你自己跑;如果交给"数据分析师 Agent + 代码执行 Agent + 复核 Agent"的协作,前者和你确认口径,中间跑数,后者把关口径对不对。哪种更省你的心,答案明显。这一节我们列几个真实落地的场景,并讲清每个场景里"对话"到底在编排什么。
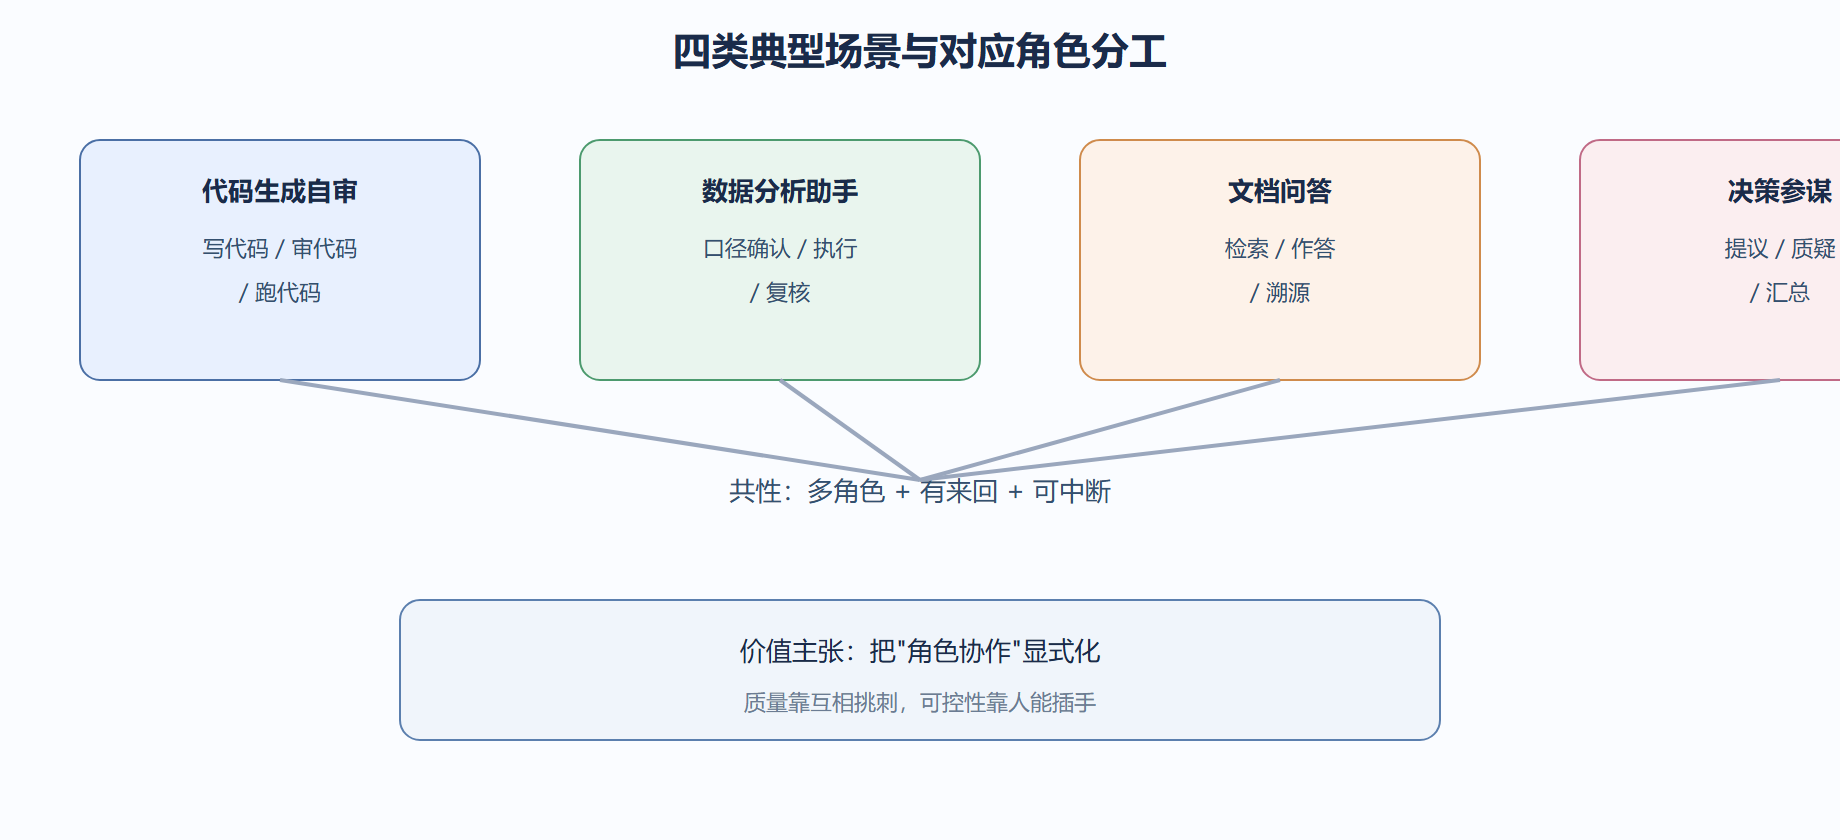
场景一:代码生成与自审
最经典的用法。一个 Agent 写代码,一个 Agent 以资深工程师视角审,指出边界问题和测试缺口,写代码的再改。我们实测过,加上审稿环节后,一次跑通率明显提升。代价是多一次模型调用、延迟翻倍,但相比你手动 debug 三小时,这笔账划算。
# 代码自审双 Agent 骨架(第四章才会加 GroupChat,这里先手动串) from autogen import ConversableAgent cfg = {"model": "gpt-4o-mini", "api_key": "YOUR_KEY"} dev = ConversableAgent("dev", llm_config=cfg, system_message="你写 Python,注意边界。") rev = ConversableAgent("rev", llm_config=cfg, system_message="你审代码,只挑问题不给赞美。") chat = dev.initiate_chat(rev, message="写一个读取 csv 并算均值的函数。", max_turns=4) # 你会看到 dev 先给代码,rev 指出没处理空文件,dev 再补
场景二:数据分析助手
业务方用自然语言提需求,Agent 先确认指标口径(避免"销售额"到底是含退还是不含退),再生成并执行查询,最后由复核 Agent 检查口径是否一致。这个场景里"对话"编排的是人和系统之间的对齐。
场景三:文档问答与溯源
检索 Agent 找片段,作答 Agent 组织语言,溯源 Agent 把引用标回原文。多角色让"答得准"和"答得有据"分开保证,比单 Agent 更易信。
场景四:决策参谋
让"提议 Agent"和"质疑 Agent"互相辩,最后"汇总 Agent"给结论。金融和运筹里常用,因为它把"确认偏误"显性化——有一个角色专门唱反调。
价值主张小结
- 质量来自角色间互相挑刺,不是来自单个模型更聪明。
- 可控性来自人能在关键节点插手(详见第四章 4.5)。
- 可扩展性来自加一个角色比改一段流程简单。
# 决策参谋的极简骨架:提议与质疑对辩 cfg = {"model": "gpt-4o-mini", "api_key": "YOUR_KEY"} proposer = ConversableAgent("proposer", llm_config=cfg, system_message="你提方案并论证。") critic = ConversableAgent("critic", llm_config=cfg, system_message="你只找方案漏洞。") chat = proposer.initiate_chat(critic, message="方案:用缓存降低推理成本。", max_turns=4)
怎么判断一个任务该不该上框架
前面列了四类场景,但真实世界的需求不会自己贴标签。我们给你一把可直接用的判断尺:先看"三特征"——是否多角色、是否有来回、是否可中断。三个都满足,框架收益最高;只满足一个(比如直线批处理),用手写脚本反而更省。再看"失败成本":如果出错能靠加一个复核角色就拦住,那多智能体的互审价值就大;如果任务本质是一条确定性流水线,加角色只会徒增延迟。金融场景里我们特别看重"确认偏误"——一个人(或单 Agent)容易越想越觉得自己对,而"质疑 Agent"把偏误显性化,这正是多智能体在决策参谋里比单 Agent 稳的根本原因。
成本维度也必须算清。多角色意味着多次模型调用,延迟和账单随角色数近似线性上升。所以选型时别只问"能不能做",要问"多用几次调用的钱能不能换回质量或可控性"。代码自审多一次调用、延迟翻倍,但免去你三小时手动 debug,这笔账划算;可若只是给文本加个标点也要三个 Agent 轮流,那就是浪费。一句话:让框架做它擅长的事(协作、对齐、互审),把确定性的活留给普通代码。
场景落地时的常见阻力
列完场景,真实团队常卡在落地第一关。阻力一:负责人觉得"加角色就是加成本",不愿试。破解方法是算清失败成本——代码自审多一次调用换来少三小时 debug,这笔账在多数团队都是正的,用数据而非情怀说服人。阻力二:业务方担心"多个 Agent 说话不可控"。这恰恰要靠第四章的终止条件和人机协作来化解,把"可中断"从口号变成配置。阻力三:团队想把场景一口气做到完美,结果原型期就被复杂协作拖垮。正确做法是先用双 Agent 跑通一类场景,验证价值再加角色,和第六章的生命周期节奏一致。
还有个思维陷阱:看到别人的炫酷场景就照搬。你的业务痛点才是选型起点,不是别人的 demo。如果一个场景里"互审"带来的质量提升对你无关紧要(比如一次性的文本润色),那就别硬上多智能体,单 Agent 或普通脚本更合适。场景清单是启发,不是任务表。
本节要点回顾
- 四类场景共性:多角色、有来回、可中断。
- 价值主张:质量靠互审、可控靠人插手、扩展靠加角色。
- 选场景时先判断是否符合"三特征",不符合就别硬上。
- 选型还要算成本:多次调用换回的质量/可控性是否值当。
- 落地阻力靠算失败成本、配终止条件、先小后大来化解。
- 价值主张有边界:当任务没有"互审"收益时,多智能体反而是负担。
价值主张怎么向老板讲清楚
技术人员容易陷入"讲技术多酷",但决策者关心的是投入产出。向老板讲价值主张时,建议用三条可量化的线:其一,质量线——加一个复核角色后,一次跑通率从多少升到多少,对应省下多少人工返工小时;其二,可控线——关键节点能插人工确认,意味着风险事件的可拦截率提升,这是合规和事故成本的下降;其三,扩展线——加一个角色的平均工时,对比改一段硬编码流程的工时,前者通常低一个数量级。把这三条用你业务的数字填进去,比任何架构图都有说服力。价值主张不是口号,是能被算账的。
⚠️ 别把 AutoGen 塞进直线型批处理任务,那只会让你的延迟和账单翻倍,质量没提升。
💡 对话即编排在场景里的落地:你设计的不是算法,而是"谁和谁对话、在哪停下"。