5.1 性能优化与效率提升
5.1 性能优化与效率提升
单机能跑和能扛压是两回事。当你把多智能体系统从笔记本搬到业务里,首批瓶颈往往是:重复推理烧钱、串行等待拖时长、长上下文吃内存。这一节给三个能直接落地的优化:缓存、并发、上下文压缩。
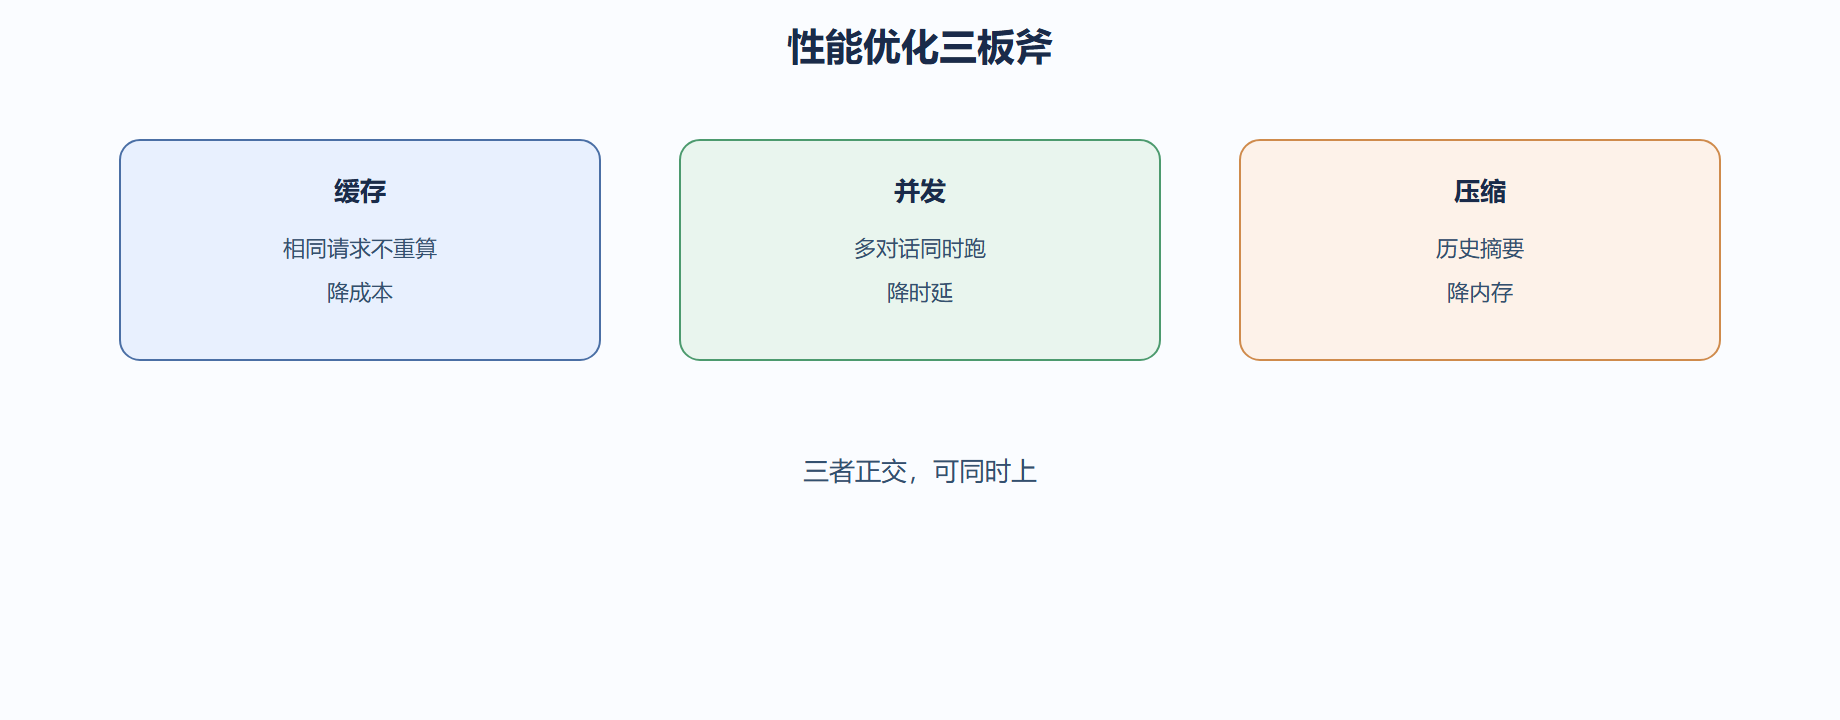
缓存:相同请求不重算
框架支持对模型响应做缓存——相同输入直接返回上次结果,不调模型。对"一批用户问相似问题"的场景,命中率很高,成本直降。
from autogen import ConversableAgent import os cfg = {"model": "gpt-4o-mini", "api_key": os.environ.get("OPENAI_API_KEY"), "cache_seed": 42} # 设 seed 开启确定性缓存 agent = ConversableAgent("a", llm_config=cfg, system_message="你答固定问题。") # 同样的问题问两次,第二次命中缓存,不花模型调用
并发:多对话并行
多个独立对话之间没有依赖,就别串行等。用线程或异步同时发起,总时延约等于最慢那个,而不是叠加。
import concurrent.futures from autogen import ConversableAgent import os cfg = {"model": "gpt-4o-mini", "api_key": os.environ.get("OPENAI_API_KEY")} def run_one(q): a = ConversableAgent("a", llm_config=cfg, system_message="你答。") b = ConversableAgent("b", llm_config=cfg, system_message="你回。") return a.initiate_chat(b, message=q, max_turns=2).summary questions = ["问题一", "问题二", "问题三"] with concurrent.futures.ThreadPoolExecutor(max_workers=3) as ex: results = list(ex.map(run_one, questions)) # 三个对话并行 # 总时延约等于单个,而非三倍
上下文压缩:历史摘要
长对话喂给模型的 token 越来越多。用模型把历史压成摘要再继续,既保关键信息又省 token。框架可配摘要策略,也可手动定期改写系统提示(见 3.5)。
工程取舍
- 缓存:几乎无副作用,强力推荐,但只省"重复"请求的钱,不省首问。
- 并发:降时延但增瞬时负载,注意模型服务方的限流。
- 压缩:省钱但可能丢细节,关键任务谨慎。
我们主张:上线先开缓存,再视时延加并发,压缩作为长对话的最后手段。
怎么衡量优化有没有用
三个手段都好用,但上之前先量基线、上之后量增量,别凭感觉。缓存看命中率:如果业务里相似问题占比低,命中率接近零,开缓存只多一份存储开销、省不下钱,这种情况不如把精力放并发。并发看"加速比":理想情况下 N 个并行把时延降到 1/N,但受模型服务端限流和本地线程切换成本影响,实际往往达不到;所以并发前务必确认服务方每秒配额,否则并行越多被限越狠,反而更慢。压缩看"信息保全率":把历史压成摘要,关键任务可能因丢细节而答偏,所以要对比压缩前后的产出质量,不能只看 token 数。
我们用物理来类比:缓存像把常用零件预制好放手边,重复用就省工;并发像多开几条产线同时干活,但产线越多对供电(模型配额)压力越大;压缩像把图纸缩印带走,省纸但可能看不清某处标注。三种手段都是"用一种资源换另一种"——缓存换存储、并发换瞬时负载、压缩换信息。选型就是看你的瓶颈是钱、是时延、还是上下文长度。
| 手段 | 换来什么 | 牺牲什么 | 先确认 |
|---|---|---|---|
| 缓存 | 省重复推理成本 | 一点存储 | 相似请求占比高 |
| 并发 | 降总时延 | 瞬时负载/限流风险 | 服务方配额够 |
| 压缩 | 省 token/内存 | 可能丢细节 | 摘要保全率可接受 |
优化不能以牺牲质量为代价
三条优化手段里,压缩最容易被滥用。为了省 token 把历史压成摘要,可能丢掉代码里一处关键边界条件,模型接着写出错代码——你省了几分钱 token,赔上的是产物不可用。所以压缩只适合"对话长但早期内容对后续影响小"的场景,比如闲聊式探索;对"每一步都依赖前面精确结果"的任务(如代码生成自审),压缩要格外谨慎,或只压缩明确冗余的部分。
并发也有隐性代价:并行跑多个对话,如果每个都调同一个有速率限制的服务,瞬间并发会把你整体限流,反而比串行还慢。所以并发的"度"要对照服务配额调,不是开得越大越好。我们给的底线建议:先开缓存(几乎零副作用、强推荐),再视时延加并发(确认配额),压缩作为长对话的最后手段且在关键任务关闭。这条顺序本身就是"质量优先于省钱"的体现——优化是为了让系统跑得不贵不慢,不是为了把账单选最低。
本节要点回顾
- 缓存靠 cache_seed 开启,省重复请求成本。
- 并发用线程并行独立对话,降总时延。
- 压缩用摘要换 token,关键任务慎用。
- 优化前量基线、后量增量,按瓶颈选手段。
- 压缩/并发有质量代价,顺序上缓存优先、质量优先于省钱。
- 任何优化上线后都要回到监控(6.4)验证是否真降本而不伤质量。
优化到什么程度该停
性能优化有个收益递减点,别陷入"为了再快一点无限加码"。经验法则:当优化把时延或成本降到业务可接受区间(比如用户能容忍的响应时间、预算内的单次成本),就停手,把精力转去质量和功能。继续压边际收益很小,却可能因为并发调太高触发限流、或压缩太狠伤质量,反而得不偿失。判断是否"可接受",回到你的业务指标而非技术指标——用户感知不到的 200 毫秒优化,不如去修一个常错的 Agent。优化是手段不是目的,系统"够快够省且答得对"才是终点。
⚠️ 开并发前确认模型服务不限流,否则并行越多被限越狠,反而更慢。
💡 性能优化是"对话即编排"走向生产的必经关——编排对了,还得跑得不贵不慢。