5.3 错误处理、调试与日志分析
5.3 错误处理、调试与日志分析
出错不可怕,怕的是定位不到。多智能体系统的 bug 常不在代码语法,而在"某轮某 Agent 说了句奇怪的话,后面全歪"。这一节给一套能落地的排错工具:日志、回放、异常兜底。
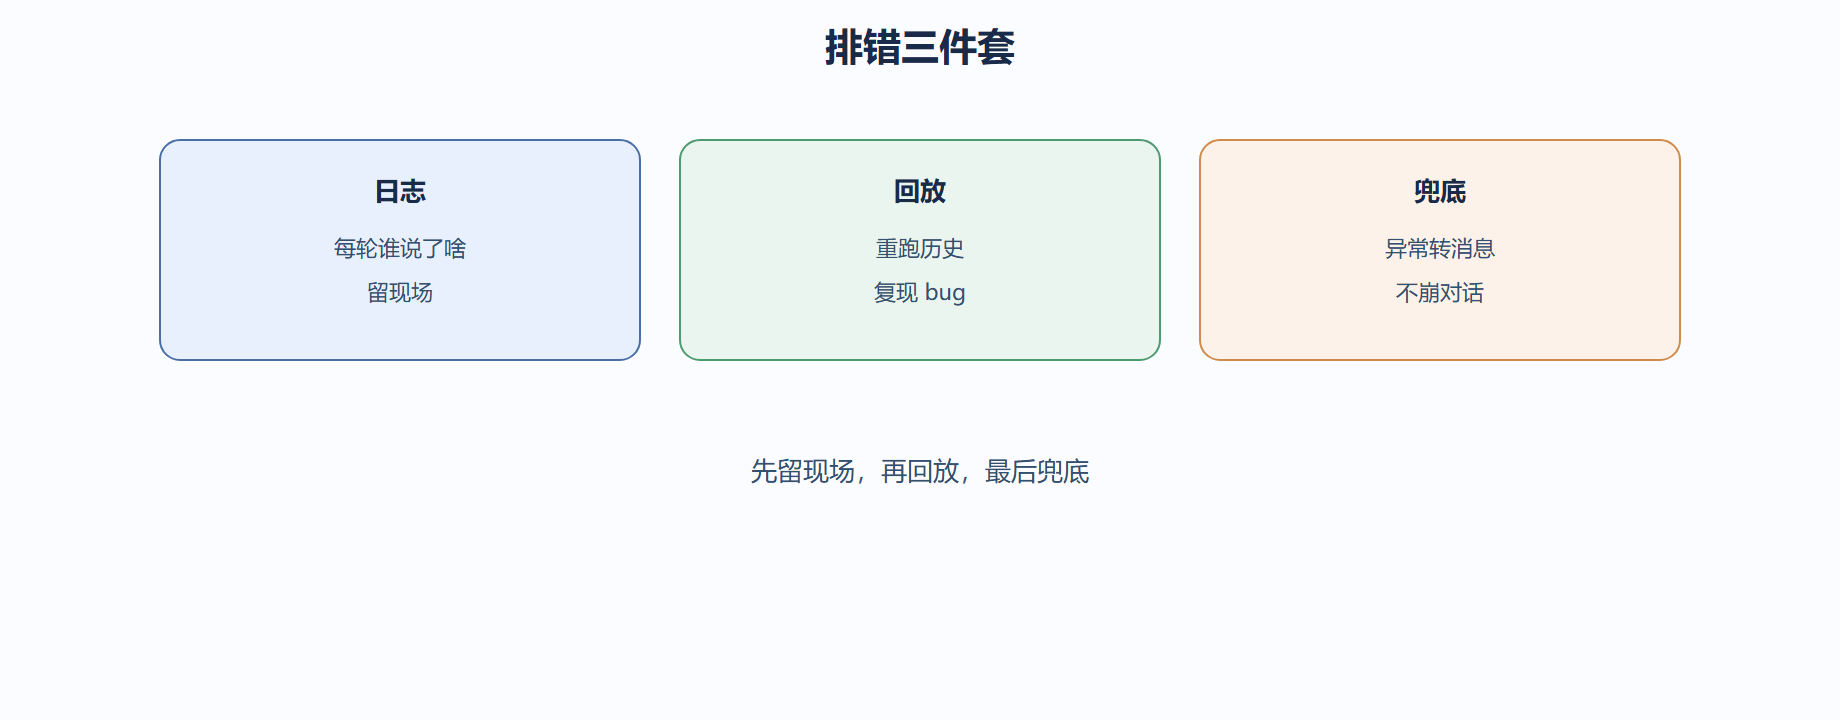
日志:把每一轮记下来
用 register_reply 或框架的日志钩子,把每轮发送者、内容、耗时写进结构化日志。出问题时按"哪一轮由谁发出奇怪内容"定位,比盲猜快十倍。
from autogen import ConversableAgent import os, time cfg = {"model": "gpt-4o-mini", "api_key": os.environ.get("OPENAI_API_KEY")} agent = ConversableAgent("a", llm_config=cfg, system_message="你答。") def log_reply(recipient, messages, sender, config): t = time.strftime("%H:%M:%S") print(f"[{t}] {sender.name} -> {recipient.name}: {str(messages[-1].get('content',''))[:40]}") return False, None agent.register_reply(trigger=ConversableAgent, reply_func=log_reply, position=0)
回放:用历史复现
消息是普通字典(见 2.3),所以你能把一段历史存盘,之后重发给 Agent 复现问题,而不用重新跑整条链路。这是多智能体调试独有的便利。
import json # 存历史 with open("chat_history.json", "w") as f: json.dump(chat.messages, f, ensure_ascii=False) # 复现:把历史读回,从某轮起继续 with open("chat_history.json") as f: history = json.load(f) # 直接拿 history 做输入,定位某一轮为什么歪
异常兜底:让对话不崩
函数执行抛异常(见 3.3)时,别让它中断整个对话。在工具里 try/except 把异常转成字符串返回,对话能继续,你也能从返回里看到错误。
def safe_query(sql: str) -> str: try: # 真实场景执行查询 return "结果: 100 行" except Exception as e: return f"执行失败: {e}" # 转成消息,对话不中断
调试策略顺序
- 先开 ALWAYS(4.5)逐轮看,建立直觉。
- 加结构化日志,定位"哪轮歪"。
- 用回放复现,缩小到具体消息。
- 工具内加兜底,防止偶发异常断流。
为什么是这个排错顺序
前面给的"日志→回放→兜底"顺序不是随意排的,它对应"从粗到细、从观测到干预"的排查逻辑。第一步先看逐轮日志,是为了在不改变系统的前提下建立全局直觉:哪一轮开始歪、是谁说的、说了什么。这步零侵入,先把"病灶大致在哪"圈出来。第二步才上回放——但回放要存历史,属于给系统加一点持久化,所以它排在观测之后:你已经知道"大概第几轮",才值得把那段历史存下来精准复现。第三步工具兜底属于"改造系统防再崩",是治疗措施而非诊断手段,所以放最后:没定位清楚就到处加 try/except,可能把真正错误吞掉,反而更难查。
这里有个关键认知:多智能体系统的 bug 很少是"崩溃",更多是"悄悄答歪"。语法错误你一眼能看到,但"reviewer 这轮没挑出真问题、coder 接着写了错代码"这种软错误,只有把每轮内容摊开看才暴露。所以日志的价值不在"记错误",而在"记正常长什么样"——有了正常基线,偏离才显眼。我们建议哪怕没出 bug,也在开发期常开逐轮日志,把"健康对话长什么样"刻进脑子,等真出事能立刻觉出哪轮不对劲。
| 步骤 | 性质 | 侵入度 | 解决什么 |
|---|---|---|---|
| 逐轮日志 | 观测 | 零(仅打印) | 圈出病灶大致轮次 |
| 历史回放 | 复现 | 低(存盘) | 精准定位某条消息 |
| 工具兜底 | 治疗 | 中(改代码) | 防偶发异常断流 |
日志记哪些字段最有用
前面给的日志只打了"谁对谁说了前 40 字",够定位但不够分析。生产里建议每条日志至少带四个字段:轮次序号、发送者、接收者、内容摘要;再加可选的两项——耗时和是否函数调用。轮次序号让你一眼看出"第几轮开始歪";发送/接收者让你看出"消息流是否按预期路由";耗时能暴露某轮模型特别慢(可能是上下文过长,呼应 5.1);是否函数调用帮你区分"在想"还是"在做"。把这些字段结构化(而非纯打印)写进日志系统,你才能跨多次运行做统计,而不只是看单次。
结构化日志还有个复利:它和 6.4 的监控直接打通。完成率掉时,你回放失败样本用的就是这些带轮次的日志;成本涨时,耗时字段能帮你定位是不是某类对话特别长。所以日志不是"出事才看"的便签,而是监控的数据源。从第一天就按字段规范打日志,后面省的是大量返工接监控的功夫。
本节要点回顾
- 日志按轮记录发送者和内容,定位最快。
- 历史可存盘回放,复现 bug 不重跑全链。
- 工具内 try/except 兜底,对话不崩。
- 排错按观测→复现→治疗,日志建基线才能觉出偏离。
- 日志带轮次/收发/耗时/调用字段,结构化后直接喂监控。
- 调试能力到位,前面各章的机制才真正可维护、可运营。
把调试变成团队习惯
调试不该是出事时某个人临时抱佛脚,而应是一种日常习惯。我们建议团队在开发期强制开逐轮日志,把"健康对话长什么样"作为集体记忆;每周抽一两条失败样本做回放复盘,讨论"哪轮歪、为什么、怎么改提示或角色"。这种复盘积累的是对框架行为的共同直觉,比任何文档都实在。当每个人都见过"模型在某类任务上容易绕弯",下次设计就会提前加约束。调试文化到位,系统的可维护性是复利增长的。
⚠️ 不在工具里捕获异常,一旦执行出错整段对话断掉,且难复现当时上下文。
💡 调试能力是"对话即编排"可维护性的底气——消息即数据,才回得放、定得位。