6.4 性能监控与故障排除策略
6.4 性能监控与故障排除策略
系统上线不代表结束,恰恰相反,真正的功课从监控开始。多智能体系统的故障往往不是崩溃,而是"悄悄变傻"——完成率掉了、成本涨了、某角色开始说胡话。这一节讲该盯哪些指标、怎么定位。
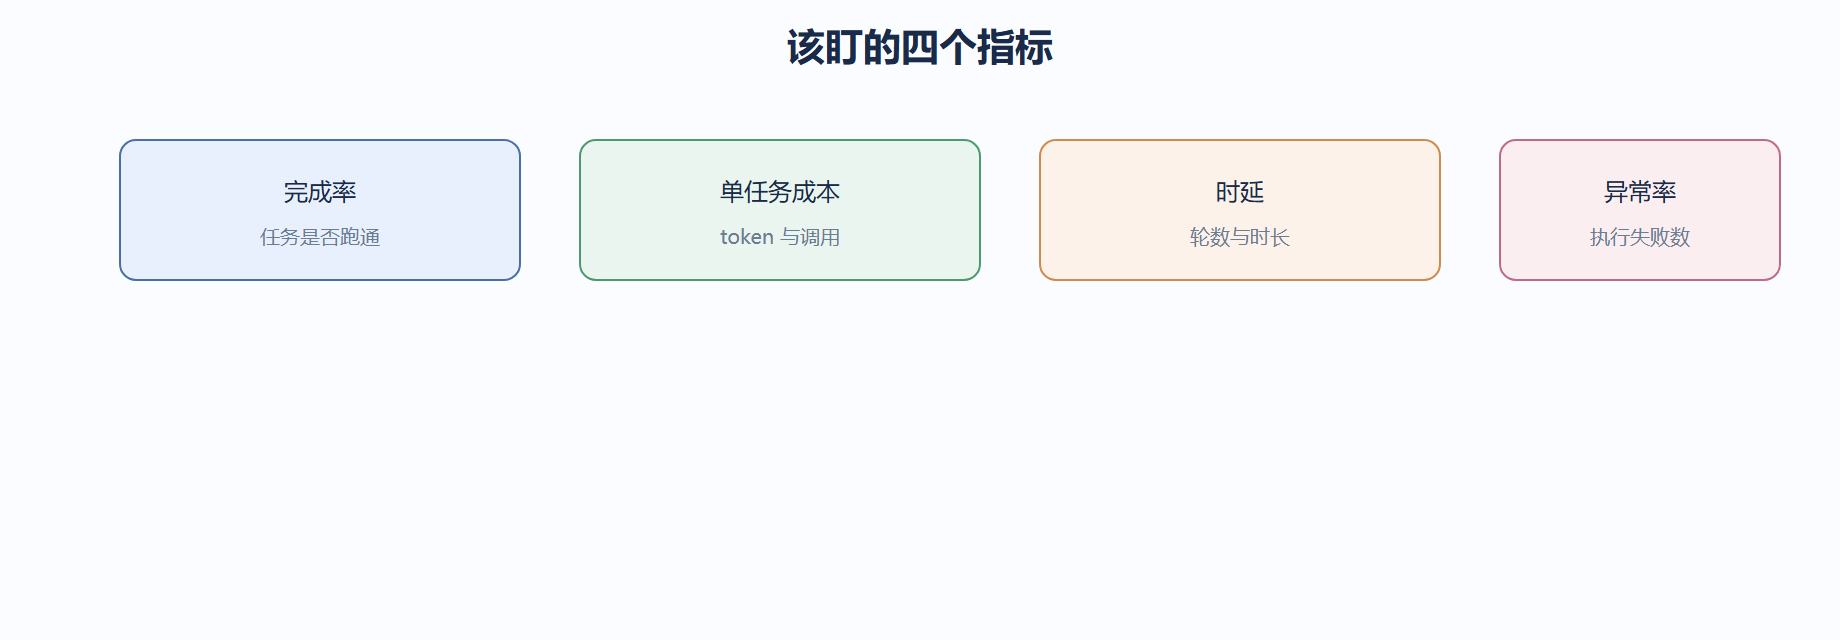
指标一:完成率
用评估 Agent(4.4)给每轮产物打通过/不通过,统计通过率。掉到阈值下就告警。这是最该盯的"健康度"。
指标二:单任务成本
记录每个任务的 token 消耗和模型调用次数。群聊角色多时成本随轮数平方涨(4.2),异常上涨往往是 max_round 没收敛。
# 简易成本记录:每次对话后统计消息数与大致 token def estimate_cost(chat): total = sum(len(str(m.get("content",""))) for m in chat.messages) return f"消息数 {len(chat.messages)},字符约 {total}" # 配合日志(5.3)长期观察趋势
指标三:时延
监控单任务总时长和平均轮数。轮数异常多说明对话没收敛(终止条件问题 4.4);时延突增可能是模型服务限流(5.2)。
指标四:异常率
函数执行失败次数(5.3 兜底返回的"错误"也算)。异常率升,先查外部依赖(5.5)是否抖动,再查模型是否吐了非法参数。
故障排除路径
- 完成率掉 → 取失败样本回放(5.3)看哪轮歪。
- 成本涨 → 查 max_round 是否收敛、角色是否过多。
- 时延高 → 查限流和并发设置(5.1/5.2)。
- 异常多 → 查外部服务和函数参数校验。
一个成本与异常的记录示例
把每次对话的轮数、字符量、异常数记下来,长期观察趋势。异常数突然涨,先查外部依赖。
def record_metrics(chat, had_error: bool): rounds = len(chat.messages) chars = sum(len(str(m.get("content",""))) for m in chat.messages) status = "ERR" if had_error else "OK" print(f"[{status}] 轮数={rounds} 字符≈{chars}") # 真实场景写入时序数据库,配告警阈值 # 配合 5.3 的日志,能同时看"哪轮歪"和"整体成本涨没涨"
定位路径的优先级
我们建议按"完成率→成本→时延→异常"的顺序查。因为完成率掉最直接反映"系统是不是还干活",优先确认健康度;成本涨往往指向群聊不收敛;时延高指向限流;异常多指向外部服务。这个顺序能让你最快定位大类,再下钻。
监控带来的复利
监控不只是"出问题再看",积累的指标趋势能指导架构演进——比如发现某类任务长期高成本,就值得单独优化那个 Agent 而非整体。数据驱动迭代,是多智能体系统从"能跑"到"好用"的分水岭。
阈值怎么设、告警怎么发
光采集指标不够,得有"什么算异常"的判断,否则数据只是曲线。我们给一条设阈值的经验:先积累一到两周的健康期数据,取各指标的常态区间作基线,再在基线外留出合理余量设告警线。比如完成率平时 95%,告警线可设 90%,掉到 90% 以下说明有系统性退化,而非偶发波动;成本常态每任务 N token,告警线设 1.5N,突增往往指向群聊不收敛(4.4 的 max_round 没生效)。阈值太紧会告警疲劳、太松会漏真问题,所以基线必须来自你自己的系统,不能抄别人的数。
告警发出后怎么行动,也要和前面章节打通。完成率掉 → 取失败样本回放(5.3)看哪轮歪,定位是提示问题还是角色边界问题;成本涨 → 查 max_round 和角色数(4.2);时延高 → 查限流和并发(5.1/5.2);异常多 → 查外部依赖(5.5)。这条"指标→大类→下钻"的路径,把第六章的监控和前面各章的能力串成闭环:监控发现问题,前面章节的能力解决问题。
用金融来类比:监控像风控仪表盘,四个指标是四块表盘,阈值是指标红线,越线就触发风控动作。多智能体系统没有"崩溃"这种明显故障,退化是渐进的,所以仪表盘比"等系统挂了再救"靠谱得多。
| 指标 | 基线来源 | 告警线建议 | 异动常指 |
|---|---|---|---|
| 完成率 | 健康期均值 | 均值下移 5 点 | 提示/角色边界问题 |
| 成本 | 健康期每任务 token | 1.5 倍 | 群聊不收敛 |
| 时延 | 健康期总时长 | 2 倍 | 限流/并发错配 |
| 异常率 | 健康期失败数 | 非零持续 | 外部依赖抖动 |
监控数据怎么反哺架构
监控不是"出了问题才看"的救火工具,积累的指标趋势本身就是架构演进的指南。举几个常见信号。信号一:某类任务长期高成本但完成率正常——说明它在烧钱但不出错,值得单独优化那个 Agent 的提示或更换更便宜的模型(2.2),而不是整体动刀。信号二:某角色频繁成为"歪的那一轮"的发送者——说明这个角色的职责定义或提示有问题,单独改它比加新角色有效。信号三:异常率随时间缓慢上升——往往不是代码退化,而是外部依赖(5.5)在悄悄变慢或改接口,该去查服务侧而非改 Agent。
这种"数据驱动迭代"把第六章的监控和前面各章打通:监控发现问题大类,对应章节的能力去解决。系统不是一次设计完美,而是靠长期指标喂养慢慢长对的。我们强调"系统是养出来的",养的饲料就是这些监控数据。没有监控,迭代就是盲调;有了监控,每次改动都有依据、可验证、能回滚。
本节要点回顾
- 四指标:完成率、成本、时延、异常率。
- 故障按指标分层定位,回放是利器。
- 群聊不收敛是成本/时延异动最常见根因。
- 阈值来自自身基线,告警按"指标→大类→下钻"闭环处理。
- 监控趋势反哺架构:高成本单优化、常歪角色单独改、异常升查服务。
- 没有监控的迭代是盲调,有监控的迭代才叫养系统。
避免告警疲劳
阈值设得太紧,系统轻微波动就狂报,团队会习惯性忽略告警,真出事反而漏看——这就是告警疲劳。解法是对告警分级:提示级(趋势异常、留意即可)和事故级(明确越线、必须响应)分开通道,事故级才触发即时通知。提示级汇总进日报,由人抽空看。分级让团队把注意力留给真正的问题,监控才可持续运转。
⚠️ 只盯"系统没崩"远远不够,多智能体常是悄悄变傻,必须盯完成率和成本趋势。
💡 监控让"对话即编排"系统可被运营——编排跑起来后,靠数据而不是感觉养它。