3.3 LLM服务集成与凭证配置
3.3 LLM服务集成与凭证配置
凭证这东西,放错地方就是事故
Cognee 抽取三元组要调 LLM,而 LLM 的 API key 是最不该写进代码的东西。这一节讲清凭证该怎么注入、支持哪些服务商、以及多模型怎么切换。
这是第三章第三站,装好了框架,还差"让它能调模型"这把钥匙。钥匙怎么放,决定了安全底线。
用环境变量注入,绝不硬编码
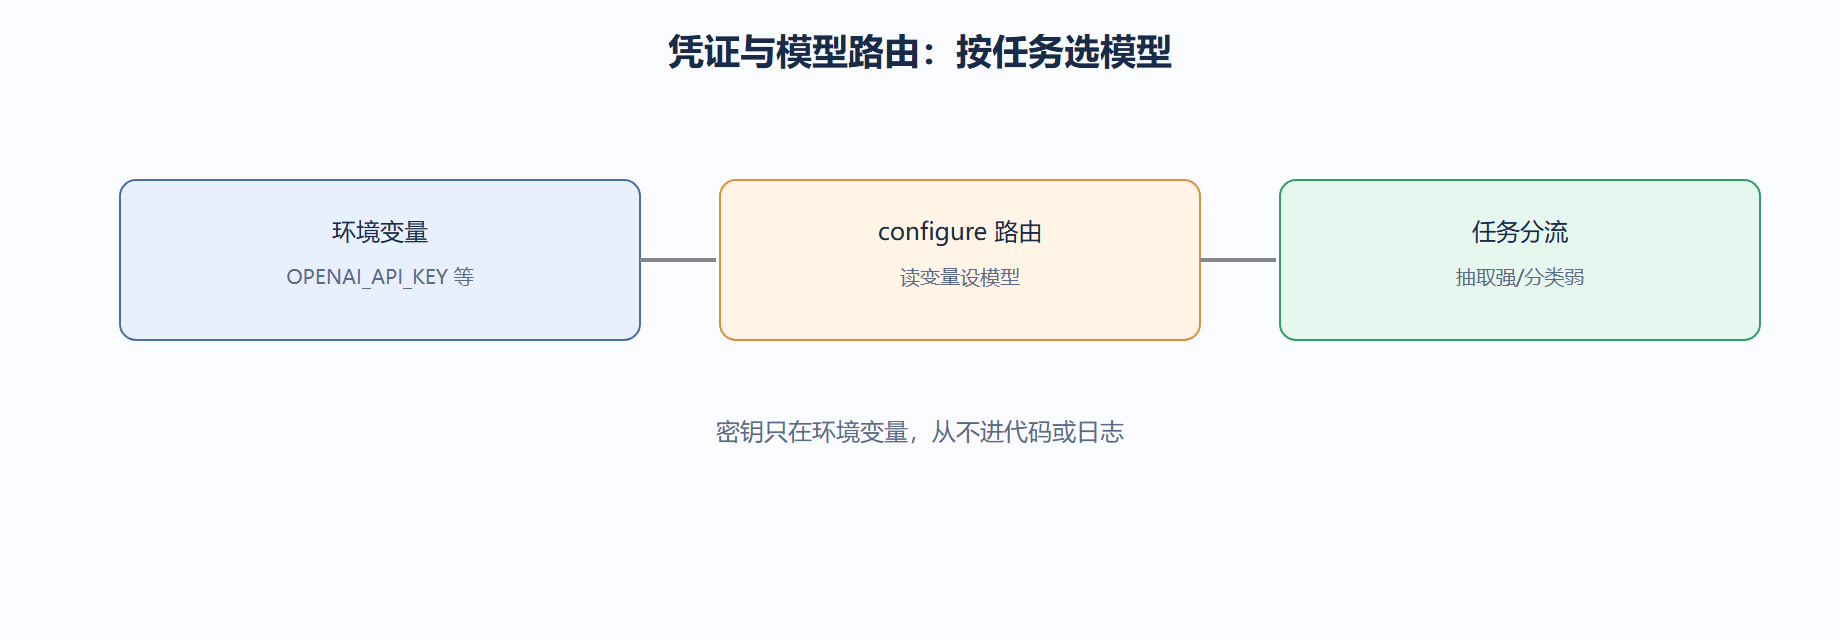
正确做法是通过环境变量把 key 交给 Cognee,代码里只读取变量名。这样代码能安全进仓库,key 留在本地或部署平台的密钥管理里。
# 在终端导出环境变量(临时,仅当前会话) export OPENAI_API_KEY="sk-你的密钥" export LLM_PROVIDER="openai" # LLM_PROVIDER=openai
# 代码里只读取变量,不写死密钥 import os from cognee import configure configure( llm_provider=os.getenv("LLM_PROVIDER", "openai"), api_key=os.getenv("OPENAI_API_KEY"), ) print("模型提供方:", os.getenv("LLM_PROVIDER")) # 模型提供方: openai
注意 configure 在导入 cognee 后调用,把凭证和运行参数设进去。真正项目里,.env 应加进 .gitignore,并在部署平台配置同名环境变量。
多服务商与多模型切换
Cognee 不绑定某一家 LLM。你可以按任务换模型:抽取用强模型保质量,简单分类用便宜模型省钱。下面示意双模型配置(思想代码)。
# 按任务切换模型(示意) import os from cognee import configure # 抽取任务:用强模型保质量 configure(llm_model="gpt-4o", api_key=os.getenv("OPENAI_API_KEY")) # 简单分类任务:换小模型省钱(若支持) configure(llm_model="gpt-4o-mini", api_key=os.getenv("OPENAI_API_KEY")) # ... 执行轻量任务 ...
工程取舍很清楚:抽取决定图谱质量上限,值得用强模型;而建图后的简单检索路由不必每次都调大模型。把钱花在刀刃上。
图数据库凭证同样要走环境变量
除了 LLM key,图数据库(如 Neo4j)的连接串也别硬编码。统一从环境变量读,部署时由平台注入。
export GRAPH_DATABASE_URL="bolt://localhost:7687" export GRAPH_USER="neo4j" export GRAPH_PASSWORD="你的密码"
案例:团队协作的密钥管理
背景:三人小组共用一个 Cognee 项目,但每个人不应把 key 提交到仓库。
操作:用 .env + .gitignore 隔离。
# 代码统一读变量 import os from cognee import configure configure(api_key=os.getenv("OPENAI_API_KEY")) print("就绪" if os.getenv("OPENAI_API_KEY") else "缺少密钥") # 就绪
结果:仓库里只有代码没有密钥,新人 clone 后填自己的 .env 即可,互不干扰。
解读:密钥管理的原则就一条——代码可公开,密钥不可公开。环境变量是实现这条原则最轻的方式。
变式:上生产后,.env 换成部署平台的密钥管理服务(如云厂商的 Secret 功能),原理不变:代码读变量名,值由环境给。
一个多模型策略:抽取与生成分开选
凭证配置不只是"把 key 填上"。实务里建议抽取和最终生成用不同模型:抽取要稳准、可用强模型;生成回答可用 cheaper 模型。两者通过配置分离,互不绑架。类比到交通——货车和客车走不同车道,各按各的限速,整体效率最高。
# 抽取与生成用不同模型(示意) import cognee, os cognee.configure( llm_provider="openai", llm_model="gpt-4o", # 抽取:强模型保三元组质量 api_key=os.getenv("OPENAI_API_KEY"), ) # 生成回答可用另一配置,控制成本(详见第五章性能)
这样抽取质量不被成本压力拖累,生成侧又能按量调便宜模型。
| 用途 | 模型取向 | 理由 |
|---|---|---|
| 三元组抽取 | 强、准 | 错一条边污染全图 |
| 答案生成 | 性价比 | 错可兜底,成本敏感 |
⚠️ 别把 API key 写进笔记本或提交到代码仓库——哪怕私有仓库,泄露一次就是事故。
💡 多服务商切换用环境变量隔离:一套代码,换 OPENAI_API_KEY / 本地模型地址即可切提供方,不改业务。
一个容灾:主备模型切换
生产里 LLM 服务可能抖动。建议在配置里预备备模型,主模型限流或故障时切备,建图不中断。类比到交通——主干道施工就走辅路,总比全堵死强。切换是配置级动作,不必改业务代码。
| 角色 | 用途 |
|---|---|
| 主模型 | 日常抽取 |
| 备模型 | 主故障兜底 |
⚠️ 备模型别和主模型同一提供方同区域——它挂你也挂,容灾变摆设。
💡 切换逻辑加自动探测:连续失败 N 次自动切备,恢复后切回,人工少救火。
一个边界:本地模型也是选项
不是所有场景都要云端 LLM。涉密数据可在本地模型跑抽取,凭证问题转化为算力问题。Cognee 配置切 provider 即可,业务代码不变。
⚠️ 别默认"上云最快"——涉密场景本地模型虽慢但合规,安全红线不能让位便利。
💡 抽选用本地还是云端,按数据敏感度分:公开的用云端快,机密的走本地。
本节要点回顾
- 密钥通过环境变量注入,绝不写进代码或提交仓库。
- Cognee 支持多服务商,可按任务切换模型省成本。
- 图库连接串同样走环境变量,统一隔离。
⚠️ 一旦把 API key 提交进 git,立刻作废并轮换。历史提交里的密钥也能被爬取。
💡 项目初始化就把 .env 加进 .gitignore,比事后补救省心得多。