4.1 数据摄取与处理
4.1 数据摄取与处理
能吃什么,决定了图谱的胃口
建图之前先得有料。add 是 Cognee 统一的摄入入口,但它背后对不同来源做了不同处理:PDF 要解析版面,网页要剥掉导航,数据库要转成记录。这一节把"能吃进什么"讲透,你才知道自己的数据该怎么喂。
这是第四章第一站,对应全册闭环里的"add"那一步,但比第三章的单文本复杂得多。
多源摄入一览
Cognee 的 add 接受文件路径、目录、字符串、乃至结构化记录。下面列出常见来源及处理差异。
| 来源 | 传入方式 | 特殊处理 |
|---|---|---|
| 本地文件 | add("a.pdf") |
按后缀选解析器 |
| 整个目录 | add("./docs") |
递归遍历每种类型 |
| 原始文本 | add("一段文字") |
直接切片 |
| 网页 | add(url) |
剥 DOM 取正文 |
| 结构化记录 | add(json_obj) |
映射为实体 |
代码:把整个知识库目录吃进去
import asyncio, cognee async def ingest(): # 混合来源一次性加入 await cognee.add("./产品手册.pdf") await cognee.add("./团队Wiki") # 目录,递归 await cognee.add("临时备注:本周上线v2接口") # 纯文本 await cognee.cognify() print("摄入完成") asyncio.run(ingest()) # [建图] 节点 540,边 890
注意 cognify 在多次 add 之后统一调用一次即可,它会把队列里所有待处理数据一起建图,比每加一个就建图高效。
摄取时的切片策略
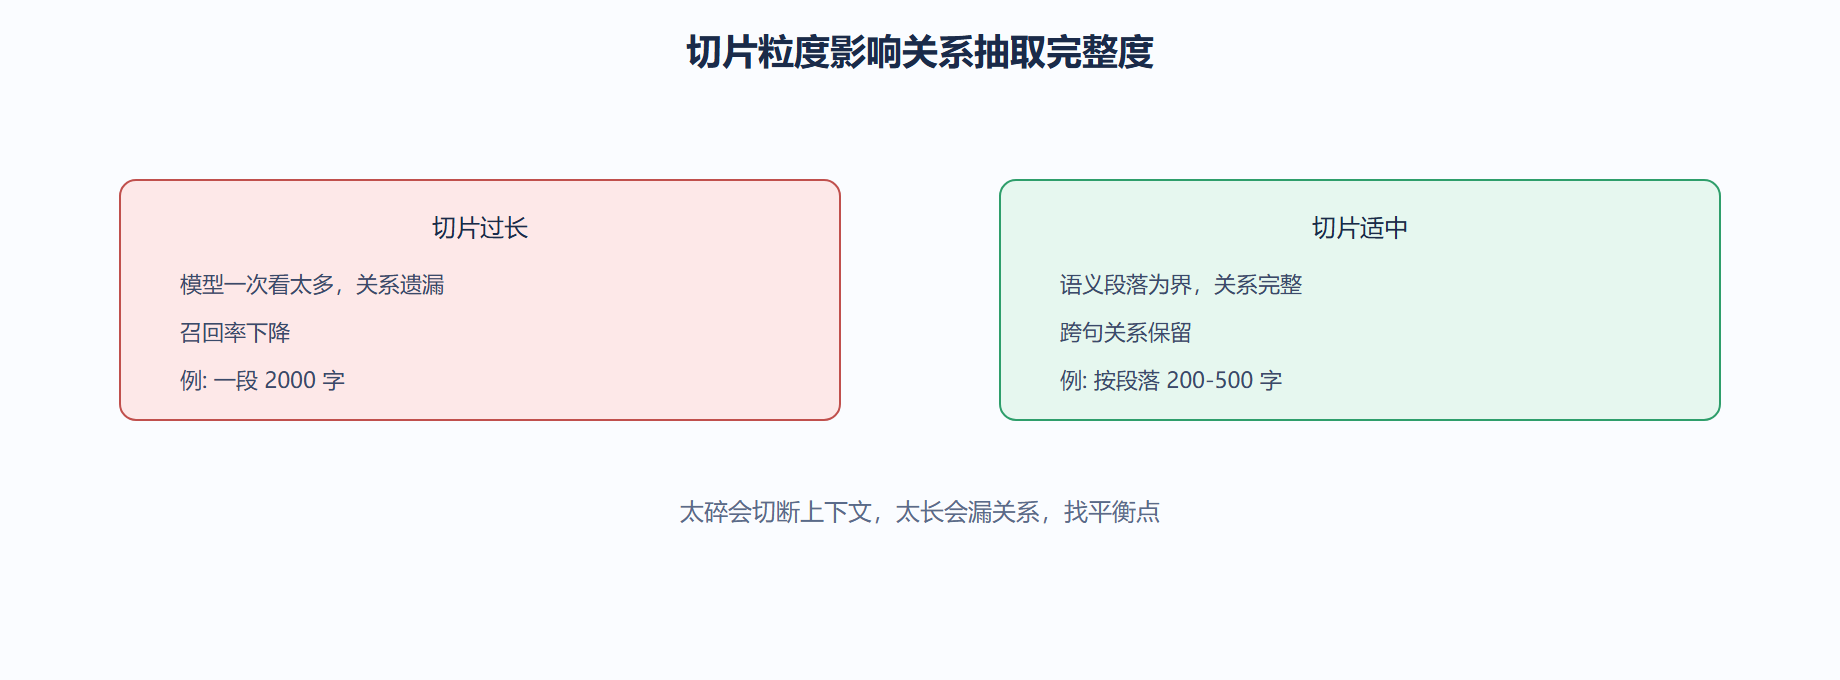
切片影响抽取质量。太长,LLM 容易漏关系;太短,跨句关系被切断。Cognee 默认按语义段落切,但你可配置。下面示意切片粒度对关系抽取的影响。
案例:把客服对话变成可查询记忆
背景:客服团队积累了上万条对话记录,想让新系统能回答"用户对哪类问题投诉最多"。
操作:把对话记录(JSON 数组)批量 add,再建图。
import asyncio, json, cognee records = json.load(open("对话记录.json")) # 每条含 用户问/客服答 async def load_dialogs(): for r in records: # 把每条对话作为一段文本加入 await cognee.add(f"用户问:{r['question']} 客服答:{r['answer']}") await cognee.cognify() ans = await cognee.search("投诉最多的问题类型") print(ans) asyncio.run(load_dialogs()) # 'source':'对话记录.json#row_882'}]
结果:图谱把分散在万条对话里的"退款"相关表述聚成一类,并能指回具体行。
解读:对话数据本是时序流,建图后变成可聚合的关系网。"哪类问题多"这种统计型问题,靠向量检索很难答,靠图上的类型聚合却很自然。
变式:若对话持续产生,把 add 改成流式,每小时增量建图,图谱实时反映最新投诉热点,不需全量重算。
一个预处理技巧:喂之前先洗数据
add 能吞很多格式,但"能吞"不等于"该吞"。扫描件 PDF 抽不出文字、带复杂表格的文档解析错位,都会产噪声。实务里在 add 之前先对源做轻量清洗:拆大文件、补 OCR、过滤页眉页脚。类比到金融数据——入账前先对账,脏数据进了账本就难剔。
# 摄入前先做源清洗(示意) def clean_before_add(path): text = extract_text(path) text = strip_header_footer(text) # 去页眉页脚噪声 text = merge_hyphenation(text) # 修换行断词 return text await add(clean_before_add("年报.pdf")) # 喂干净的文本
干净源进去了,抽取出的三元组才干净,后面检索信噪比才高。
| 源问题 | 影响 | 预处理 |
|---|---|---|
| 扫描件无文字 | 抽不出 | OCR |
| 页眉页脚 | 噪声边 | 剥离 |
| 超大单文件 | 超时 | 切片 |
⚠️ 别把整个 U 盘一股脑 add 进去做"全量建图"——临时文件、二进制都会拖慢且污染,先筛来源。
💡 摄入前按"类型+重要性"分级:核心文档精细抽,边缘文档粗抽或不抽,算力花在刀刃上。
一个元数据技巧:摄入时打来源标签
add 时可顺带记录来源(文件名、批次、时间),这些元数据让每条三元组能指回出处,也便于出问题按来源回查。类比到金融——每笔交易带流水号,对账才能定位到笔。
| 元数据 | 用途 |
|---|---|
| 来源文件 | 出处追溯 |
| 批次号 | 增量管理 |
| 摄入时间 | 时效判断 |
⚠️ 别等图建完才想追溯来源——那时三元组已和原文脱钩,补标签要对回原文本,费数倍力。
💡 摄入流水线统一注入来源元数据,全库一致,后续审计和清理都省力。
一个提醒:摄入是把关口
摄入是图质量的第一个闸门。源干净,后面事半功倍;源脏,抽取再强也救不回。把摄入当质检而非搬运,态度一变,图质就变。
⚠️ 别把 add 当"扔进去就行"——摄入时的预处理决定上限,后面环节只能在其内优化。
💡 给摄入写一份"源准入清单",不符合格式的源先打回清洗,再进 add。
本节要点回顾
add统一入口支持文件、目录、文本、网页、结构化记录。- 多次
add后统一cognify一次更高效。 - 切片粒度影响关系完整度,按语义段落切最稳。
⚠️ 别把整个大文件当一段文本 add。过长切片让 LLM 漏抽关系,图谱先天残缺。
💡 摄取前先抽样看解析结果,确认 PDF 版面、网页正文没被截歪,再批量跑。