4.3 语义搜索与问答系统
4.3 语义搜索与问答系统
search 不是查数据库,是查结构
很多人以为 cognee.search 跟向量库查询一样,丢个问题返回相似片段。其实它背后跑了"向量召回+图遍历+融合"三件事。这一节把它拆开,你才真正摸到"图谱增强 RAG"的脉搏。
这是第四章第三站,也是全册题眼所在。
一次 search 的内部路径
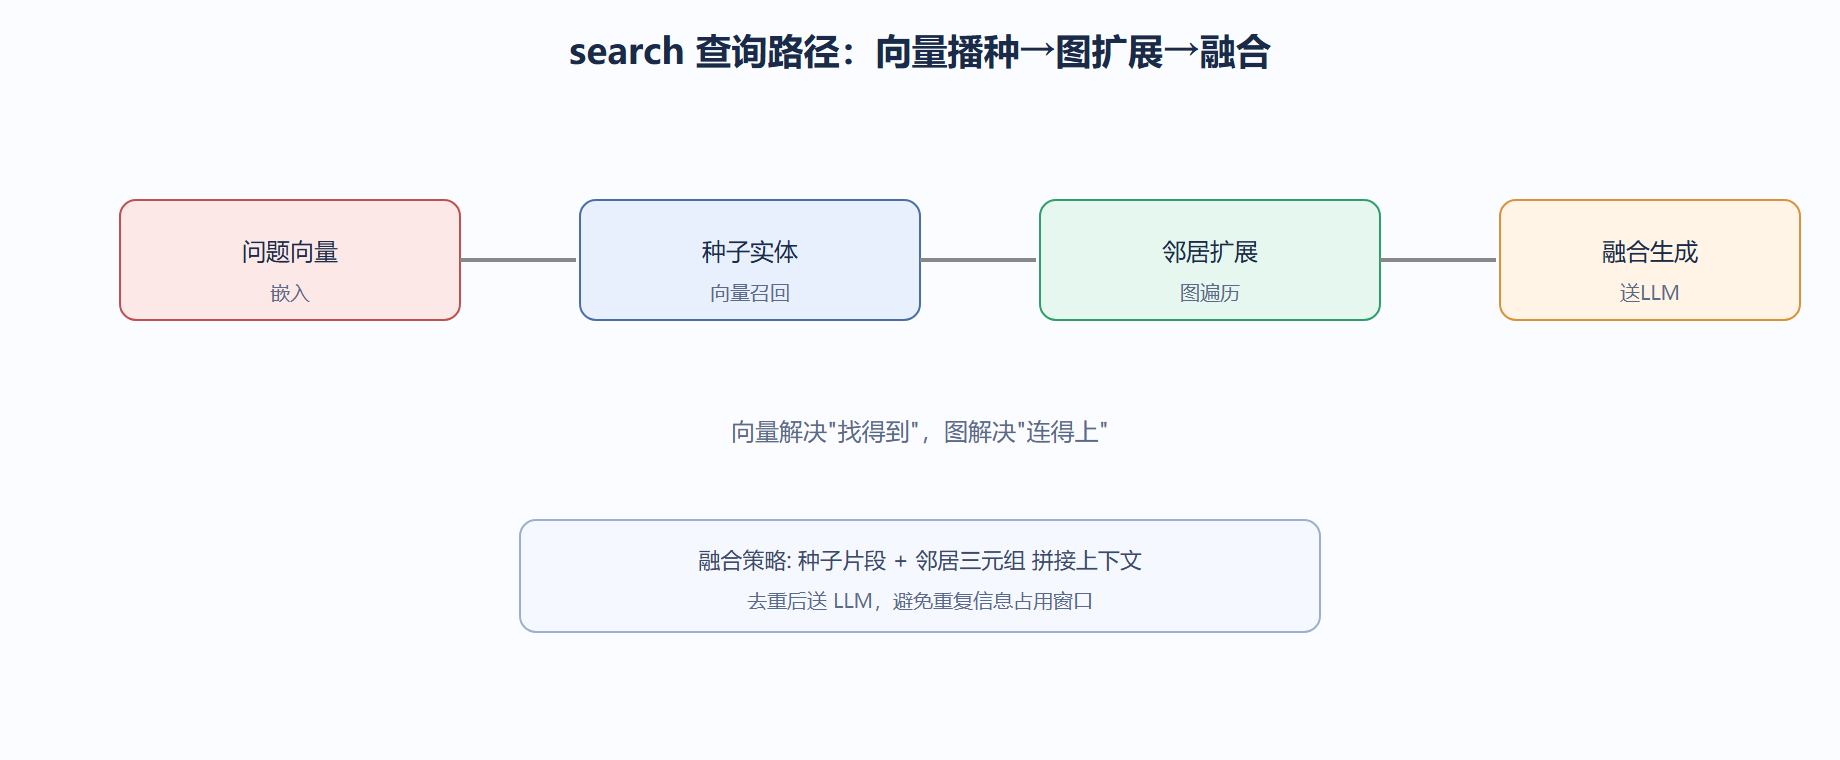
问题先变向量,召回语义相近的实体作为种子;再从种子沿关系走一跳两跳,把邻居拉进上下文;最后把"种子+邻居"一起交给 LLM 生成。下图画出这条查询路径。
代码:带上下文的图谱增强问答
import asyncio, cognee async def qa(): await cognee.add("./产品文档.pdf") await cognee.cognify() # search 返回的是图谱增强后的结果 ans = await cognee.search( "Pro版和Team版的区别是什么", # search_type=" SCHEMA " 可指定图模式检索 ) for a in ans: print(f"{a['entity']} --{a['relation']}--> {a['value']}") print(" 出处:", a.get("source")) asyncio.run(qa()) # 出处: 产品文档.pdf#p5
注意回答不再是"一段相似文字",而是一条条带出处的关系。这正是图谱增强相对纯向量的区别:答案结构化、可核对。
搜索类型的选择
Cognee 的 search 支持不同模式,比如按图 schema 检索、按向量检索、或混合。选错模式会直接影响结果形态:
- 图模式:适合"X 和 Y 什么关系"这类结构化问题。
- 向量模式:适合"哪段讲了某话题"这类语义召回。
- 混合(默认):多数场景够用。
案例:技术文档的多跳问答
背景:一份 SDK 文档,用户问"哪个接口依赖鉴权,鉴权失败返回什么码"。
操作:这是典型两跳,靠图遍历命中。
import asyncio, cognee async def sdk_qa(): await cognee.add("./sdk文档.md") await cognee.cognify() ans = await cognee.search("哪个接口依赖鉴权,失败返回什么") print(ans) asyncio.run(sdk_qa()) # 'source':'sdk文档.md#p8'}]
结果:答案给出完整关系路径,而非两段散落的文字。
解读:纯向量检索会把"上传接口"和"401"两处分别召回,模型得自己连。图谱直接沿"依赖→失败返回"走通,确定性更高,尤其文档长的时候差距明显。
变式:若文档新增"刷新令牌"接口也依赖鉴权,再次 add 后,问"哪些接口依赖鉴权"会返回多个,图谱把同类关系聚合,无需改查询。
一个调优点:融合权重决定答案性格
search 把向量召回和图遍历的结果融在一起再送 LLM,融合时两者的权重影响答案"偏语义还是偏关系"。文本语义强的问题("用一段话介绍云图科技")应偏向量;关系明确的问题("云图科技总部在哪")应偏图。Cognee 允许你按问题类型切策略。类比到物理——不同测量用不同传感器权重,混合信号才准。
# 按问题类型选融合侧重(示意) def route(q): if looks_relational(q): # 含"谁/哪/关系"类 return search(q, weight="graph_heavy") return search(q, weight="vector_heavy")
把路由做对,多跳题和摘要题都能各得其所,不会因为单一权重顾此失彼。
| 问题类型 | 侧重 | 原因 |
|---|---|---|
| 关系查询 | 图重 | 答案是边 |
| 语义摘要 | 向量重 | 答案是段落 |
| 混合 | 均衡 | 两者都要 |
⚠️ 别对所有问题无脑用"图重"——纯摘要题图给不出连续文本,强行走图只会召回零散实体。
💡 上线前用一批真实问题标好类型,测路由命中率;路由错了比模型弱更影响体验。
一个评测:用标准问答对盯质量
search 上线不能只看"答得像"。建议准备一组标准问答对(问题+期望实体/路径),定期跑分看命中率。这样检索策略一调,效果涨跌立刻可见,不会悄悄退化。类比到物理实验——每次改装置都重测基准,偏离立刻知道。
| 评测项 | 看什么 |
|---|---|
| 实体命中 | 答出正确实体 |
| 路径命中 | 多跳走对 |
| 出处命中 | 指回原文 |
⚠️ 别用"感觉答得不错"做验收——主观感受会随疲劳漂移,数字才稳。
💡 标准问答对接进 CI,每次改检索权重自动跑分,回归一目了然。
一个提醒:答案要可解释
search 的卖点不是"答得快",是"答得可解释"。每个答案指回实体与出处,用户能点开核对。这点在金融法务场景是硬需求,生成式炫答反而危险。
⚠️ 别为流畅牺牲可追溯——用户信不信答案,看的是能不能验证,不是文笔多好。
💡 上线时把"出处可点"当验收项,答出不带出处的直接判不合格。
把三元组喂给生成:一个可落地的提示词模板
search 返回的是「实体-关系-实体」三元组,直接拼进提示词往往结构混乱。实践里我们先把三元组渲染成「主语 谓语 宾语,出处」的陈述句列表,再让模型只基于这些句子回答、不发挥。模板骨架:系统提示写「以下是从知识图谱检索到的事实,回答只能引用其中内容,不要自行补充」;用户提示依次列出事实行与问题。这样答案天然贴着图走,幻觉空间被压到最小。多轮对话时,把历史问答作为前缀,图检索只针对最新问题,避免把历史噪声带进检索。
一个过滤手段:按时间与实体圈定候选集
知识库增长后,检索要先「圈范围」再「找答案」。search 支持带过滤条件,例如限定时间窗口或实体类型,把候选集从全库压到某段时间、某类节点。带时间定语的问题(如「2026 年的营收」)不会命中旧事实。上线统计命中率时,带过滤的问题往往明显更高——不是模型变聪明了,是候选集变干净了。
本节要点回顾
search= 向量播种 + 图遍历扩展 + 融合送 LLM。- 结果带
source出处,可核对,非散落片段。 - 图模式适合关系问题,向量模式适合语义召回,混合默认。
⚠️ 别把所有问题都用向量模式查。关系型多跳问题用图模式,命中率和确定性都更高。
💡 调 search 不满意时,先看返回里有没有走到正确的关系边,再决定是否换模型或调提示。