4.5 自定义模块与扩展
4.5 自定义模块与扩展
默认流水线不是终点
Cognee 的默认配置能让 80% 场景跑起来,但剩下 20%——专有领域本体、特殊抽取逻辑、自定义后处理——需要你伸手进流水线。这一节讲清两条扩展路:换抽取模型、加自定义节点。
这是第四章第五站,也是"可编程记忆"的收口。
路一:替换抽取模型
默认抽取用配置里的 LLM。专有领域(如医疗、法律)用通用模型抽不准,可换成领域微调模型或更强模型。
import cognee, os # 换成领域更强的模型做抽取 cognee.configure( llm_provider="openai", llm_model="gpt-4o", # 强模型保抽取质量 api_key=os.getenv("OPENAI_API_KEY"), ) print("抽取模型已切换为", cognee.config.llm_model) # 抽取模型已切换为 gpt-4o
代价是成本上升。实务中常见折中:抽取用强模型,建图后的简单路由用弱模型(见 3.3 节的多模型思路)。
路二:用 GraphPipeline 自定义节点
当需要默认流水线没有的步骤(如抽取后做实体链接、写入前做合规过滤),用 GraphPipeline 自己拼。下面示意一个加"合规过滤"节点的管线。
import asyncio from cognee import GraphPipeline, add, cognify async def custom_pipeline(): pipe = GraphPipeline() # 标准步骤 pipe.add_step("extract", extract_triples) # 抽取 pipe.add_step("filter", compliance_filter) # 自定义:过滤敏感三元组 pipe.add_step("write", write_graph) # 写图 await add("./内部文档.pdf") # 用自定义管线建图 await cognify(pipeline=pipe) def compliance_filter(triples): # 去掉含身份证号等敏感信息的三元组 blocked = {"身份证号", "手机号"} return [t for t in triples if t[1] not in blocked] print("自定义管线建图完成") asyncio.run(custom_pipeline()) # [过滤] 移除敏感三元组 3 条
GraphPipeline 的价值在于可测试:每个节点是独立函数,你能单独跑 extract 看抽得对不对,再单跑 filter 看规则生效没。这比改一整条写死脚本清晰太多。
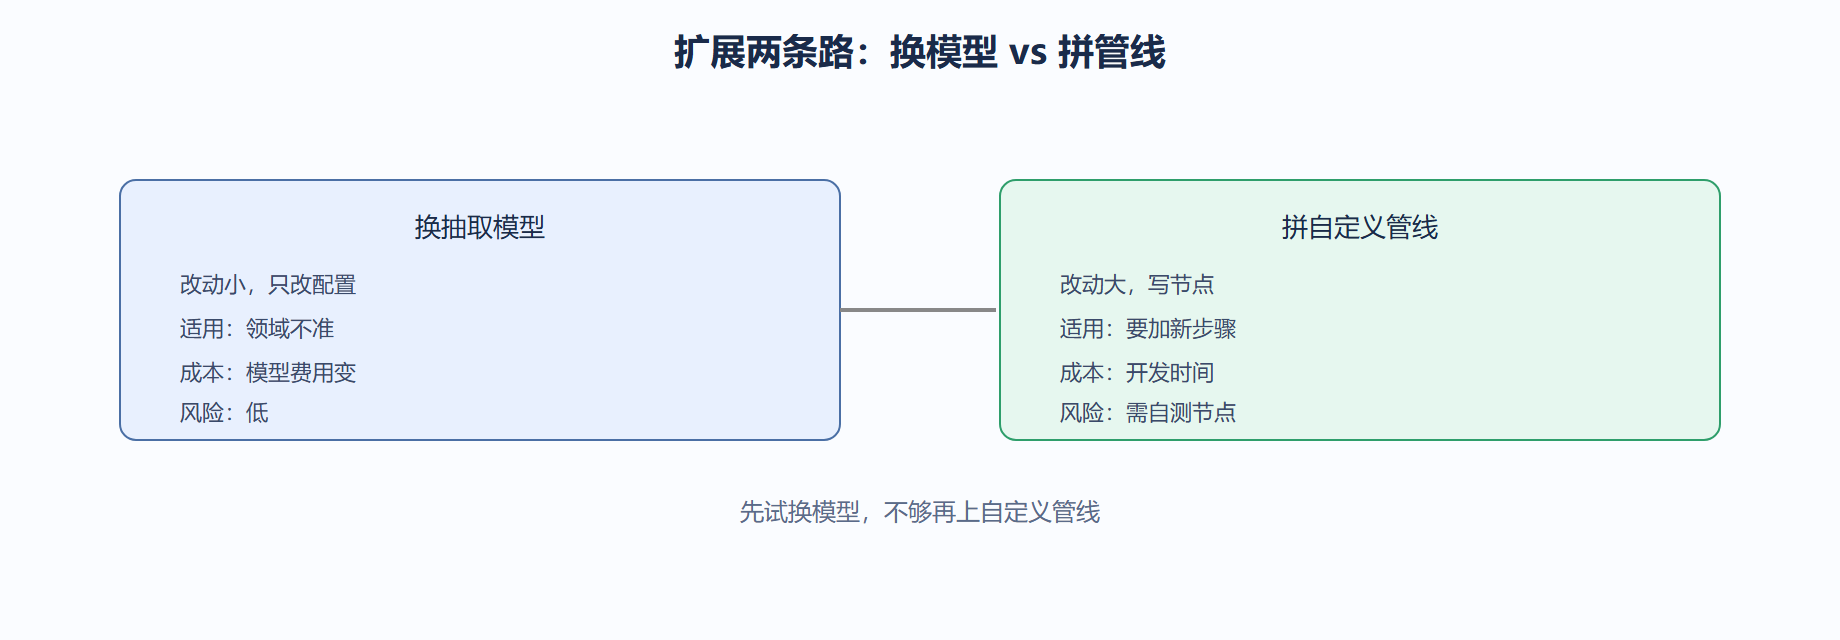
两种扩展方式怎么选
案例:医疗本体的实体链接
背景:一家医院要把病历建图,但通用模型把"糖尿病"和"糖尿病并发症"当两件事,图谱断链。
操作:加一个实体链接节点,把同义表述并到标准术语。
import asyncio from cognee import GraphPipeline, add, cognify SYNONYMS = {"糖尿病并发症": "糖尿病", "DM": "糖尿病"} def entity_link(triples): fixed = [] for s, p, o in triples: s = SYNONYMS.get(s, s) o = SYNONYMS.get(o, o) fixed.append((s, p, o)) return fixed async def medical_pipeline(): pipe = GraphPipeline() pipe.add_step("extract", extract_triples) pipe.add_step("link", entity_link) # 自定义:同义归并 pipe.add_step("write", write_graph) await add("./病历样本.pdf") await cognify(pipeline=pipe) print("医疗图谱建完,术语已统一") asyncio.run(medical_pipeline()) # [链接] 归并同义实体 58 处
结果:原先分散的"糖尿病/DM/糖尿病并发症"在图里指向同一节点,多跳查询不再因叫法不同而断。
解读:这种领域适配正是默认流水线做不到的。你不改抽取模型,只加一个轻量后处理节点,就把图谱质量抬了一截。节点的独立可测,也让回归容易。
变式:若术语表变长,把 SYNONYMS 换成查数据库或调一个术语服务,节点逻辑不变,只是数据源换了——这是管线设计的红利。
一个回归风险:自定义越多,升级越痛
伸手进流水线能解决专有需求,但每改一处,未来升级 Cognee 时要确认改动还兼容。自定义节点、抽取模板越多,升级成本越高。类比到建筑改造——你每加一处非标结构,下次整体检修都得为它单独出方案。策略是:自定义尽量收敛成"配置项"而非"改源码",方便随版本迁移。
# 偏好用配置而非改内部(示意) cognee.configure( extractor_prompt=CUSTOM_PROMPT, # 自定义抽取向配置走 ontology=ONTOLOGY, # 本体作为数据传入 ) # 升级时只需核对配置字段,不碰框架源码
把扩展外置成配置,升级时能快速比对"我的配置在新版还支持吗"。
| 扩展方式 | 升级成本 | 建议 |
|---|---|---|
| 配置项 | 低 | 首选 |
| 子类继承 | 中 | 可控时用 |
| 改源码 | 高 | 尽量避免 |
⚠️ 别为了省事 fork 整个框架改——你从此背上维护一个分支的债,上游修复都接不回来。
💡 自定义前先查官方是否已有钩子(hook)或配置点;多数"我要改源码"其实有官方扩展位。
一个分寸:能配置就不代码
前文讲扩展两条路。补一句分寸:优先用配置(提示词、本体、模型选型)解决,实在不行再写代码自定义节点。配置改动成本低、升级友好,代码改动相反。
⚠️ 别一上来就写自定义节点——多数需求官方配置已覆盖,先翻文档再动手。
💡 自定义前在团队频道问一句"谁做过类似扩展",常有现成配置可复用。
本节要点回顾
- 扩展两条路:换抽取模型(改配置)、拼 GraphPipeline(写节点)。
- 自定义节点独立可测,比写死脚本易维护。
- 领域适配常靠轻量后处理节点,而非换整套模型。
⚠️ 自定义管线节点出错不会自动回滚整图。每个节点先单独跑通,再串进管线。
💡 扩展优先级:先换模型看够不够,不够再上 GraphPipeline,别一上来就重写管线。