5.1 性能调优与资源管理
5.1 性能调优与资源管理
慢在哪里,钱花在哪
Cognee 的性能瓶颈高度集中:建图时的 LLM 调用最慢最贵,图库写入和向量索引次之,查询通常很快。这一节教你把钱和算力花在刀刃上,而不是盲目堆机器。
这是第五章第一站,对应生产化的第一道门槛——成本与速度。
三处可调的旋钮
| 环节 | 瓶颈 | 调法 |
|---|---|---|
| 抽取 | LLM 调用 | 并发+限速、换小模型 |
| 写图 | 图库吞吐 | 批量写入、调连接池 |
| 索引 | 向量计算 | 增量索引、降维度 |
并发与限速的代码调法
第二章提过信号量,这里给出具体配置思路:按你的 LLM 配额设并发上限,避免触发限流导致整批失败。
import asyncio, cognee # 假设你的 LLM 配额是每分钟 60 次 SEM = asyncio.Semaphore(5) # 并发 5 RPM = 60 async def bounded_extract(seg): async with SEM: return await cognee._llm_call(seg) # 示意底层调用 # 启动 1000 段,受信号量约束不会瞬间打满 segs = [f"段{i}" for i in range(1000)] await asyncio.gather(*[bounded_extract(s) for s in segs]) print("抽取在限速下平稳完成,未触发限流") # 抽取在限速下平稳完成,未触发限流
工程取舍:并发开太高被限流,整批失败重来更慢;开太低跑半天。经验值是先取配额 RPM 的 1/10 作为并发,再压测微调。
内存与批量的平衡
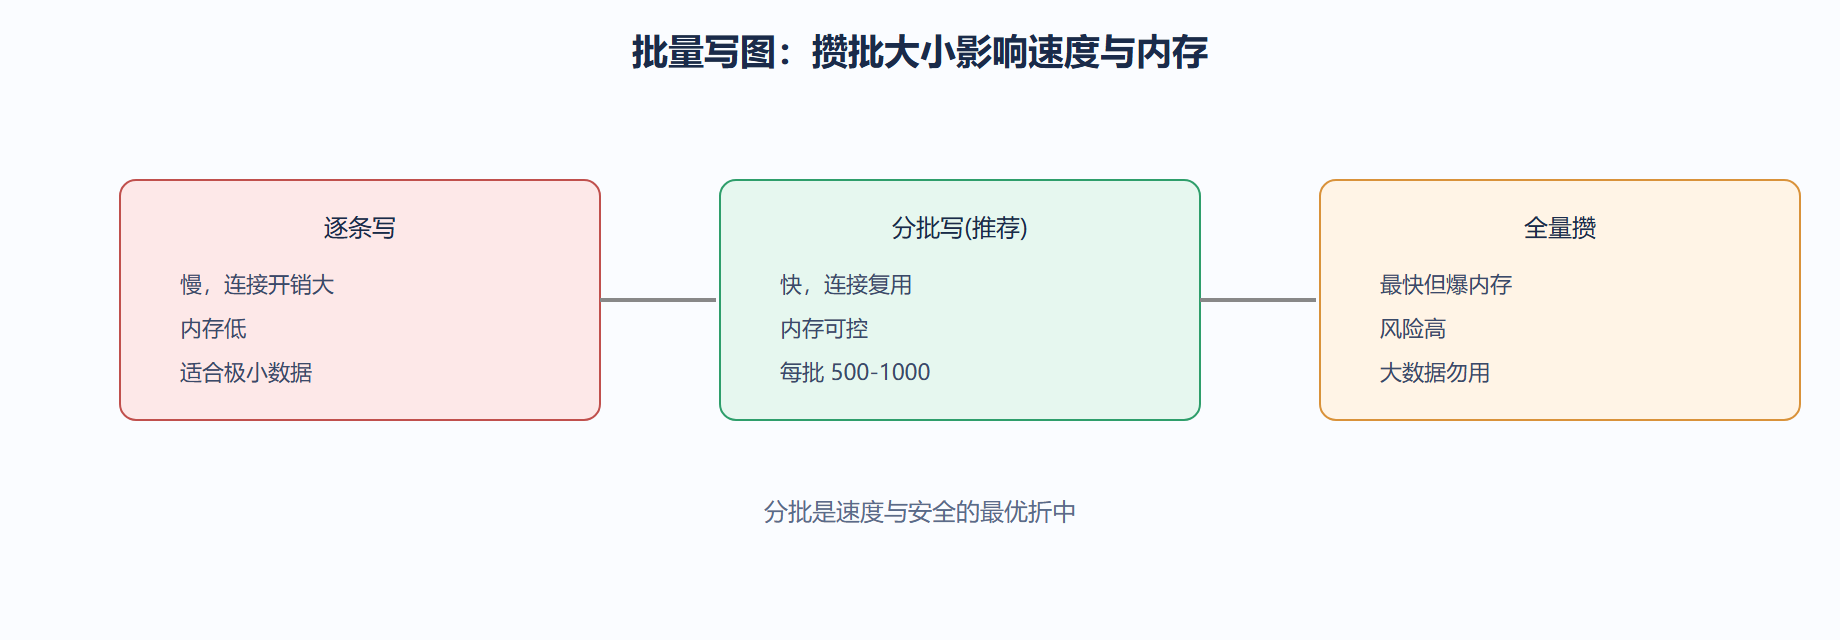
建图时在内存里攒一批三元组再批量写图,比一条条写快得多。但攒太多会撑爆内存。下面示意分批写图的思想。
案例:百万文档的成本估算
背景:某平台要建千万级文档的图谱,需预估 LLM 花费。
操作:先小批测单文档抽取成本,再线性外推。
import time, cognee async def bench(): t0 = time.time() await cognee.add("./样本100篇") await cognee.cognify() dt = time.time() - t0 # 假设 100 篇耗时 120 秒,调用 LLM 约 300 次 per_doc = dt / 100 print(f"单篇约 {per_doc:.1f}s,千万篇预估 {per_doc*1e7/3600:.0f} 小时(单并发)") # 单篇约 1.2s,千万篇预估 33333 小时(单并发) asyncio.run(bench())
结果:单并发要三万多小时,显然要并发+分布式。结论推动团队上队列+多 worker。
解读:性能调优的第一步永远是测量,不是猜。小批基准测试能把"大概很慢"变成"确切要三万小时",从而有理有据地申请资源。
变式:若文档大量重复(如模板合同),建图前先做去重哈希,跳过已处理内容,实际调用量可能砍掉一半,成本随之折半。
一个成本误区:用强模型抽全部文本
前文说抽取是瓶颈。新手常把"强模型"无差别铺到所有文本,结果账单爆炸。正确做法是按内容价值分级:核心文档用强模型抽,边缘或低价值文本用便宜模型甚至跳过。类比到金融风控——大额交易人工审,小额自动过,资源按风险分配。
# 按价值分级选模型(示意) def pick_model(text, important): return "gpt-4o" if important else "gpt-4o-mini" for doc in docs: cognee.configure(llm_model=pick_model(doc.text, doc.important)) await cognify_one(doc)
这样核心知识保质量,长尾控成本,整体账单能降一个量级而不伤主力问答。
| 文本价值 | 模型 | 目标 |
|---|---|---|
| 高(核心) | 强 | 抽准 |
| 中 | 中 | 平衡 |
| 低(边缘) | 弱/跳过 | 控本 |
⚠️ 别为"统一简单"全用最便宜模型——低价值文本省了钱,但核心文档抽错边,主力问答先崩。
💡 性能调优先看"钱花在哪":跑一次建图统计各文档的 LLM 调用占比,把贵模型集中到占比高的核心文档。
一个缓存:热查询别反复走全链
性能优化不止调抽取,查询侧也能省。高频问题(如"公司总部在哪")结果可缓存,命中直接返回,不必每次都向量+图+LLM 全跑一遍。类比到交通——常走的路设直达车道,不必每次都过所有路口。
| 层 | 可缓存 | 注意 |
|---|---|---|
| 检索结果 | 是 | 图变更要失效 |
| 抽取结果 | 已增量 | 源头去重 |
⚠️ 别缓存不设失效——图一更新,旧缓存返回过时答案,比慢更危险。
💡 缓存键带图版本号,图一变版本号变,缓存自动失效,安全又省心。
一个提醒:先量后优
性能优化第一大忌是凭感觉。先跑一遍建图统计,看时间到底花在抽取、写图还是索引,再针对最慢的那段下手。盲优化往往优化了个不痛不痒的环节。
⚠️ 别一慢就加机器——先确认瓶颈是计算还是 IO,加错资源只是更贵地慢着。
💡 优化前后各测一次同样的批次,用数字证明"真的快了",而非"感觉快了"。
一个对照:时间花在哪决定了优化方向
建图耗时三块:抽取(LLM)、写图(图库)、索引(向量)。哪块最大,优化就从哪块下手。抽取决定的,调并发或换模型;写图慢的,调连接池;索引慢的,降维或增量。对着瓶颈打,才有效。
| 最慢环节 | 调法 |
|---|---|
| 抽取 | 并发+换小模型 |
| 写图 | 批量+连接池 |
| 索引 | 增量+降维 |
⚠️ 别三块一起调——你不知道哪块是瓶颈,调了也分不清谁生效,排障更乱。
💡 调优逐块来:先压抽取,测;再压写图,测;每步有前后对比,效果清晰。
本节要点回顾
- 瓶颈在 LLM 抽取,调法是并发+限速、按需换模型。
- 写图用分批,每批 500-1000 平衡速度与内存。
- 调优前先小批基准测试,把猜测变成数字。
⚠️ 别为提速把并发拉到配额上限。限流惩罚的等待时间往往超过你省下的。
💡 先测单文档成本再外推,比拍脑袋估资源靠谱得多,也更容易要到预算。