5.4 部署策略与生产化
5.4 部署策略与生产化
从脚本到服务,差的不只是部署
本地跑通 Cognee 是一回事,让它稳定地被多个系统调用是另一回事。这一节对比两种部署形态:库内调用(embedded)和独立记忆服务,并讲清各自适用边界。
这是第五章第四站,也是全册生产视角的收口。
两种形态对比
| 形态 | 描述 | 适用 | 代价 |
|---|---|---|---|
| 库内嵌入 | Cognee 作为依赖直接 import | 单应用、调用方少 | 资源与应用耦合 |
| 独立服务 | Cognee 跑成服务,多方可调 | 多系统共享记忆 | 要管服务可用 |
库内嵌入:最快上手
如果你的应用只有一个,直接把 Cognee 当库 import 最简单,没有网络层。
# 应用进程内直接调用(embedded) import cognee async def answer(question): await cognee.add("./知识库") await cognee.cognify() return await cognee.search(question) # 优点:零部署,缺点:记忆和应用同进程,难被别的服务复用
适合原型、单人项目、调用方唯一的场景。代价是记忆和应用绑死,另一团队想用同一份图得自己再建一份。
独立记忆服务:共享与解耦
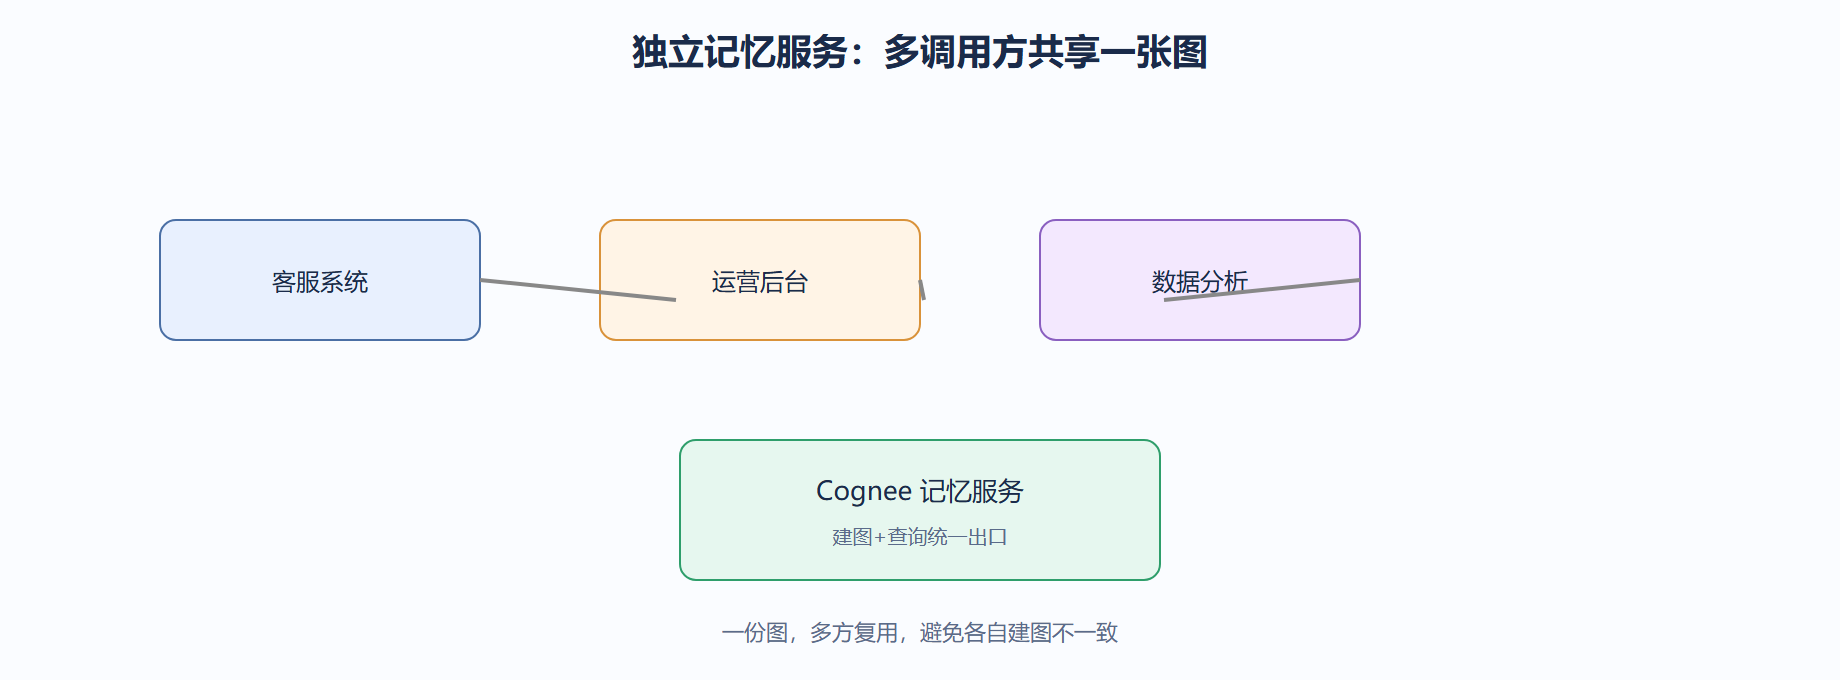
当多个系统都要同一份记忆,把 Cognee 跑成独立服务,通过接口对外提供建图和查询。
# 独立服务示意:用 FastAPI 包一层(伪代码) from fastapi import FastAPI import cognee app = FastAPI() @app.post("/cognify") async def build(payload: dict): await cognee.add(payload["path"]) await cognee.cognify() return {"ok": True} @app.get("/search") async def search(q: str): return await cognee.search(q)
服务化后,客服、运营、分析三套系统调同一个 /search,记忆只有一份,不会出现"客服看到的图和分析看到的不一致"。
部署的伸缩要点
服务化带来新责任:图库要独立部署并备份,服务本身要水平扩容应对并发查询,建图任务建议丢到独立 worker 不占用查询资源。下面示意分工。
# 二者共享同一个图库后端,互不抢资源
工程上这是"读写分离"的思路:查询要低延迟,建图要吃算力,混在一起会互相拖累。
案例:多产品线共享知识图谱
背景:公司三条产品线各有客服,但底层知识同源,不想各建各的图。
操作:建独立 Cognee 服务,三条线都调它。
# 查询时各自 search,但图在同一后端,更新一处全见效
结果:知识更新一次,三条产品线同步受益,运营人力减半。
解读:独立服务的价值在"复用与一致"。若走库内嵌入,三条线各建各的图,更新要发三遍,还容易不一致。当调用方≥2,服务化的收益就盖过它的运维成本。
变式:若某产品线要隔离(如合规要求),可部署第二个服务实例指向独立图库,架构不变,只是物理隔离,灵活度来自"服务"而非"库"。
一个演进路径:从小库到独立服务
两种部署形态不是非此即彼,而是演进关系。单应用先用库内嵌入跑通;当第二个系统也想用同一份记忆,就该把 Cognee 拆成独立服务,避免两份图各长各的、关系对不上。类比到交通——村里先各村自修路,车多了就得修一条连外的主干道,否则村与村不通。
# 服务侧 async def memory_api(query, caller): return await cognee.search(query, scope=caller) # 调用方 A、B 共用同一图,不再各建一份
拆成服务后,图的唯一性保住,多方看到的记忆一致,也不会出现"同一个事实两个图两种说法"。
| 阶段 | 形态 | 触发条件 |
|---|---|---|
| 起步 | 库内嵌入 | 单应用 |
| 增长 | 独立服务 | 多方共享 |
| 规模 | 服务+缓存 | 高并发 |
⚠️ 别在多系统共用记忆时各跑各的 Cognee 实例——图会分叉,关系从此对不齐,比没有记忆还乱。
💡 决定上独立服务的信号:第二个团队来问"能不能也用你们的图"——那一刻就该抽服务了。
一个可用性:独立服务要设健康检查
抽成独立记忆服务后,调用方依赖它存活。务必加健康检查端点(图库连得上、最近一次 cognify 成功),不健康就摘流量。类比到交通——主干道要有状态灯,坏了及时改道,别让车流撞上去。
| 检查项 | 不健康信号 |
|---|---|
| 图库连接 | 连不上 |
| 最近建图 | 超时失败 |
| 查询延迟 | p99 飙 |
⚠️ 别只启服务不监控——服务悄悄半死,调用方拿到空结果还以为自己图空了。
💡 健康检查接告警,挂了自动通知,恢复自动加回,可用性靠机制不靠人盯。
一个提醒:可用性靠设计不靠运气
独立服务上线,可用性来自健康检查、降级、告警这些设计,不是"它平时挺稳"。没设计过故障的服,第一次故障就是事故。
⚠️ 别信"它跑了半年没挂"——没经过故障演练的服务,挂的时候你不知道它怎么挂。
💡 上线前做一次"图库宕机"演练,看系统是否按设计降级,而不是整体崩。
部署形态的决策可以压缩成一张清单:调用方只有一个且都在同一进程内?用库内嵌入,零运维;多个服务都要查图?独立部署,先解决可用性与备份;建图频率低但查询频繁?读写分离,建图用批任务、查询走只读副本;数据量增长快?预留水平扩展路径,避免单实例内存成为天花板。清单之外还有一条铁律:无论哪种形态,都要把"图数据如何备份与恢复"写进运维手册——图谱一旦丢失,重建成本远高于普通数据库。
本节要点回顾
- 库内嵌入适合单调用方,零部署但记忆难共享。
- 独立服务适合多方复用,代价是运维可用性与备份。
- 查询与建图建议读写分离,避免互相拖累。
⚠️ 多系统共用却用库内嵌入,会导致各自建图、数据不一致,迟早踩坑。
💡 判断部署形态看调用方数量:一个用嵌入,两个及以上认真考虑独立服务。