1.3 核心概念解析:Agents, Tasks, Crews, Processes
1.3 核心概念解析:Agents, Tasks, Crews, Processes
本节约处在第一章第三站,也是整本书的词汇表。CrewAI 的全部代码几乎都围绕四个名词转:Agent(谁干)、Task(干什么)、Crew(把谁和什么装一起)、Process(按什么顺序干)。先把这四个讲准,第二章拆组件、第三章写代码才不会卡壳。
从依赖关系看,它们是层层包含:一
从依赖关系看,它们是层层包含:一个 Crew 包着若干 Agent 和若干 Task,Task 通过 agent 字段挂到某个 Agent 上,Process 决定这些 Task 之间怎么排。可以用一张拓扑图固定认知:
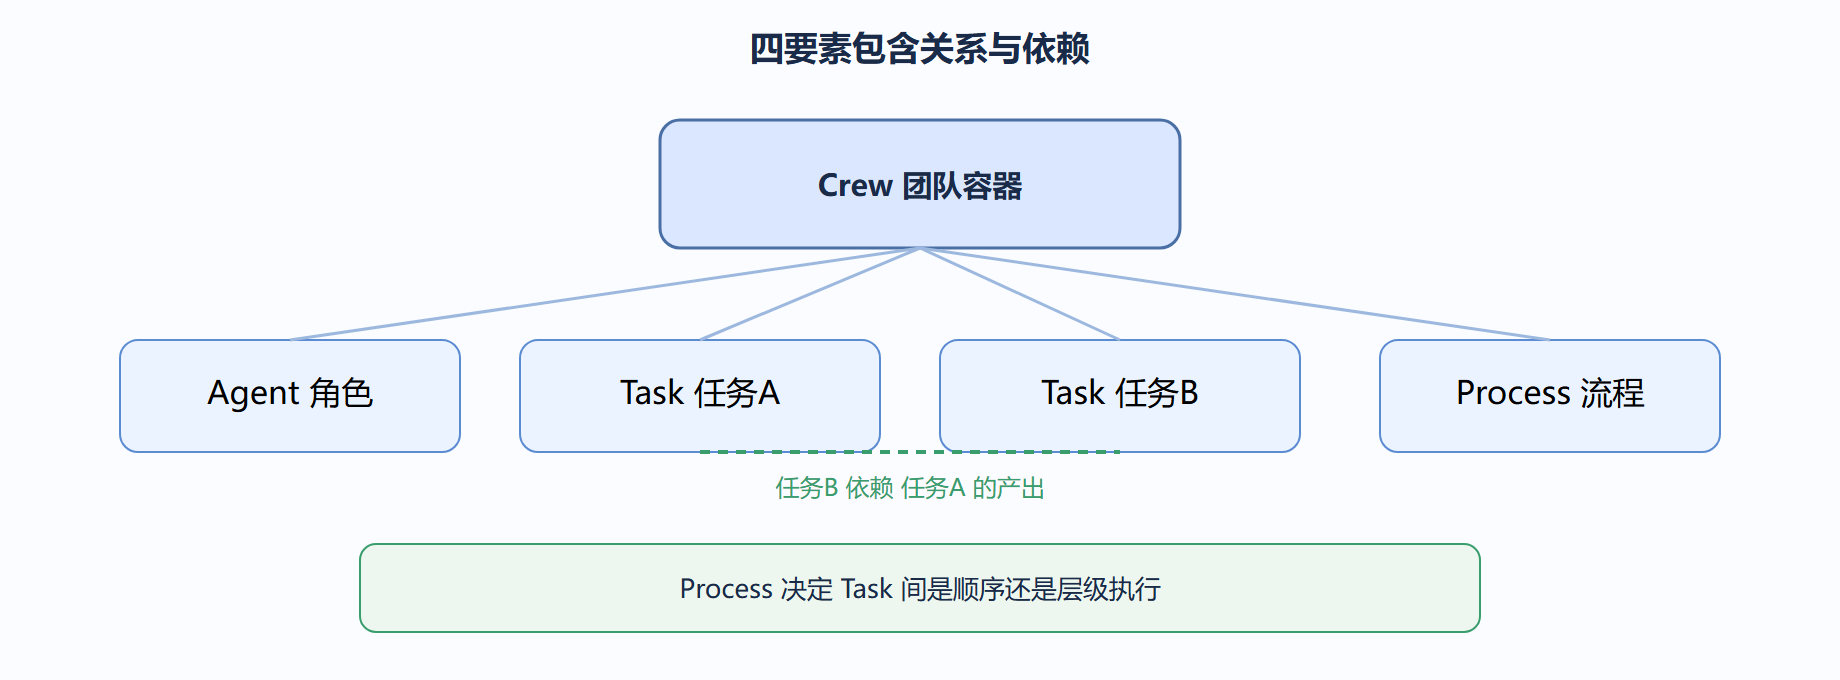
逐个看定义和职责边界:
Agent 是"干活的人"。它不
Agent 是"干活的人"。它不保存任务进度,只携带一段稳定的人格设定(role、goal、backstory)和一组可用工具。同一个 Agent 可以被多个 Task 复用,也可以被 delegation 机制临时拉去帮别人。
Task 是"具体的活"。它描述要做什么(description)、期望产出长什么样(expected_output),并决定由谁做(agent)以及依赖谁的结果(context)。Task 是 CrewAI 里最容易被写糙的地方——描述含糊,模型就自由发挥。
Crew 是"项目组"。它持有 agents 与 tasks 两个列表,再加上 process、verbose、memory 等运行参数。Crew 本身不干活,它负责把成员组织起来并启动 kickoff。
Process 是"协作方式"。目前两种:sequential 让任务按列表顺序串行;hierarchical 引入一个"经理"角色,由它动态派活给成员。选哪个直接决定你的系统是可预测还是更灵活但更贵。
下面用代码把"四要素如何拼起来"演示一遍,重点看 Task 之间如何用 context 建立依赖,以及 Process 怎么影响执行。
from crewai import Agent, Task, Crew, Process # 三个角色,职责互不重叠 planner = Agent(role="选题策划", goal="定一个值得写的题目", backstory="对读者痛点敏感", verbose=True) writer = Agent(role="撰稿", goal="把选题写成初稿", backstory="逻辑清楚,少用套话", verbose=True) editor = Agent(role="编辑", goal="把初稿改到可发", backstory="眼里揉不进事实错误", verbose=True) # 任务一:产出选题 t_plan = Task(description="给技术博客定一个题目", expected_output="一个句子题目", agent=planner) # 任务二:依赖任务一的结果 t_write = Task(description="按选题写八百字初稿", expected_output="初稿全文", agent=writer, context=[t_plan]) # 任务三:依赖任务二 t_edit = Task(description="审校初稿并给出修改版", expected_output="修改版全文", agent=editor, context=[t_write]) crew = Crew( agents=[planner, writer, editor], tasks=[t_plan, t_write, t_edit], process=Process.sequential, # 顺序执行,依赖链清晰 )
运行后你会看到:planner 先产出题目,writer 拿到题目写初稿,editor 拿到初稿改定。整条链的输入输出都是显式的。若把 process 换成 Process.hierarchical,执行权会交给一个隐含的经理 Agent,它自行决定调用顺序——更灵活,但你要多付一次模型调度,且行为更难复现。
另一个容易混淆的点:Agent 的 goal 和 Task 的 description 有什么区别?简单说,goal 是长期人设("你是什么样的人"),description 是当次指令("这次具体做什么")。把本该写进 Task 的约束塞进 Agent 的 backstory,会导致所有任务都被同一段陈词影响,反而降低可控性。我们的做法是:人设只定风格与能力边界,具体验收标准永远写在 Task 的 expected_output 里。
最后强调一个工程现实:四要素里最该被测试的不是 Agent,而是 Task。角色设定差一点,模型还能靠通用能力补;但 Task 的 expected_output 写得虚,下游拿到的就是不可用的半成品,错误会在链里放大。所以写 Crew 时,先花力气把每个 Task 的产出格式定死,再谈角色怎么配。
带着这四个词的定义,下一节我们拿
带着这四个词的定义,下一节我们拿 CrewAI 和 AutoGen、LangChain 摆在一起比,你会看清这些概念在别人家框架里是"被合并了"还是"被换了个名字",选型时就不容易被名词带偏。
四个概念的记忆口诀
记不住四要素关系时,用一句口诀:Agent 是"谁",Task 是"啥",Crew 是"队",Process 是"序"。前两个描述静态能力,后两个描述动态组织。
# 口诀对应到代码对象 mapping = {"谁": "Agent", "啥": "Task", "队": "Crew", "序": "Process"} print(list(mapping.keys())) # ['谁', '啥', '队', '序']
带着这句口诀读后续章节,每个新字段都能挂回这四个槽位之一,不容易迷路。第二章拆组件时,你也会发现每个字段都落在某个槽位上。
两种 Process 怎么选:一张对照表
把 sequential 与 hierarchical 放在同一张表上,差异就清楚了:
| 维度 | sequential | hierarchical |
|---|---|---|
| 调度者 | 无,按列表顺序 | 隐含的经理 Agent |
| 灵活性 | 低,路径写死 | 高,经理可重排任务 |
| 额外成本 | 无 | 多一次经理 LLM 调用 |
| 可复现性 | 强 | 弱(经理决策带随机性) |
| 适用场景 | 步骤固定的流水线 | 依赖需动态判断时 |
⚠️ 常见坑:切到 hierarchical 却不显式给 manager_llm,CrewAI 会试图用默认模型当经理;很多部署里默认模型没配置,直接报找不到 LLM。我们固定写成下面这样:
from crewai import Agent, Task, Crew, Process from crewai.llm import LLM manager = LLM(model="gpt-4o-mini", temperature=0.2) crew = Crew( agents=[researcher, writer], tasks=[t_research, t_write], process=Process.hierarchical, manager_llm=manager, # 必须显式指定,否则经理无模型可用 verbose=True, ) result = crew.kickoff() print(result) # 经理自行决定调用顺序后再汇总
💡 关键直觉:sequential 像一条已经铺好的公交线路,站序固定、便宜、好预测;hierarchical 像一个调度中心,按需派单,贵但能应对临时变化。生产里先用 sequential 把链路跑通,只有当你发现"下一步该谁做"需要模型自己判断时,再升级到 hierarchical。下面把四要素和 Process 选择合起来看一个最小骨架:
from crewai import Agent, Task, Crew, Process a1 = Agent(role="研究员", goal="收集事实", backstory="严谨", verbose=True) a2 = Agent(role="写手", goal="写成报告", backstory="简洁", verbose=True) t1 = Task(description="列出三点事实", expected_output="三条要点", agent=a1) t2 = Task(description="基于事实写报告", expected_output="报告", agent=a2, context=[t1]) crew = Crew(agents=[a1, a2], tasks=[t1, t2], process=Process.sequential) out = crew.kickoff() assert "报告" in str(out)