3.1 定义与配置 Agents
3.1 定义与配置 Agents
本节约处在第三章第一站,动手写第一行构建代码。前两章把 Agent 讲透了,这里把它落成可复用、可组合的对象。一个常见反模式是每次都在 Crew 里临时 new 一个 Agent——配置散落各处,改一处要翻全文。我们主张:Agent 先单独定义、集中管理,再被 Crew 引用。
先把"一个 Agent 从配置到
先把"一个 Agent 从配置到就绪"的状态画出来,建立运行时直觉:
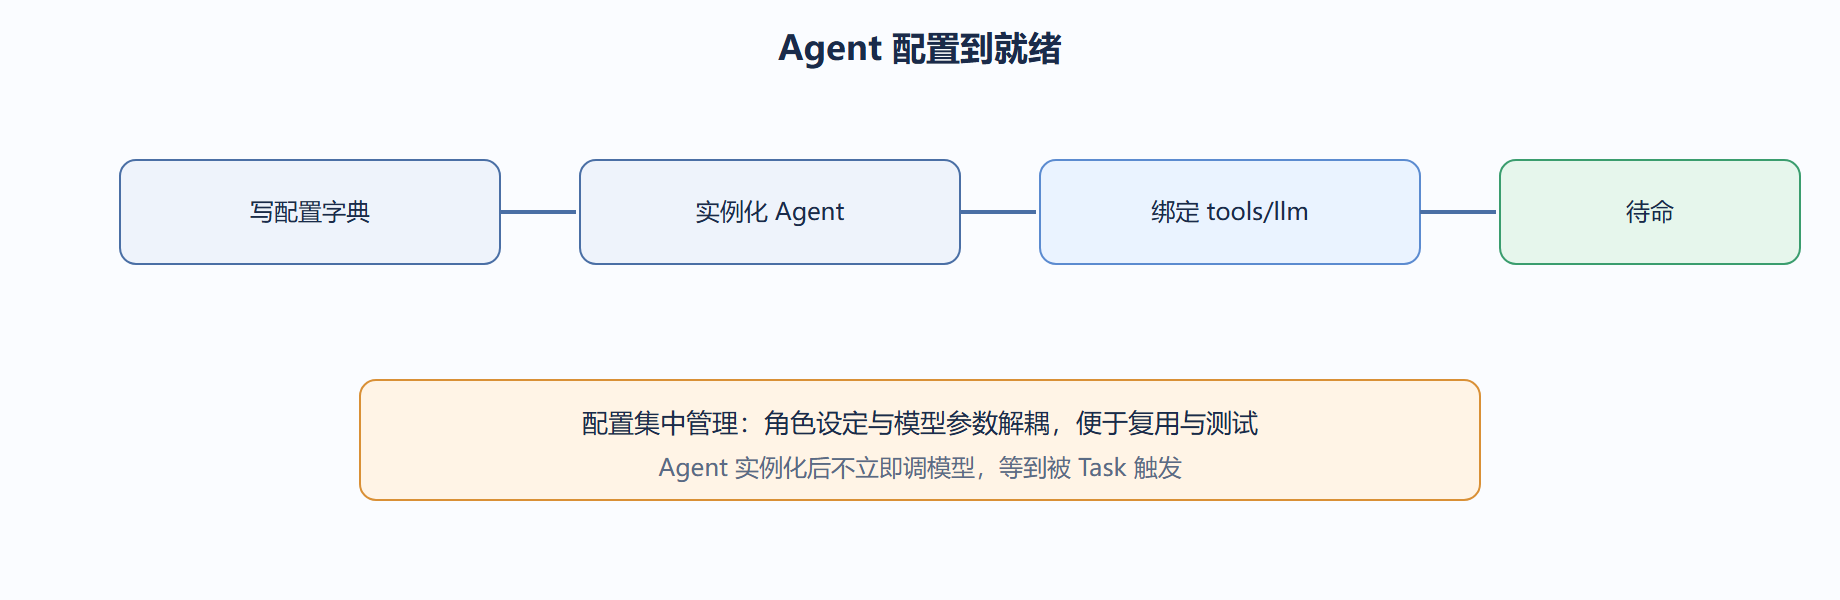
最基础的 Agent 定义,把所有常用字段一次列全,注释讲清每个字段的工程含义:
from crewai import Agent researcher = Agent( role="行业研究员", # 身份,影响系统提示开头 goal="搜集并核实目标赛道的关键事实", # 行为方向,比人设更影响决策 backstory="十年行研,习惯先证据后结论", # 只放风格与经验 tools=[], # 暂不给工具,需要时再挂 llm=None, # None 用全局默认模型 verbose=True, # 调试必开,看清思考链 allow_delegation=False, # 默认关委派,流程可预测 max_iter=15, # 单任务最大推理步数,防死循环 memory=False, # 单 Agent 记忆开关,第四章详述 )
max_iter 是个容易漏的保
max_iter 是个容易漏的保险:模型偶尔会在"调工具—看结果—再调"里打转,不设上限可能一直烧 token。我们一般给 10 到 20,够它把活干完又不会无限循环。
把配置抽成字典再实例化,是上规模项目的好习惯。这样多个相似角色能共享模板,差异只在 goal:
from crewai import Agent # 共享底座,避免每处重复写 backstory/verbose 等 BASE = dict( verbose=True, allow_delegation=False, max_iter=15, ) researcher = Agent(role="研究员", goal="找事实", backstory="严谨", **BASE) writer = Agent(role="写手", goal="成文", backstory="连贯", **BASE) checker = Agent(role="核查", goal="验出处", backstory="怀疑一切", **BASE) # 后续 Crew 直接引用这三个变量,配置集中、改动可追溯
这种写法在角色多时尤其省心:要全局调 max_iter 或统一关 verbose,只改 BASE。我们见过把 verbose 写死在十几个 Agent 里、上线想关日志却要改十处的项目,纯属自找麻烦。
再演示配置注入工具与模型——这是 Agent 真正"能办事"和"有强弱之分"的两步:
from crewai import LLM, Agent from crewai_tools import SerperDevTool search = SerperDevTool() strong_llm = LLM(model="openai/gpt-4o", temperature=0.3) # 研究员:要搜索、要强模型 researcher = Agent( role="研究员", goal="搜并核实事实", backstory="严谨", tools=[search], llm=strong_llm, verbose=True, ) # 摘要员:不需要搜索,用便宜模型压成本 cheap_llm = LLM(model="openai/gpt-4o-mini", temperature=0.1) summarizer = Agent( role="摘要员", goal="压缩文本", backstory="简洁", tools=[], llm=cheap_llm, verbose=True, )
这里体现了第二章提过的模型分级思路:把贵模型留给需要深度推理的角色,把便宜模型给机械性角色。整队账单能降一截,而质量不受影响——因为摘要本来就不考验推理深度。
一个收尾注意点:role 字段虽
一个收尾注意点:role 字段虽然是给人看的,但会进系统提示,影响模型自我定位。别写成"助手A""角色B"这种无意义串,也别写成一句话简历。一句清晰的身份("行业研究员")比一段模糊描述更有效。配置讲完,下一站我们把这些 Agent 用 Task 串起来。
从零配一个能用的 Agent
配置 Agent 的难点不在语法,而在"人设写多细"。我们遵循一条原则:人设只定风格与能力边界,具体验收标准留给 Task。下面给一个可直接跑的金融分析 Agent,带限速与工具:
from crewai import Agent from crewai_tools import SerperDevTool search = SerperDevTool() fund_analyst = Agent( role="基金研究员", goal="评估一只基金的性价比", backstory="只看公开披露与第三方数据,不臆测", tools=[search], allow_delegation=False, verbose=True, max_iter=20, max_retry_limit=2, ) print(fund_analyst.role, "就绪")
⚠️ 常见坑:backstory 写得太"全能",导致所有任务都被同一段话影响,反而降低可控性。我们让 backstory 只描述经验边界与禁忌,比如"不臆测未披露数据",而不是堆形容词。
再补一个用 LLM 字段指定模型的写法,方便按角色换模型、控成本:
from crewai import Agent from crewai.llm import LLM cheap_llm = LLM(model="gpt-4o-mini", temperature=0.3) draft_agent = Agent( role="初稿写手", goal="把要点扩成初稿", backstory="直白少修饰", llm=cheap_llm, # 简单活儿用便宜模型 verbose=True, ) print(draft_agent.llm.model)
💡 关键直觉:配置 Agent 像给演员说戏——说清"你是谁、你要什么、你的底线是什么",比说清"第一步怎么做"重要。具体步骤交给 Task,人设保持跨任务稳定,这样同一个 Agent 才能被多个 Task 复用而行为一致。
# 复用同一个 Agent 到不同 Task 完全没问题 t_a = type("T", (), {"description": "A", "expected_output": "a", "agent": draft_agent})() t_b = type("T", (), {"description": "B", "expected_output": "b", "agent": draft_agent})() assert t_a.agent is t_b.agent