4.4 可观测性与性能优化
4.4 可观测性与性能优化
本节约处在第四章第四站。多智能体一上量,"为什么这么慢、为什么这么贵、哪步出了问题"就会冒出来。可观测性不是锦上添花,而是它能不能长期运行的底线。我们主张:在写第一行生产代码时,就先把三类信号接出来——token、延迟、每步产出。
先把"该观测什么"画成一张信号清
先把"该观测什么"画成一张信号清单,避免只看最终 result:
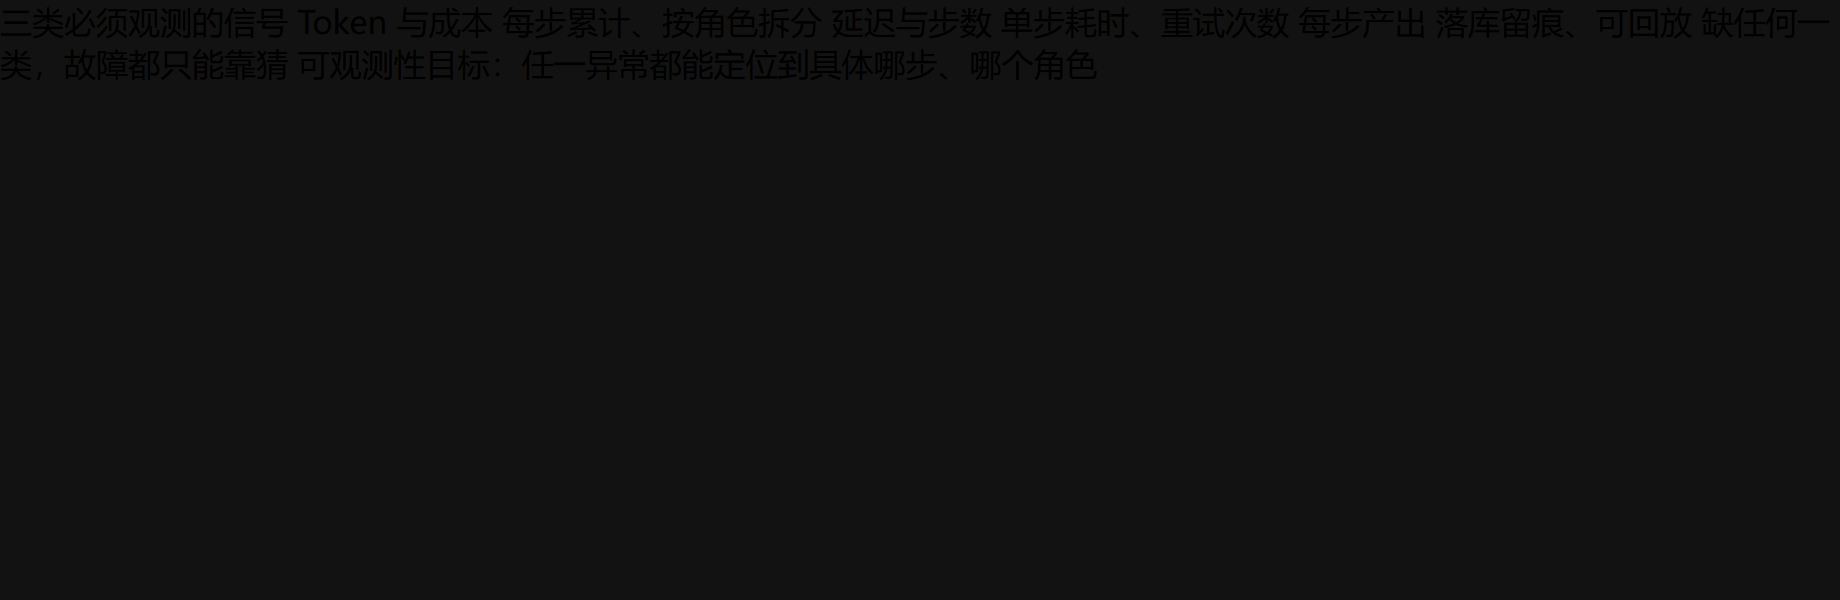
CrewAI 底层走 LiteLLM 调模型,因此可以挂 LiteLLM 的回调把每次 token 用量吐出来。下面用 step_callback 在每步结束时记录关键信息:
from crewai import Agent, Task, Crew, Process def step_logger(step_output): # step_output 含该步任务、角色与产出,可在此打点 task = getattr(step_output, "task", None) name = task.description[:20] if task else "?" print(f"[step] {name} 完成,产出长度 {len(str(step_output))}") researcher = Agent(role="研究员", goal="找事实", backstory="严谨", verbose=True) t = Task(description="搜 {topic} 要点", expected_output="三条要点", agent=researcher) crew = Crew( agents=[researcher], tasks=[t], process=Process.sequential, step_callback=step_logger, # 每步结束触发 verbose=True, ) # crew.kickoff(inputs={"topic": "储能"})
step_callback 让你
step_callback 让你在不侵入业务的情况下挂监控。我们建议生产里把它换成"写日志表/推指标系统",而不是 print——不然排障时只能盯着终端。
Token 与成本的细粒度统计,借助 LiteLLM 的回调更全。设置 LiteLLM 成功/失败回调,可把每次模型调用的 token、耗时、模型名都收到:
import litellm from crewai import Crew # LiteLLM 回调:把每次调用的用量推到你的指标后端 def on_success(payload): # payload 含 model / prompt_tokens / completion_tokens / latency print("模型", payload.get("model"), "输入", payload.get("prompt_tokens"), "输出", payload.get("completion_tokens")) litellm.success_callback = [on_success] # crew.kickoff(...) # 此后每次模型调用都会触发 on_success
有了这份数据,你能回答"这个 Crew 跑一次花多少 token、贵在哪个角色"。我们见过一个案例:全队成本八成落在"写手"的反复改写上,把它的模型从强降为中等、并把 expected_output 钉死,账单直接砍半——没有可观测数据根本发现不了。
性能优化的几个杠杆,按性价比排序:
- 降温度与降模型档位:多数角色不需要最强模型,分级配置(见 3.4)立省。
- 开
cache:相同输入的任务直接命中缓存,调试与重复运行省大量 token。 - 用
async_execution并行无依赖分支(见 2.4、3.2),压总延迟。 - 收紧
max_iter:防模型在工具调用里打转。 - 缩短
context:别把整段上游原文都喂给下游,先摘要再传,省输入 token。
最后讲一个反模式:为了"看得清"把所有角色 verbose=True 全开上生产。verbose 会打印大量思考文本,既拖速度又污染日志。正确做法:调试开 verbose,生产关掉、改用 step_callback 与 LiteLLM 回调拿结构化信号。
收尾提醒:可观测性的目标只有一句
收尾提醒:可观测性的目标只有一句——任一异常都能定位到"具体哪步、哪个角色、花了多少"。把三类信号接出来、结构化落库,你的多智能体才从"能跑的玩具"变成"能运维的服务"。下一站持久化,解决的是"跑一半崩了怎么办"。
让运行过程看得见、跑得省
可观测性靠 verbose 与日志;性能优化靠并发、模型分级、缓存。生产里我们至少做三件事:开 verbose 抓慢点、对独立任务用 async_execution、给轻活儿换便宜模型。
| 手段 | 解决什么 | 注意 |
|---|---|---|
| verbose=True | 看每步耗时与调用 | 生产关掉减噪 |
| async_execution | 独立任务并行 | 仅限无依赖任务 |
| 模型分级 | 降成本 | 重活别用太差的模型 |
| 结果缓存 | 重复查询不重算 | 对变化数据要失效 |
⚠️ 常见坑:async_execution 用在有 context 依赖的任务上不会真正并行,反而增加复杂度。只有彼此不依赖的任务才值得异步。另一个坑是 verbose 在生产全开,日志量爆仓——我们只在排查时开。
from crewai import Agent, Task, Crew, Process a = Agent(role="A", goal="g", backstory="b", verbose=False) t1 = Task(description="独立任务1", expected_output="o1", agent=a, async_execution=True) t2 = Task(description="独立任务2", expected_output="o2", agent=a, async_execution=True) crew = Crew(agents=[a], tasks=[t1, t2], process=Process.sequential, verbose=False) print("异步任务数:", sum(1 for t in crew.tasks if t.async_execution))
💡 关键直觉:可观测性不是"看热闹",而是给系统装仪表盘。没有仪表盘,你只能凭感觉调参;有了它,才能说清"是哪一步慢、哪一步贵、哪一步在空转",优化才有抓手。
# 简单计时包装,定位慢任务 import time start = time.time() # crew.kickoff() elapsed = time.time() - start print(f"本次 kickoff 耗时 {elapsed:.2f}s")