1.1 LangGraph 的诞生与核心理念
1.1 LangGraph 的诞生与核心理念
为什么链会撞上天花板
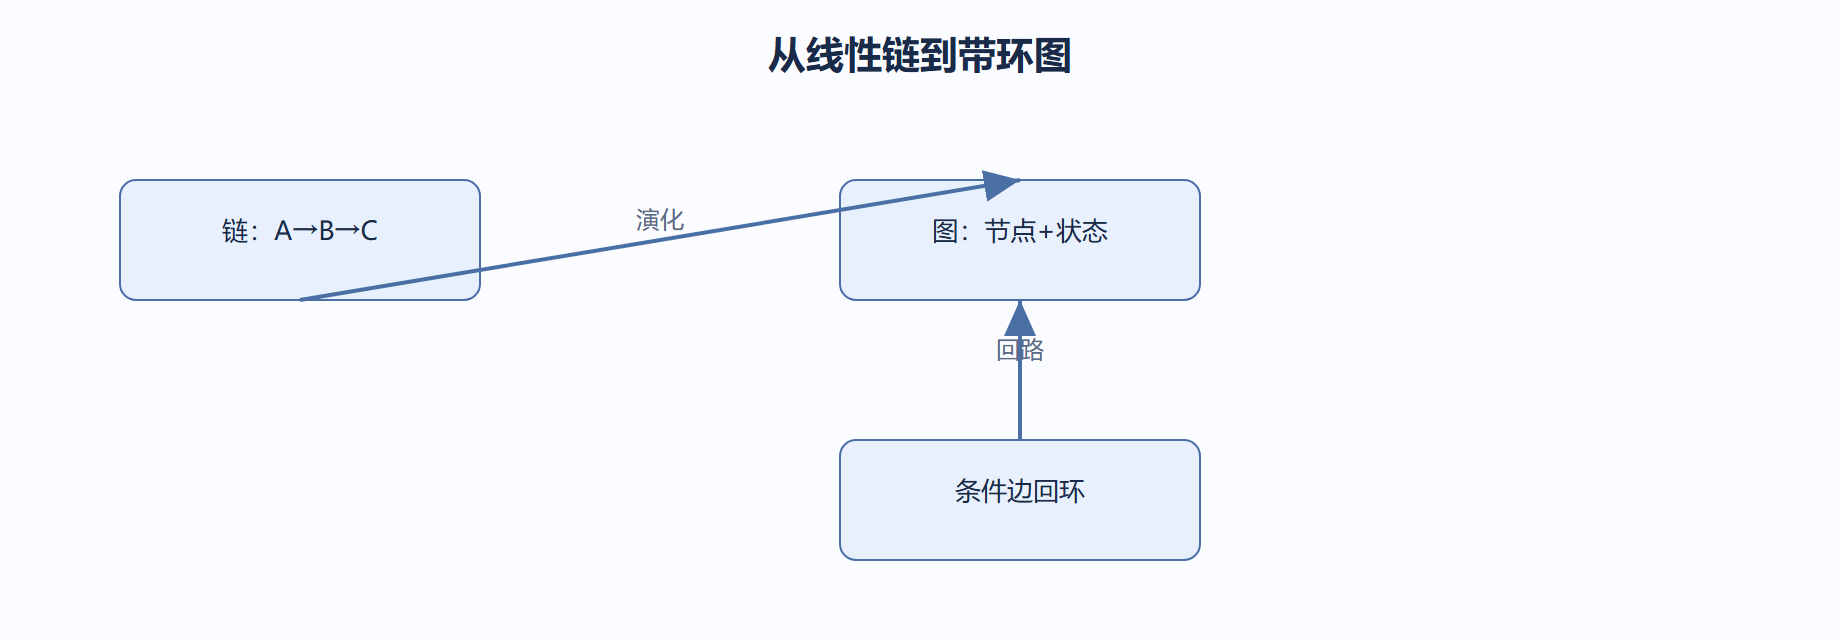
在体系里,本章负责建立心智模型。我们要回答一个反问:当模型需要「先想再做、做完再看结果、不对再重来」时,单向链为什么撑不住。链的每一步输入固定来自上一步输出,没有回路,也没有共享记忆。LangGraph 把执行路径建模成有向图,允许节点把结果写回一个共享状态,再由边决定下一步去哪——这就打开了循环与分支。我们写教程时反复强调这一点,因为多数人第一次用图,仍然习惯性把循环写进业务代码,图只负责线性执行,等于没用上图的核心能力。
核心理念:状态即记忆,图即流程
LangGraph 的设计前提是「让控制流显式可见」。状态(State)是跨节点共享的数据结构,节点(Node)是纯函数,接收状态、产出增量、由归约器合并;边(Edge)决定流转。这带来三个变化:第一,反思循环不再靠递归调用 hack,而是图里的一条回边;第二,长任务的中间结果有处存放,不必塞回 prompt;第三,中断与恢复成为一等公民,因为状态本就被外部存储。类比交通系统:链像单行道,图像带环岛与立交的路网,车辆(数据)在路口(条件边)按需换向。我们后面每一章都会回到这个区分。
# 最小可运行图:让节点在状态里累加计数,形成循环 from typing import TypedDict, Annotated import operator from langgraph.graph import StateGraph, START, END class S(TypedDict): count: Annotated[int, operator.add] # 节点:把当前计数加一,返回的是「增量」而非全量 def step(s: S): print(f"执行第 {s['count']} 次") return {"count": 1} def route(s: S): # 条件边:达到阈值就结束,否则回环 return END if s["count"] >= 3 else "step" b = StateGraph(S) b.add_node("step", step) b.add_edge(START, "step") b.add_conditional_edges("step", route) g = b.compile() print(g.invoke({"count": 0}))
# 这正是归约器语义写错时最典型的症状:循环跑完了,但状态没累积
案例:把「反思链」改造成「反思环」
背景:一个写作助手需要先生成、再自评、自评不过再改写,最多三轮。用链实现要手动嵌套调用,代码里到处是 while 与临时变量。
操作:用 StateGraph 建 draft 与 critique 两个节点,条件边在得分低于阈值时回到 draft,否则去 END。
结果:图自动在内部循环,外部只需一次 invoke,无需手写 while,主干逻辑从二十行缩到十行内。
解读:循环逻辑从业务代码下沉到图结构,可读性提升,且每轮状态可被检查点记录,事后能复盘每一版草稿。
变式:把阈值改成由另一个小模型动态给出,就得到自适应轮数的自我对弈式训练数据采集器,而图结构一行都不用改。
工程清单
-
循环不是靠递归调用硬写,而是图里的一条回边,状态负责在回路间传数据,业务代码里的 while 往往掩盖了退出条件。
-
归约器决定节点返回值如何并入全局状态,累加还是覆盖要想清再写,否则循环跑完状态却没累积。
-
最小可运行图也要带编译期校验,别等线上才暴露悬空边,编译报错比运行时炸图便宜一个数量级。
常见误区
新手常把循环条件写在业务代码里,图只负责线性执行,等于没用上图的核心能力。正确做法是把退出条件交给条件边,让图自己收敛,这样循环轮数、状态变化都可被检查点记录复盘。
心智模型迁移:从管道到状态机
理解 LangGraph,关键是放弃「数据在管道里流动」的画面,换成「状态在一张图上转移」。链式编排里,数据是主角,每个组件消费上一级的输出;图式编排里,状态是主角,节点只是改变状态的函数,边决定下一个改变者是谁。这个差异带来一个反直觉结论:同一张图,喂不同初始状态,会走出完全不同的执行路径。你在设计图的时候,实际上在设计一个状态转移函数,而不是在写一份执行清单。
这种心智模型与经典状态机一脉相承,LangGraph 只是把状态机搬进大模型应用的语境:状态对应 TypedDict,节点对应状态转移,条件边对应条件转移。区别在于节点内部可以调用大模型,让转移条件不再只是布尔判断,而可以是「模型认为该走了」。把图想成「模型参与判断的状态机」,很多设计选择——状态为什么必须可序列化、节点为什么写成纯函数——都能对号入座。
与其他编排方式的关系:不是替代,是换坐标系
在 LangGraph 之前,智能体编排大致有三条路:手写 while 循环的 ReAct 循环、面向数据流的链式管道、通用工作流引擎。LangGraph 与它们都不是替代关系:ReAct 循环是「图的一个特例」——固定两个节点来回跳;链是「没有回边的图」;工作流引擎强调定时与人工审批,LangGraph 强调与模型互动的实时判断。选型判断很直接:如果你的流程里有「由模型决定下一步去哪」,就用图;如果只是固定步骤串行,链或工作流更轻。
归约器为什么存在:合并策略而非类型标注
状态是共享的,多个节点可能先后写同一个键,谁说了算?归约器回答的正是这个问题。默认行为是覆盖(最后写入的生效);用 Annotated[list, operator.add] 标注字段后,节点返回的列表会被追加而非覆盖,「收集所有中间结果」变成声明式的一行。理解它的关键是把它当作「合并策略」而非类型标注。实践中九成状态 bug 出在这里——循环里想累积,却忘了加归约器,结果每轮覆盖上一轮,循环跑完状态只剩最后一轮的残影。
为什么检查点是核心理念而非附加功能
「中断与恢复是一等公民」的工程含义是:每次节点执行后,图的完整状态被序列化到外部存储(内存、SQLite、Postgres)。这意味着任意时刻杀掉进程,从检查点恢复就能接着跑,而不是从头生成。对一个可能跑几十步、每步都要调模型的智能体,这直接决定它能否上生产:没有检查点,长任务等于赌一次成功;有了检查点,长任务变成可中断、可续跑、可回放审计的普通工程对象。这一章先种下概念,第四章把它落实到代码。
读一张图的方法
回到开篇的计数图,它浓缩了全部原语:START 声明入口,节点 step 改变状态,条件边 route 返回「下一步去哪」,END 声明出口。读任何一张图按这个顺序:先看状态里有几个键、每个键的合并策略,再数节点与各自职责,最后沿条件边数出口。这个读图习惯是后续各章的基础,第二章会系统展开节点的执行前后。