3.1 使用 Builder API 构建图
3.1 使用 Builder API 构建图
第一行建图代码
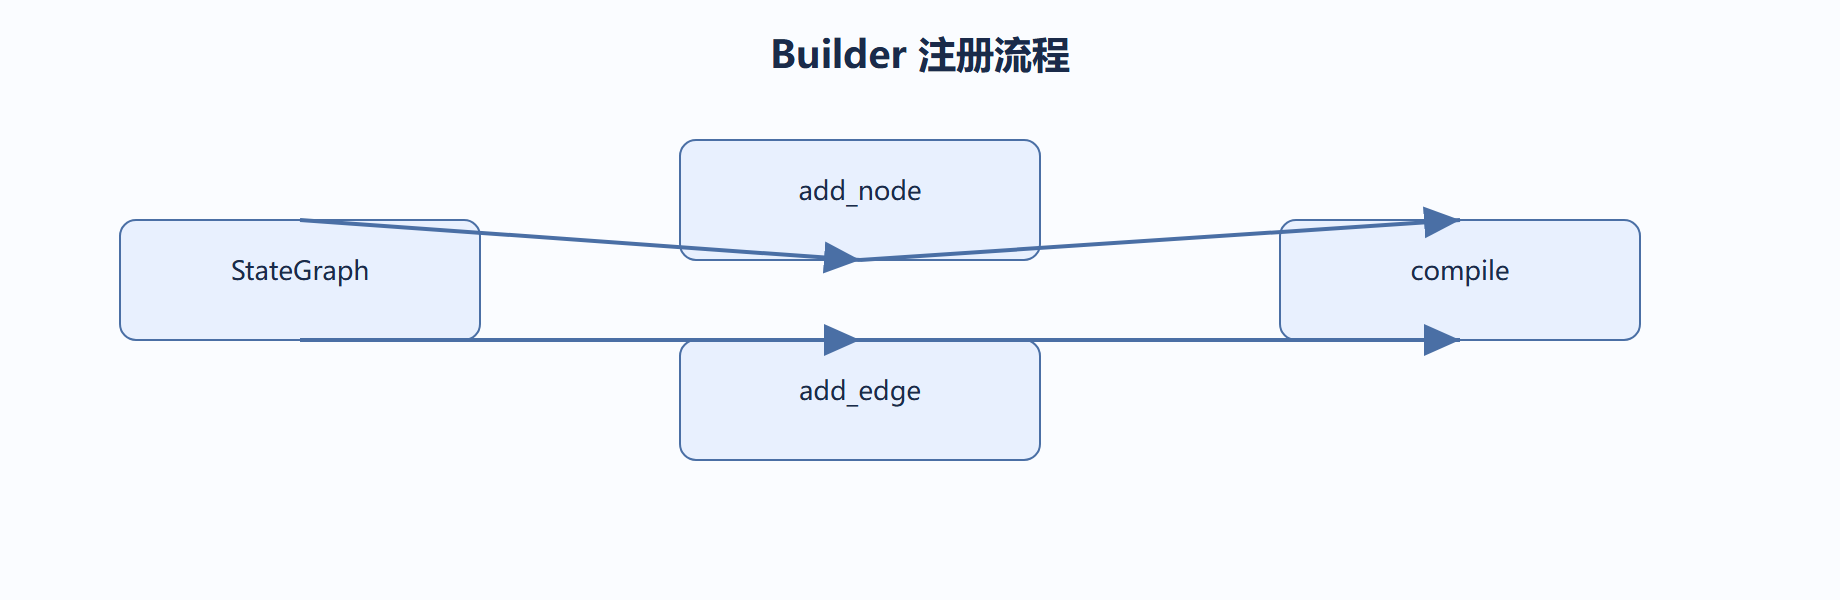
本节在全册位置:动手落地第二章概念。StateGraph 是构建入口,先传入状态类型,再 add_node 注册节点、add_edge 连边,最后 compile。所有「加」操作都发生在编译前。我们把这一步叫「画骨架」,骨架对了,后面填逻辑才顺。
Builder:声明式注册
StateGraph(S) 接收一个 TypedDict 或 Pydantic 模型作为状态 schema。add_node(name, fn) 注册;name 在条件边路由里被引用。add_edge 连固定边;add_conditional_edges 连条件边,第二个参数是路由函数,第三个可选映射把返回值对应到节点名。编译后才得到可 invoke 的图。类比游戏:Builder 像关卡编辑器,节点是方块,边是连线,compile 才生成可玩关卡。我们建议节点名用动词或角色名,别用 a/b/c,路由函数读起来才像人话。
from typing import TypedDict from langgraph.graph import StateGraph, START, END class S(TypedDict): x: int def inc(s: S): return {"x": s["x"] + 1} def twice(s: S): return {"x": s["x"] * 2} b = StateGraph(S) b.add_node("inc", inc) b.add_node("twice", twice) b.add_edge(START, "inc") b.add_edge("inc", "twice") b.add_edge("twice", END) g = b.compile() print(g.invoke({"x": 1})) # {'x': 4}
# 3.1 使用 Builder API 构建图 b.add_conditional_edges("inc", lambda s: "twice" if s["x"] > 1 else END) # 映射把路由返回值约束到已知节点,编译期就能发现拼错的名字
案例:流水线拼装
背景:数据清洗要「去重->标准化->校验」三步,纯线性,但步骤可能以后加分支。
操作:三个节点顺序 add_edge,编译后一次 invoke 跑完。
结果:三步共享状态 x,逐步变换,主干清晰。
解读:Builder 让流程可视化,新增步骤只加节点与边,不动已有逻辑。
变式:把校验改成条件边,校验失败回退到去重,得到自纠正流水线,图结构一处改动即可。
工程清单
-
StateGraph 先吃状态类型,再 add_node/add_edge,最后 compile,构建与编译是两阶段。
-
节点名在条件边路由里被引用,命名要有意义,别用 a/b/c,路由函数读起来才像人话。
-
编译后才得到可 invoke 的图,所有加操作都发生在编译前,别在 compile 之后才加节点。
常见误区
在 compile 之后才 add_node,运行时直接报错;我们把编译当成「图的单元测试」,每次改完都 compile 一次,把错误左移到本地。
add_node 的三种注册写法
节点本质上是一个可调用对象,add_node 对「怎么传这个对象」不挑剔,三种写法都能用:
def named_fn(s): # 写法一:具名函数,最好读、可复用、可测试 return {"x": s["x"] + 1} b.add_node("inc", named_fn) b.add_node("double", lambda s: {"x": s["x"] * 2}) # 写法二:lambda,简短 b.add_node("obj", CallableNode()) # 写法三:可调用对象
写法选择有两条经验:逻辑超过三行就别用 lambda,否则读代码时整个建图区会被表达式塞满;节点有内部状态或要复用配置时用可调用对象,把配置收在 init 里。注意节点名与函数对象是两回事:add_node 第一个参数是节点名,两个不同函数用同一个节点名注册时后注册的会静默覆盖前者,这也是「节点行为突然变了」的常见来源。
编译产物的常用方法
compile 返回的 CompiledGraph 是唯一的运行入口,先把它常用的方法和属性摸熟,后续章节全部基于它:
g = b.compile() g.invoke(input) # 跑完返回最终状态 g.stream(input, stream_mode=...) # 逐轮观察,调试与流式共用 g.get_graph().draw_mermaid() # 导出结构图 g.get_state(config) # 取最新检查点快照(需 checkpointer) g.get_state_history(config) # 遍历历史快照 g.update_state(config, values) # 手动改状态,测试时常用
编译产物是可序列化、可持久化的对象吗?准确说是「可反复调用」的运行器:同一张图可以被不同 thread_id 并发 invoke,互不干扰。理解了这一点,就明白为什么编译一次、运行多次是标准姿势——不要在每次请求时重新编译图,把编译放在进程启动时。
建图脚手架与命名惯例
建图是高频动作,把它做成一个固定模板能减少低级错误。我们内部统一用下面的顺序写每一张图:
# 1. 状态定义:通道与归约器成对出现 # 2. 节点函数:每个函数独立定义,不内嵌 # 3. 构建:add_node 全部注册完,再连边 # 4. 编译:一次 compile,进程内复用 # 5. 调用:invoke/stream 带着 config 跑
命名惯例上,节点名用「动词或角色名」:retrieve、grade、revise、human_gate,条件边返回值与节点名一致(pass/retry 对应节点名)。避免 n1、n2 这类编号,也避免直接用中文(路由字符串匹配时容易因全角半角差异翻车)。路由函数命名加前缀 route_ 或 judge_,一眼就能看出它是条件边的判断逻辑。
Builder 上的常见结构模式
建图时反复出现的结构只有有限的几种,识别它们能让 Builder 用法更快定型:
| 结构 | Builder 表达 | 一句话场景 |
|---|---|---|
| 直线流水线 | 连续 add_edge | 清洗、转换、生成 |
| 二分支 | 一个条件边 + 两个目标 | 达标/重试、通过/拒绝 |
| 循环 | 条件边回指自身 | 反思、检索再检索 |
| 扇形并行 | 条件边返回多个节点 | 同时开工多个任务 |
| 中心辐射 | 条件边 + 多条回边 | 主管-专家 |
每次新图先判断它属于哪种或哪几种的组合,再动手写 Builder,比边想边写更不容易漏边。改图时也一样:先定位结构,再改对应的边,不要把结构调整硬塞进节点内部 if——那等于放弃 Builder 的可视化红利。