3.5 动态图构建与修改
3.5 动态图构建与修改
运行期还能改图吗
本节在全册位置:图通常在编译期定型,但有些场景需在运行期增删节点或改边。LangGraph 通过子图与 Command 提供「准动态」能力:节点内决定激活哪条子流程,而非真的改全局图。我们强调:真改全局图几乎总是坏主意。
动态:子图 + Send 分发
真正的「重编译整图」成本高且破坏检查点连续性,因此推荐做法是预置好所有可能分支为子图,运行期用条件边/Command 选激活哪些。Send 可把不同任务发给同一节点的多个并行实例。这样「动态」落在路由层,图结构仍稳定、可校验。类比游戏:像开放世界按剧情解锁区域,区域本身早已做好。这个思路直接服务第五章的多智能体扇出。
from langgraph.graph import StateGraph, START, END, Send from typing import TypedDict class S(TypedDict): tasks: list def split(s: S): # 把每个任务用 Send 发给 worker 并行处理 return [Send("worker", {"task": t}) for t in s["tasks"]] def worker(s: S): return {"tasks": [s["task"] + "_done"]} b = StateGraph(S) b.add_node("worker", worker) b.add_conditional_edges(START, split, ["worker"]) b.add_edge("worker", END)
# 3.5 动态图构建与修改
案例:批量文档处理
背景:一次上传 N 篇文档,要各自摘要再汇总,串行太慢、写 N 个节点不现实。
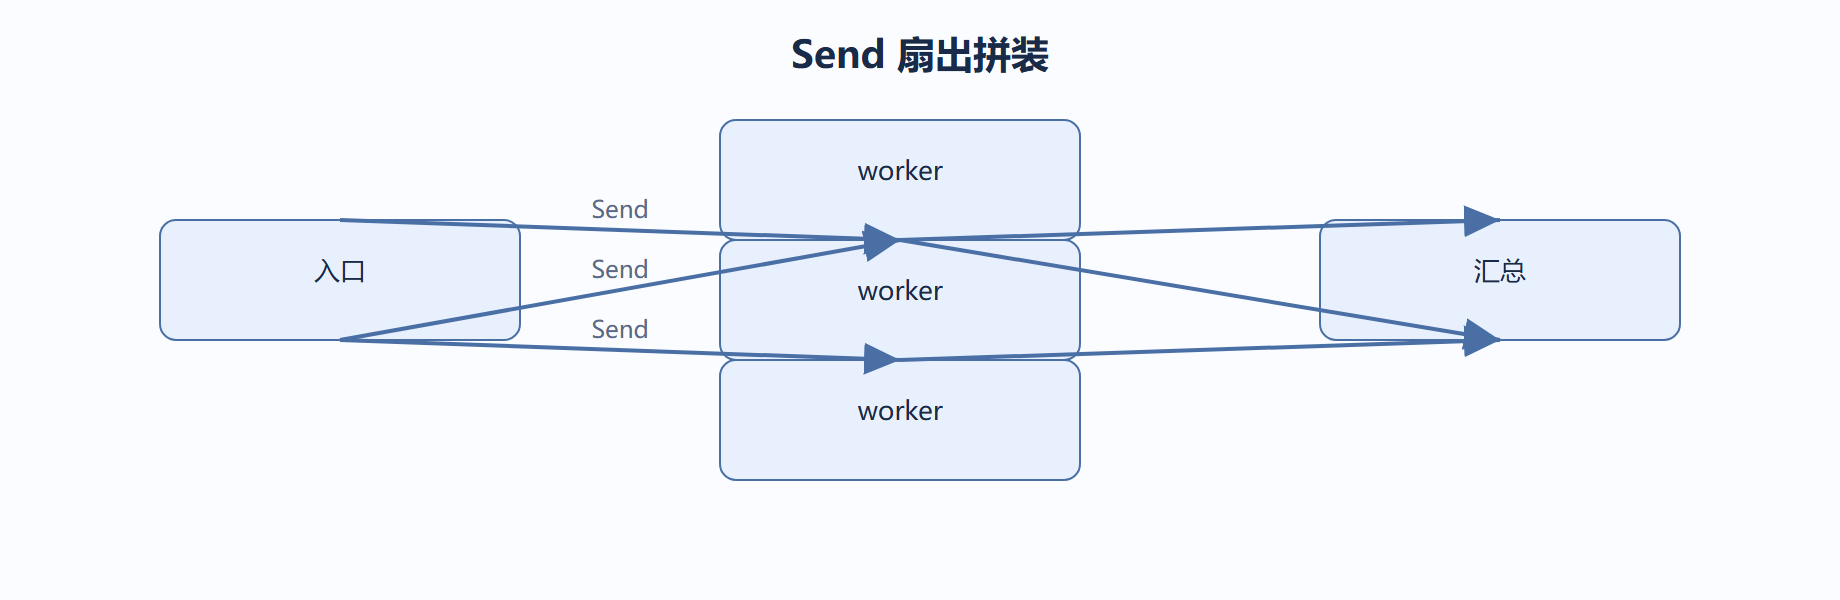
操作:入口用 Send 把每篇发给 worker 实例,汇总节点收齐后合并。
结果:N 篇并行处理,主图结构不变,加文档不用改图。
解读:用 Send 表达「数据驱动扇出」,比运行时改图更稳,检查点也连续。
变式:worker 本身可是一个子图(含检索-摘要-审校),实现两级拼装,复用 2.2 的子图思路。
工程清单
-
真正重编译整图成本高且破坏检查点连续性,几乎总是坏主意,用子图预置分支替代。
-
Send 让同一节点按数据扇出,是准动态拼装的常用手段,图结构仍稳定可校验。
-
动态落在路由层而非图结构层,检查点轨迹才能连续,回放才可靠。
常见误区
在运行期频繁 add_node 改全局图,检查点轨迹断裂、状态无法回放;正确做法是预置所有可能分支为子图,运行期用条件边选激活哪些。
Send 的完整签名与限制
Send 是「数据驱动扇出」的原语,用法比看起来更宽。它的签名是 Send(node_name, state),第二个参数是一个独立的片段状态,只传给目标节点的那次执行。
from langgraph.graph import Send # 每个元素独立发给 worker,各带自己的片段状态 def split(s): return [Send("worker", {"task": t, "seq": i}) for i, t in enumerate(s["tasks"])]
Send 有三个限制要提前知道:片段状态会覆盖目标节点读到的字段,但不会覆盖全局状态里其它通道;多个 Send 指向同一节点时,每个实例执行同一份代码、拿到各自的片段;Send 的目标必须是已注册节点,不能是条件边。它和 Command 的分工是:Command 表达「单一去向 + 状态更新」,Send 表达「一对多 + 各自片段」,两者在并发场景下互补。
收集节点与聚合等待
扇出之后的聚合是「Map-Reduce」的下半场,收集节点必须在所有分支完成后才执行。框架的保证来自边的语义:只要所有 worker 都连回同一个收集节点,收集节点就会等待全部就绪。
class S(TypedDict): tasks: list results: Annotated[list, operator.add] def worker(s): return {"results": [s["task"] + "_done"]} def collect(s): # 此时所有 worker 的结果都已并入 results return {"tasks": s["results"]} b = StateGraph(S) b.add_conditional_edges(START, split, ["worker"]) b.add_edge("worker", "collect") b.add_edge("collect", END)
聚合有两个注意点:results 必须用 operator.add 或类似归约器,否则多个 worker 并行写会冲突;如果 worker 本身有失败分支,要让失败结果也以「结果」的形式回到收集节点,否则收集节点会等不到部分分支而挂起。
子图嵌入与运行时重编译的取舍
「动态」有两种实现路线,成本和性质完全不同:
| 路线 | 做法 | 代价 | 适用 |
|---|---|---|---|
| 子图预置 | 把所有分支编译成子图,运行期选激活 | 编译一次,结构稳定 | 分支有限且已知 |
| 运行时重编译 | 按数据动态 add 节点和边 | 每次重编译、检查点断裂 | 几乎不推荐 |
第二条路线的坑很具体:重编译出的新图与旧图不在同一个检查点命名空间,已有 thread 的历史轨迹对不上,回放直接失效。如果你确实面临「分支数量不可预知」,先停下来问一句:分支真的不可预知,还是没找到把它们归纳成参数的方法。绝大多数情况是把「分支枚举」转成「分支参数」,用子图加状态字段解决,而不是动态改图。
两级拼装:子图套子图
把子图当作可复用的积木,可以再套一层:worker 本身可以是一个编译好的子图,里面再含检索、摘要、审校等节点。
# worker 子图:检索 -> 摘要 -> 审校 worker_graph = build_worker_graph().compile() # 主图把 worker 子图当节点 b.add_node("worker", worker_graph) # 子图即节点 b.add_conditional_edges(START, split, ["worker"])
两级拼装的好处是每层都能独立测试与替换:想升级摘要逻辑,只改 worker 子图内部,主图结构纹丝不动。这也是第五章多智能体「每个专家是一个子图」的底子,现在把这种能力练熟,后面直接复用。