4.1 状态对象的结构与设计
4.1 状态对象的结构与设计
状态该怎么设计
本节在全册位置:状态结构决定后面一切。用 TypedDict 最轻,字段配 Annotated 指定归约器;用 Pydantic 模型可获得校验与默认值。设计原则是:只放「需要跨节点存活」的数据,临时变量留在节点局部。我们反复提醒:状态不是你的笔记本,别什么都往里塞。
设计:通道与归约成对出现
每个状态字段是一条通道,必须想清归约语义:覆盖(默认)、累加(operator.add)、消息合并(add_messages)、自定义。消息类状态用 MessagesState 预置 msgs 通道最省事。避免把大对象塞进状态——序列化与检查点成本会上升。类比生物:状态像细胞质,只存跨器官传递的信号,瞬时代谢产物留在局部。状态设计好,第四章后面三节都顺。
from typing import TypedDict, Annotated import operator from langchain_core.messages import add_messages # 轻量 TypedDict 状态 class S(TypedDict): msgs: Annotated[list, add_messages] scratch: str # 覆盖式:只留最新 steps: Annotated[list, operator.add] # 累加式:留全部 # 等价地用 Pydantic(带校验) from pydantic import BaseModel class P(BaseModel): msgs: Annotated[list, add_messages] steps: list = [] # 通道与归约成对出现,设计状态先列清每条通道语义
# 反例:把整份文档当状态字段,检查点体积爆炸 def bad(s): return {"big_doc": load_huge_file()} # 每步都序列化的代价 # 正例:只存文档 id,用时再取 def good(s): return {"doc_id": s["doc_id"]} # 状态轻,检查点小 # 这条纪律在长任务里决定成本
案例:对话状态取舍
背景:客服机器人要记住历史,又要记当前意图,两者更新频率不同。
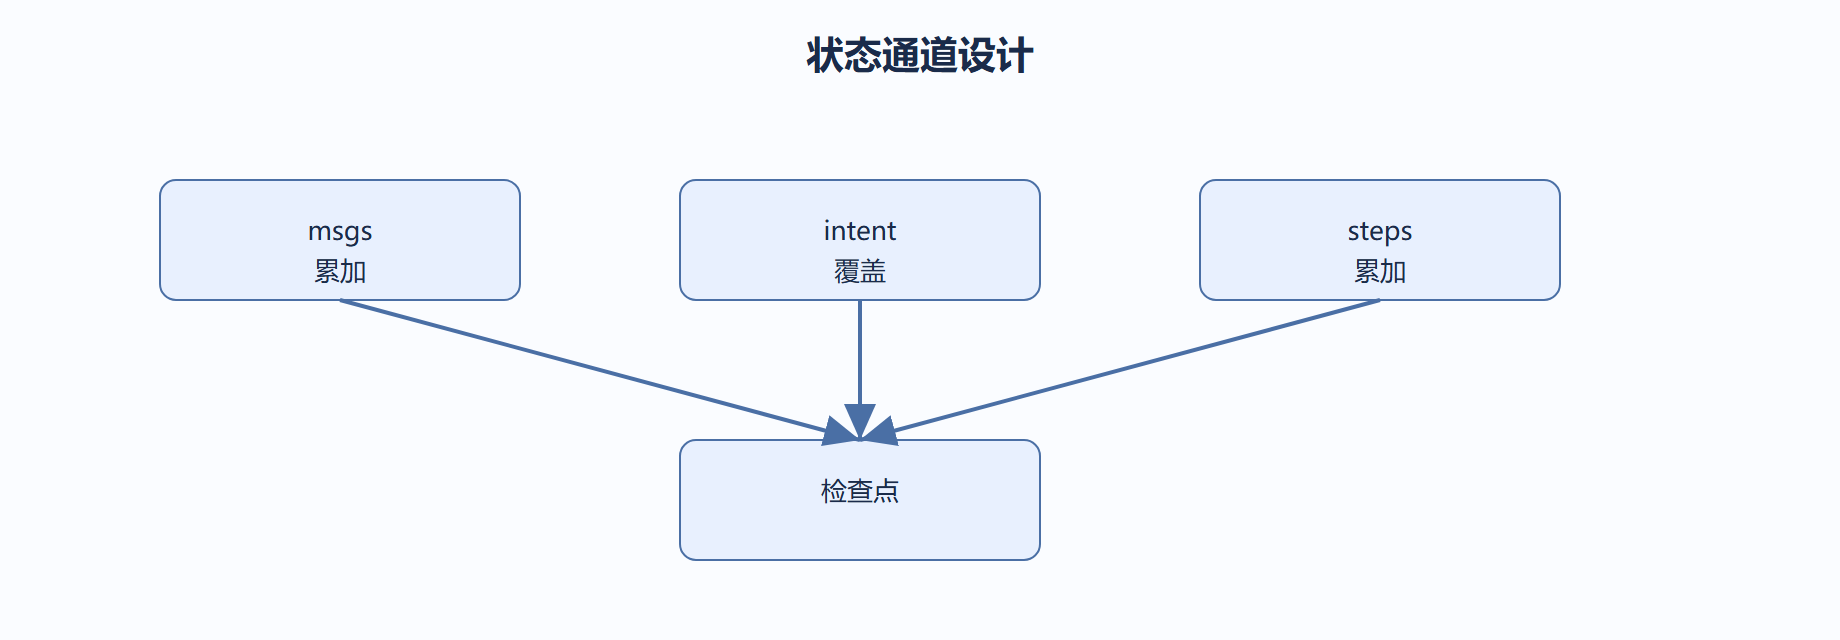
操作:msgs 用 add_messages 留历史,intent 用覆盖式存当前意图。
结果:历史不丢、意图常新,检查点体积可控。
解读:覆盖与累加通道分工,是状态设计的基本功,别用一套通道硬扛所有语义。
变式:intent 也可改成累加列表,做意图演变轨迹分析,归约器一换能力就变。
工程清单
-
只放需要跨节点存活的数据,临时变量留在节点局部,状态不是你的笔记本。
-
消息类状态用 MessagesState 预置 msgs 通道最省事,覆盖与累加通道分工是基本功。
-
避免把大对象塞进状态,序列化与检查点成本会随对象体积线性上升。
常见误区
把整份文档、模型实例塞进状态,检查点体积爆炸且序列化失败;状态只存 id 与参数,用时再取,这条纪律在长任务里直接决定成本。
TypedDict 与 Pydantic 状态的选择
两种状态写法在第四章是常客,选择标准要看项目对「校验」的需求:
| 维度 | TypedDict | Pydantic |
|---|---|---|
| 定义成本 | 低,纯标准库 | 中,需要 pydantic 依赖 |
| 默认值 | 不支持 | 支持,字段可带默认 |
| 实例化校验 | 无 | 有,类型错误当场报 |
| 嵌套结构 | 难表达 | 原生支持 |
| 与归约器组合 | Annotated 正常用 | 同样支持 |
选型建议:状态字段少、都是基础类型、团队赶原型,用 TypedDict 足够;出现可选字段、默认值、嵌套模型或要对外提供强约束契约时,切 Pydantic。值得强调的是,两种写法下归约器的用法完全一致,切换的迁移成本只在字段定义本身,不需要动节点代码。
预置的 MessagesState 与其扩展
消息类任务不用手写状态,直接用 MessagesState 最省事。它预置了一条 msgs 通道,用 add_messages 归约,还带一个 messages 便捷别名。
from langgraph.graph import MessagesState class ChatState(MessagesState): # 在消息基础上追加自己的业务字段 intent: str user_id: str def respond(s: ChatState): # s["messages"] 就是消息列表,已按 add_messages 合并 return {"intent": "chat", "messages": [model.invoke(s["messages"])]}
继承扩展是常用姿势:消息历史用预置通道,业务字段自己加。唯一要记住的坑是别重新定义 messages 通道覆盖默认归约,否则多轮去重行为会悄悄变化。
状态字段审查清单
设计完状态后,用这份清单逐条过一遍,能拦住大部分返工:
- 每个字段是否真的有多个节点读写,还是只在单个节点内使用。
- 单节点内部使用的值,是否已经泄漏到状态里变成垃圾字段。
- 多节点写且语义是「追加」的字段,是否配了累加或消息归约器。
- 有没有把文件句柄、连接、模型实例这类活资源放进来。
- 大文本(整篇文档、长回复)是否可以用 id 或摘要替代。
- 字段名是否自解释,新同事不看注释能不能猜出语义。
清单每过一遍都是对「状态是共享内存」这个原则的再确认:状态里每多一个字段,检查点就重一点、并发冲突面就大一点,删字段比加字段难得多。
扁平字段与嵌套结构的取舍
状态的形态有两条路线:扁平(每条数据一个顶层字段)与嵌套(一个字段装一个对象)。LangGraph 的通道归约作用在顶层字段上,这个机制决定了取舍方向:
# 扁平:每条通道独立归约,可各自配归约器 class FlatS(TypedDict): step: Annotated[int, operator.add] draft: str score: int # 嵌套:整个 profile 作为一个字段,内部更新只能整体覆盖 class NestedS(TypedDict): profile: dict # 内部小字段变化也会整体重写 step: Annotated[int, operator.add]
扁平状态让「每类数据各自定归约语义」,但字段多了状态面变大;嵌套状态结构紧凑,但子字段无法单独归约,任何小改动都触发整体覆盖。实践结论:把「要分别归约的数据」平铺开,把「整体语义的一组数据」收进一个字段。两者结合使用是常态,别追求单一形态。
Pydantic 状态还有个额外好处:嵌套字段可以用模型定义,检查点序列化时结构更稳,反序列化后能直接拿到类型正确的对象,省去手写 dict 到对象的转换。